Type 2 · Promising method Requested 证据 B 收录
Hybrid Particle-Voxel Dynamics for Multimodal 3D World Simulation
发布 · 收录于 2026-11-04
把动作条件世界模型从“预测下一帧图像”改成“预测下一帧 3D 体素潜变量”,就能同时得到多视角一致的渲染、点云和对齐的触觉,并可用于造数据、评测策略和做规划。
- 任务
- 动作条件世界模型(双臂桌面操作)
- 数据
- 自采 ALOHA 六任务(每任务约 200 条、2 小时)+ Deform360
- 硬件
- ALOHA 双臂 + FlexiTac 指尖触觉 + 5 台 RealSense
- 代码
- 有项目主页,文中未说明是否开源代码
- 主要数字
- ALOHA 上 PSNR 23.24,最强基线 20.59
证据等级 B · 仿真充分 (A 真机 + 多基准 + 消融 / B 仿真充分 / C 单一基准或无代码)
动机
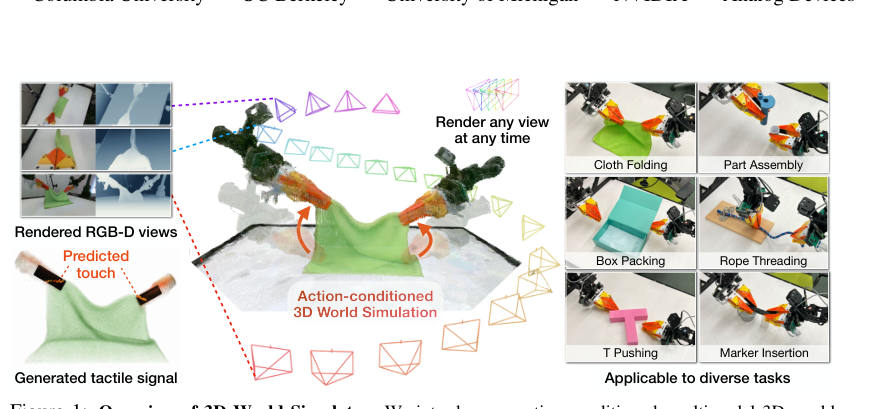
问题:机器人想“在脑子里试一试”动作会带来什么结果,需要世界模型(world model,给定当前状态和动作、预测下一刻世界的模型)。它可以用来造训练数据、评测策略、做规划。
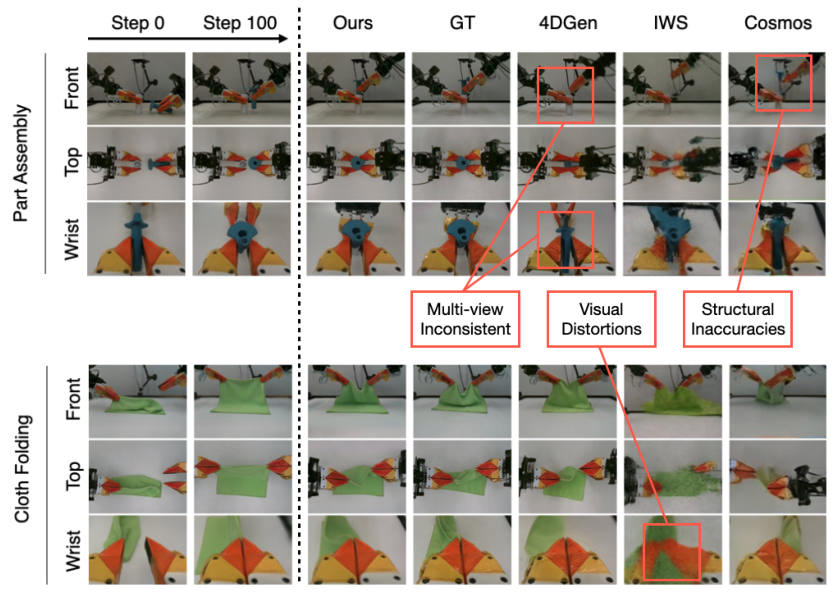
现有方法卡在哪: - 主流做法用 2D 视频生成模型,画面逼真,但心里没有 3D 场景。换个视角就对不上,长时间滚动后物体和机械臂会变形(→ P.2)。 - 3D 粒子类方法(如 PointWorld、PGND)几何一致,但训练要靠点跟踪(point tracking)提供监督,也不擅长渲染逼真图像,而视觉策略恰恰需要图像(→ P.3)。 - 触觉通常被当成另一张 2D 图来预测,和接触位置在空间上不对齐(→ P.3)。
为什么难:要在一个模型里同时管外观、几何和触觉,还要几百步开环滚动不崩。
方法
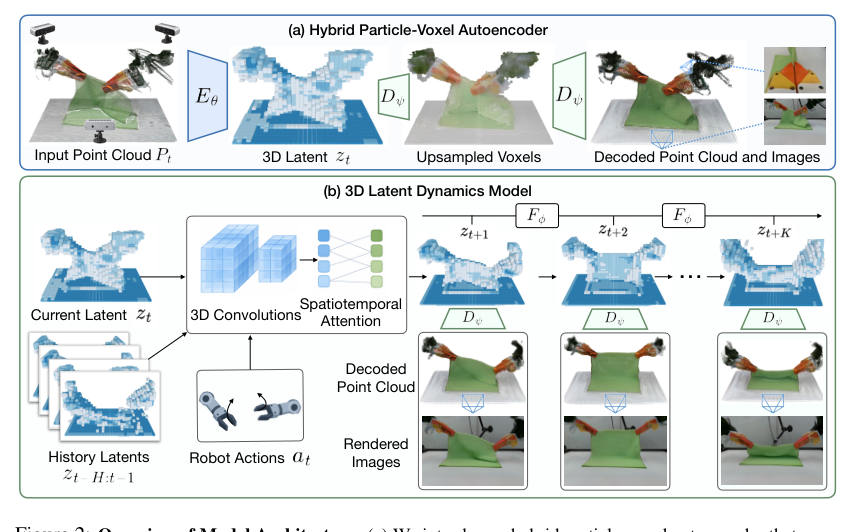
- 1点云输入多相机 RGB-D 和触觉合成一个点云
- 2压缩稀疏 3D 卷积压成粗体素潜变量
- 3预测3D U-Net+时空注意力按动作推下一帧
- 4解码体素逐级细化成带高斯参数的粒子
- 5输出任意视角 RGB-D、点云、触觉信号
比喻:把整个桌面场景存成一块粗糙的 3D 乐高积木板,每格只记 8 个数。模型不去猜下一张照片长什么样,而是猜“下一刻这块积木板会变成什么样”,需要照片时再从积木板“画”出来。因为画面都来自同一块积木板,从哪个角度看都对得上。
模块 1:粒子-体素自编码器(autoencoder,把数据压缩再还原的网络)(→ P.4) - 编码:把点云放进稀疏 3D 网格,只在有东西的格子上做卷积,压成 32×16×32×8 的潜变量(→ P.17 表 3)。 - 解码:先逐级放大体素并预测每格是否被占据,再用小 MLP 在每个占据格里生成连续位置的粒子。每个粒子带一个 3D 高斯(3D Gaussian Splatting,一种用大量彩色椭球渲染图像的方法)的颜色、大小、方向和透明度,所以能从任意视角渲染。触觉信号也作为粒子放在同一空间里,天然贴在接触面上。 - 训练损失四项:占据、粒子位置(Chamfer 距离,即两团点互相找最近点的平均距离)、渲染图像与深度、以及“同一场景两次不同降采样编码结果要一致”的正则(→ P.4-5)。
模块 2:3D 潜空间动力学模型(→ P.5, P.18) - 输入当前和过去 5 帧潜变量加机器人动作,用 3D U-Net 下采样到 8×4×8 的粗网格,在上面交替做空间注意力和因果时间注意力,再放大回去,一次前向输出一帧。 - 为了长时滚动稳定:训练时自回归(autoregressive,用自己的预测当下一步输入)连续预测 K 步,误差按 γ=0.95 逐步打折相加,K 逐渐加大;并给历史帧加随机噪声,让模型习惯自己的误差。
组合:可以把输出和静态背景高斯、运动学机械臂模型拼在一起,换背景或换没见过的机械臂(→ P.5)。
实验
本文方法 对比方法 · 数据来源:Table 1, P.8
本文方法 对比方法 · 数据来源:Table 1, P.8
本文方法 对比方法 · 数据来源:Table 2, P.16
数据:ALOHA 双臂上六个任务(零件装配、叠布、推 T 形块、装箱、穿绳、插笔),覆盖刚体、铰接和柔性物体;另用大规模 Deform360(198 个物体、1,980 段交互、215 小时,41 台环绕相机)测扩展性(→ P.7)。
指标(200 步开环滚动的平均):PSNR 越高越好、LPIPS 越低越好(图像);Abs Rel 越低越好、δ<1.25 越高越好(深度);CD 越低越好(几何);触觉 L1 越低越好(→ P.7-8)。
对比:2D 视频模型 Cosmos、Robot4DGen、IWS;3D 粒子模型 PGND、PointWorld、ParticleFormer。
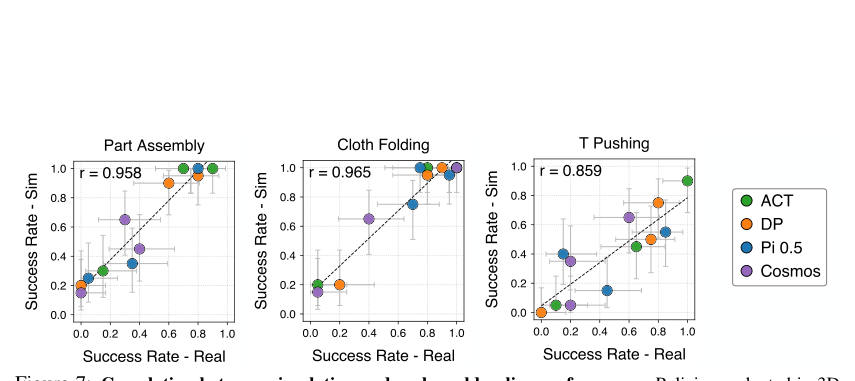
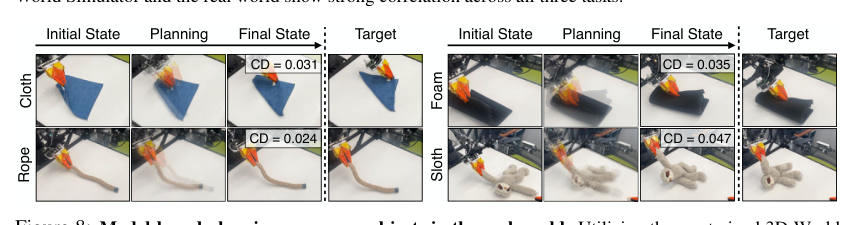
结果: - ALOHA 上七项指标全部最好,例如 PSNR 23.24 对 20.59、场景 CD 7.72 对 10.43、触觉 L1 0.081 对 0.128(→ P.8 表 1)。 - Deform360 训练过的物体上图像和几何都最好;没见过的物体上几何仍最好(CD 12.1 mm 对 13.4 mm),但画质不如 ParticleFormer(PSNR 14.8 对 15.6),作者解释为基线是在预先拟合好的高斯上搬运点,而本文从零生成外观(→ P.8, P.16 表 2)。 - 造数据:四种策略(ACT、Diffusion Policy、π0.5、Cosmos Policy)各用 100 条真实或模型生成的示教训练,再上真机测。从图上看,纯模型数据在叠布上与真实数据持平,在带触觉装配和新视角推 T 上略低;带触觉的模型数据明显好于不带触觉的真实数据(→ P.9 图 6)。 - 评测:每任务 20 个初始状态,模型内成功率与真机成功率的相关系数为 0.958、0.965、0.859(→ P.9 图 7)。 - 规划:用 Deform360 预训练模型加 MPPI(一种采样式模型预测控制),在没见过的单臂和四个没见过的物体上零样本完成整形,最终 CD 0.024-0.047(→ P.9 图 8)。
代价:推理 50 Hz;自编码器和动力学模型各在一张 RTX 5090 上训练约 16 小时(→ P.1, P.5)。
站得住的:对 2D 视频基线的多视角一致性优势,有定量和图例双重支持。要打折的:没有消融;策略实验每点只有 20 次试验,置信区间较宽。
要点 Take-home
- 在 3D 体素潜空间里预测动作后果,比在像素里预测更能保持多视角一致。
- ALOHA 六任务 200 步开环预测,图像、深度、几何、触觉指标都优于各基线。
- 在模型里评测策略,成功率与真机高度相关,可当作廉价评测场。
- 对没见过的物体,几何仍领先但画质不如粒子基线;场景只限桌面。
Claude 读完全文后的提炼。
更多:先读哪 · 值得看的理由 · 质疑
先读哪
先看第 1 页图 1 和第 4 页图 2,再看第 8 页表 1 和第 9 页图 7
值得看的理由
- 世界状态放在 3D 体素潜空间,多视角一致和触觉对齐由结构保证;ALOHA 六任务上全部指标优于 2D 视频与 3D 粒子基线 → P.8 表 1
- 用它生成的数据训练策略、在它里面评测策略都接近真机结果,三个任务相关系数 0.86-0.97 → P.9 图 7
质疑
- 全文没有消融:一致性损失、历史噪声、课程训练、粒子上采样各自贡献多少都未验证;粒子基线由作者用 CoTracker 轨迹自行训练 → P.23 Appendix C.3;正文第 4 节无消融
审稿人笔记
工作空间被限定在约半米见方的盒子内(P.17 表 3),离房间级导航和移动操作还远,作者也把它列为后续工作。