Type 2 · Promising method 证据 A 收录
Perceptive Humanoid Motion from Simulation
发布 · 收录于 2026-11-06
仿真可以当作人形机器人的数据引擎:不用遥操作、不扫描部署环境,合成的视觉-语言-动作数据就能让机器人在陌生真实家庭里完成全身技能。
- 任务
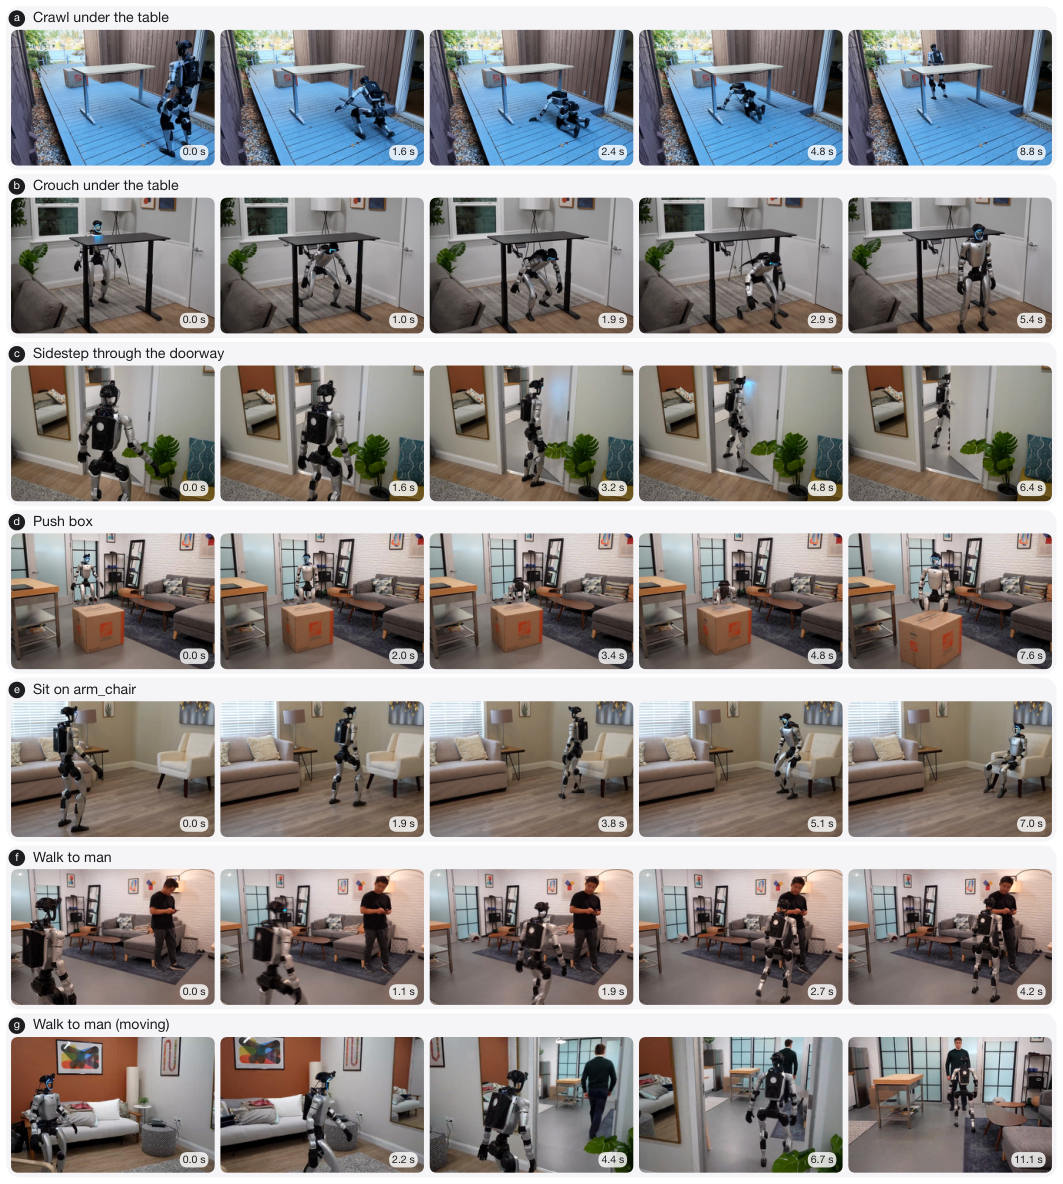
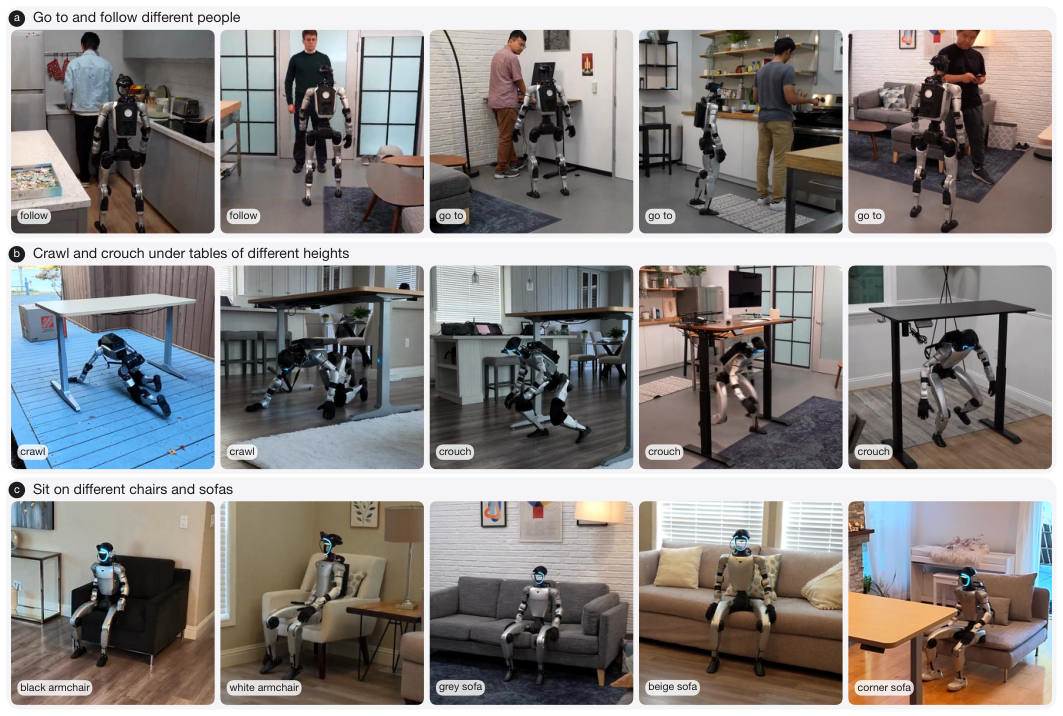
- 人形全身技能:走到物体、坐下、侧身过门、蹲/爬过桌下、推箱,及其多步组合
- 数据
- 1,000 个 Infinigen 程序生成房间,162,698 段、296.3 小时合成数据
- 硬件
- Unitree G1 + 头部鱼眼 RGB + RealSense 深度,Mac mini M4 Pro 与 Jetson Orin NX 全部机载
- 代码
- 项目页称提供代码和视频
- 主结果
- 真实 6 环境 360 次单任务成功率 91%,多步任务约 70%
证据等级 A · 真机 + 多基准 + 消融 (A 真机 + 多基准 + 消融 / B 仿真充分 / C 单一基准或无代码)
动机
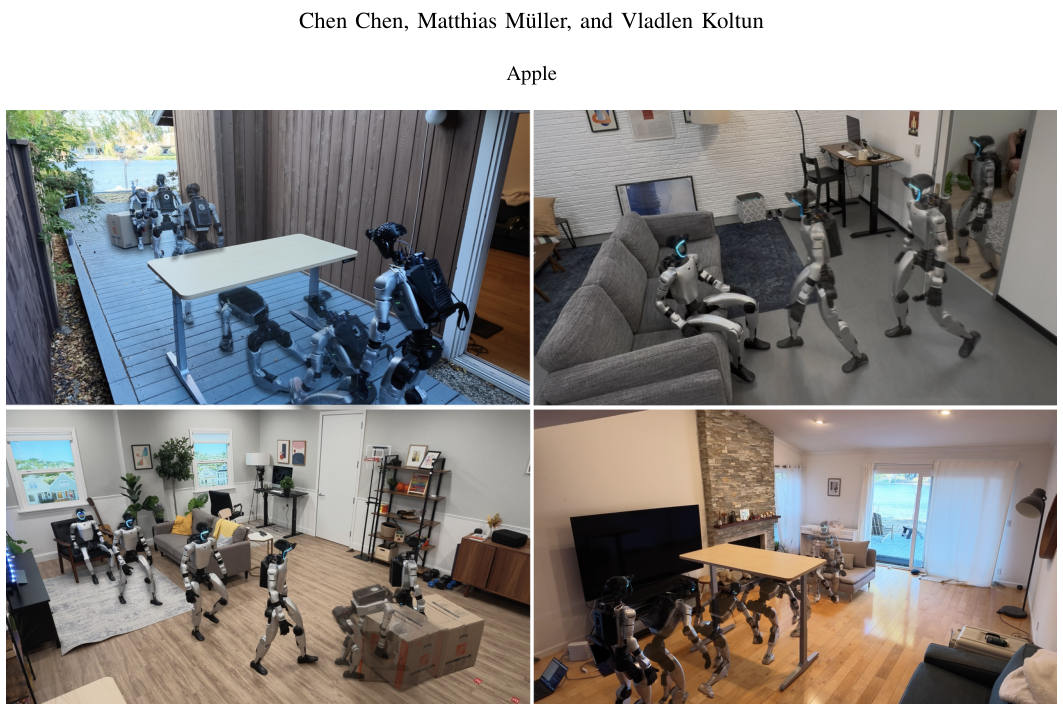
人形机器人能翻跟头、跳舞,但让它走进一间陌生客厅找到椅子坐下却很难。翻跟头只需一段参考动作和一个跟踪器;而“看图+听指令→全身关节动作”需要成对的监督数据:第一视角图像、指令、以及对应的全身轨迹。
现有做法靠遥操作(teleoperation,人远程操控机器人录数据)或穿戴式采集设备,一小时数据至少要一小时人力(P.2)。另一些系统先扫描部署房间再在里面训练(如 VLK),换个没扫过的房间就不成立(P.3-4)。此外,能跟随任意参考动作的通用跟踪器大多是“盲”的,只看本体感受,环境和计划稍有偏差就会出错(P.3-4)。
本文想回答:能否让数据量只受算力限制,而不受人力限制?
方法
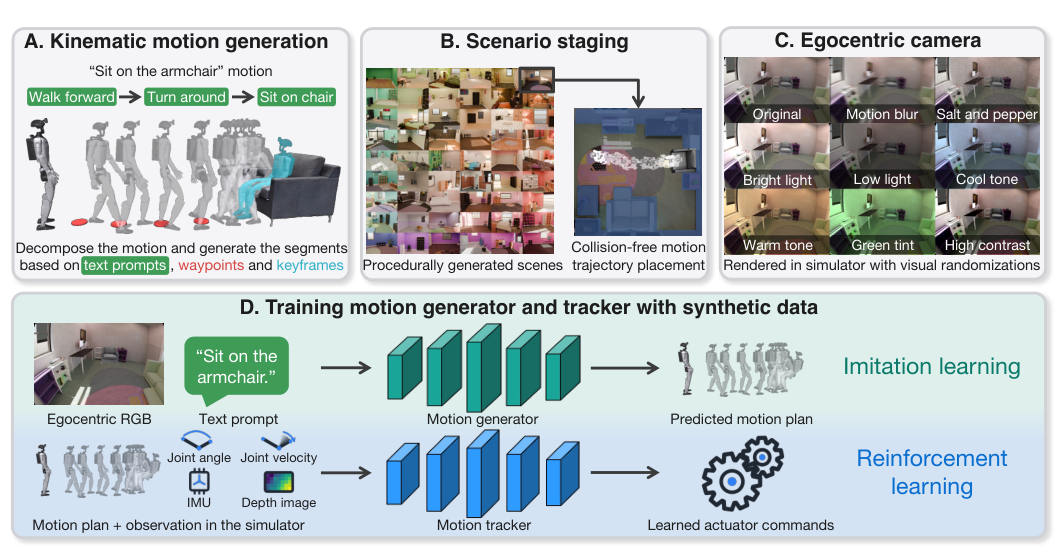
- 1造数据程序生成房间,扩散模型合成全身动作
- 2渲染烘焙光照,按机载鱼眼相机渲染第一视角
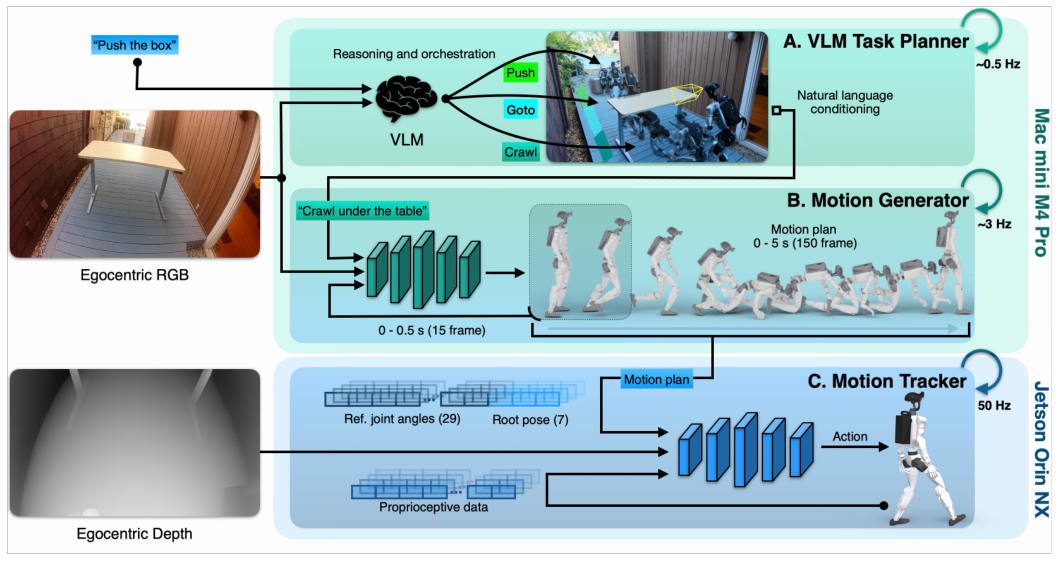
- 3拆任务VLM 把指令拆成子任务(约 0.5 Hz)
- 4出动作看图+子任务,生成 5 秒全身动作(3 Hz)
- 5跟踪深度+本体感受,50 Hz 输出关节目标
比喻:像拍电影。导演(VLM 编排器)把“先钻过桌子再坐椅子”拆成几场戏;编舞(运动生成器)看着眼前画面,为当前这场戏设计接下来 5 秒的全身动作;替身演员(运动跟踪器)真正去做,并用深度相机随时修正脚下和身边的偏差。
1. 仿真数据管线(P.4、P.10-11):每个技能先由人写一次分段脚本,如“坐扶手椅”= 向前走 → 转身 → 坐下。KIMODO(一个按文字和关键帧生成人体动作的扩散模型)生成每段动作,再用正运动学检查脚打滑、穿地、腾空、关节越界,只保留得分高的候选。动作被放进 Infinigen 生成的房间里,避开家具;房间光照预先“烘焙”进贴图,这样任何普通渲染器都能快速出图,再加曝光、色温、运动模糊、噪声等随机化。
2. 运动生成器(P.4-5、P.12):前端是冻结的 Qwen3.5-2B 视觉语言模型,读入图像和指令;后端是从头训练的 DiT(diffusion transformer,用 Transformer 做去噪的生成网络),用 flow matching(从随机噪声一步步“推”成干净轨迹的生成方法)输出 150 帧 × 36 维(29 个关节角 + 骨盆位姿)。可训练参数只有 49.3M。关键技巧:机器人边执行旧计划边算新计划,新计划的前 15 帧(0.5 秒)直接用“已经承诺要执行”的帧作为干净输入,模型只生成后面 135 帧。训练时就学会“接着前缀往下写”,所以新旧计划衔接不跳变。
3. 感知型跟踪器(P.6、P.13-15):分三步训练。先为每类技能训练能看到真实地形高度图的“特权专家”(PPO 强化学习);再用 DAgger(让学生自己走、老师随时纠正的模仿学习)蒸馏成只用机载深度和本体感受的学生策略;最后用多评论家 PPO 微调,每类技能各有一个价值网络并单独归一化优势,避免推箱这类奖励尺度大的任务主导梯度。真机上关闭 RealSense 的红外投射器,把原始双目红外图送进 LiteAnyStereo 立体匹配网络得到干净深度。
实验
本文方法 对比方法 · 数据来源:Table II, P.7
本文方法 对比方法 · 数据来源:Table III, P.7
本文方法 对比方法 · 数据来源:Table III, P.7
指标:成功率(越高越好)。单任务要求不摔倒、不卡住并满足各任务条件,如 SIT 要在椅子 0.9 m 内坐稳、GO-TO 要停在目标 1 m 内(P.17)。仿真评测在 MuJoCo 里跑完整部署栈,实时运行,规划延迟计入(P.17)。
单任务(P.7 表 II):6 个技能 × 100 个留出仿真房间 × 10 次,共 6,000 次仿真;6 个真实环境 × 10 次,共 360 次真机。平均成功率仿真 91%、真机 91%,真机最低是 SIT 85%,最高 CROUCH 100%。
多步任务(P.7 表 II):三种组合平均仿真 69%、真机 70%(真机仅 1 个环境)。连起来的成功率低于各步成功率相乘(DOOR→GO-TO 71% 对 89%),主要原因是上一步结束的朝向让下一步的目标不在视野里;作者建议加入搜索、原地转身等恢复动作(P.7)。
消融(P.7 表 III,仿真 SIT):训练房间从 1 → 10 → 100 → 1,000,成功率 43% → 64% → 81% → 84%,场景多样性在 100 个左右基本饱和。去掉计划衔接只有 24%,推理时 RTC 66%,训练时前缀条件 84%。把 flow matching 换成同骨干的回归解码器只有 19%。去掉深度降到 74%。
代价与速度:合成数据用 250 张 H100 跑 48 小时;生成器在 64 张 B200 上训练,跟踪器用 4 张 H100(P.6)。机载延迟:生成器约 152 ms,编排器单独约 0.72 s、与生成器共用 GPU 时约 1.46 s(P.16 表 IX)。
未系统研究的观察:微调 VLM 编码器能让跟人更灵敏,但会过拟合到训练中唯一的人体模型,且会忽略指令只看图像,需要更多人体资产和 30% 黑图训练来补救(P.18-19)。
要点 Take-home
- 纯仿真合成的视觉-语言-动作数据,足以让人形机器人在陌生真实家庭完成全身技能。
- 场景多样性比数据量更关键:1 个房间 43%,100 个房间就到 81%。
- 让生成器训练时学会接上已执行的动作前缀,是异步重规划不抖动的关键。
- 多步任务仍是短板:上一步结束时目标不在视野,链式成功率只有约 70%。
Claude 读完全文后的提炼。
更多:先读哪 · 值得看的理由 · 质疑
先读哪
先看第 2 页图 2(三层结构),再看第 7 页表 II(单/多任务成功率)和表 III(消融)
值得看的理由
- 训练数据全部来自仿真(1,000 个程序生成房间、约 300 小时),在 6 个未见、未扫描的真实环境里 360 次试验成功率 91%。 → P.7 表 II
- 消融清楚:训练房间从 1 个增到 100 个,成功率从 43% 升到 81%;训练时前缀条件比推理时 RTC 高 18 个百分点。 → P.7 表 III
质疑
- 没有和其他系统在同条件下对比,表 I 只比能力与试验数;消融只在仿真 SIT 一个任务上做,真实多步任务只有 1 个环境、每项 10 次。 → P.7 表 II、Table III;P.3 Table I
- 运动生成器训练时只见过 10 条固定指令,“自由语言”实际靠上层 VLM 映射到这 10 条,生成器自身的语言泛化没有被检验。 → P.10 Appendix A
审稿人笔记
导航方向最值得借鉴的是上层 VLM 用少量工具式动作监督子任务的设计,以及其暴露出的“缺记忆、缺搜索”失败模式。