Type 1 · Directly applicable Key group 证据 C 收录
VABAR: A Variational Automation Benchmark for Agentic Robotics
发布 · 收录于 2026-11-06
工业场景需要在已知范围的变化下反复可靠完成同一任务,VABAR 用六类仿真任务和统一技能库,专门测试“大模型写机器人程序”这类智能体系统的可靠性。
- 任务
- 工具分拣、挂工具、齿轮装配、针筒装箱、USB-C 插线、线缆布线
- 平台
- Newton 物理引擎 + Isaac Lab Arena;Franka 单臂、YAM 双臂
- 被测系统
- 人工技能图、GaP 自动生成图、无技能库的 Claude Code
- 开放
- 有项目主页,称全部基于开源工具;无真机实验
- 主要数字
- GaP(Newton)Level 2 成功率 10.0%–60.0%
证据等级 C · 单一基准或无代码 (A 真机 + 多基准 + 消融 / B 仿真充分 / C 单一基准或无代码)
动机
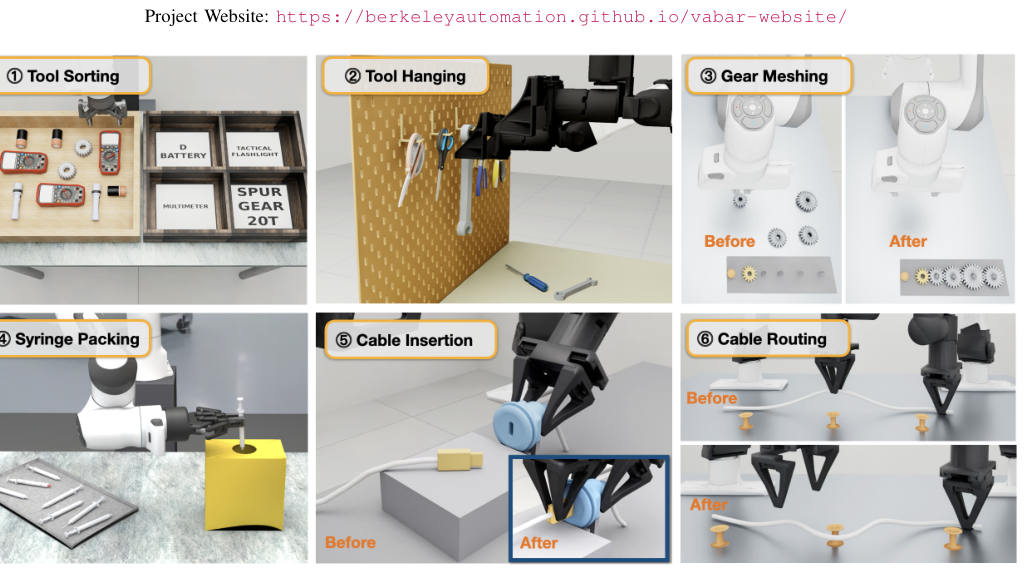
工厂、医院里的机器人常做同一件事,但每次物体形状、位置略有不同。作者把这叫变式自动化(Variational Automation,VA):目标固定,变化有范围、可预期。它介于“为固定场景写死程序”的传统自动化和“什么都想做”的通用机器人之间(→ P.1-2)。
现有操作基准(LIBERO、ManiSkill、SimplerEnv)主要测家务抓放,不少已被刷到很高成功率(→ P.2)。另一方面,智能体机器人(agentic robotics)——让大模型编码智能体调用感知、规划、控制“技能”来写机器人程序——发展很快,但各系统内部表示和工具都不同,缺一个公共考场(→ P.3)。
方法
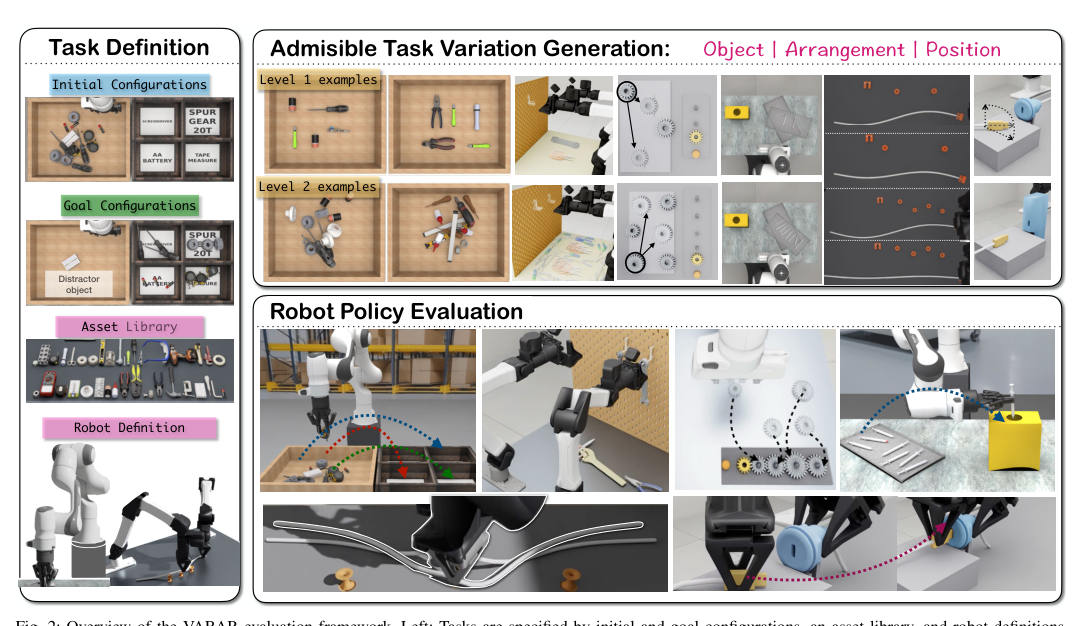
- 1定义任务资产、机器人、初始/目标配置和成功条件
- 2生成变体按物体、摆放、位置分两档难度采样
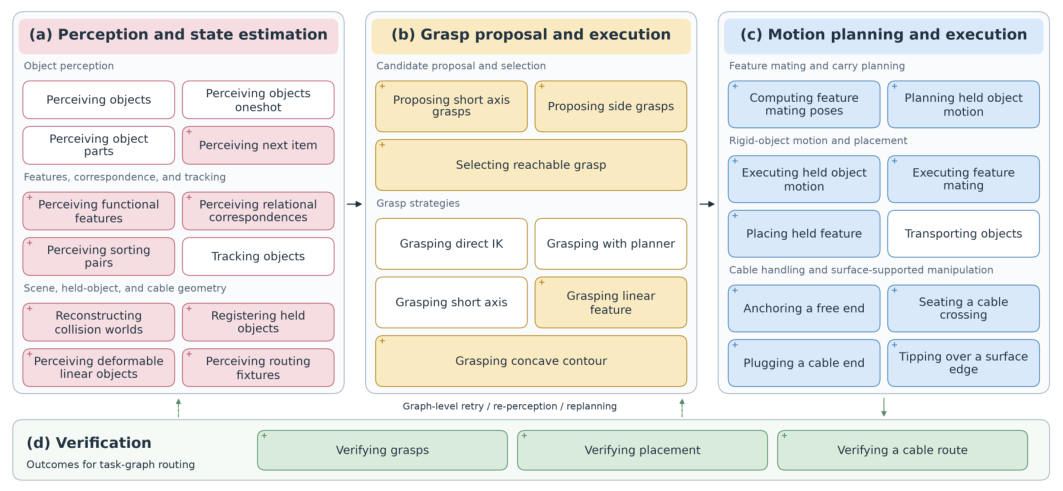
- 3智能体组程序用 33 个技能拼成可执行计算图
- 4仿真执行Newton 或 Isaac Lab Arena 运行
- 5记录归因存真值状态和接触,判失败来源
比喻:像驾照考试的固定考场——路线不变,但每次锥桶位置在规定范围内随机挪动。考的不是会不会开新路,而是在这片范围内能不能次次过。
1. 任务形式化:一个 VA 任务由坐标系、机器人、可用资产、可行物体配置空间、配置分布和成功条件组成。配置空间不是随便随机:每个实例必须仍是同一任务、物理上合理、机器人够得着,并按难度分档,同档实例能用同一套技能解决(→ P.3)。成功条件用扩展的 BDDL(一种描述任务目标的语言)写成,同时支持刚体和线缆(→ P.5)。
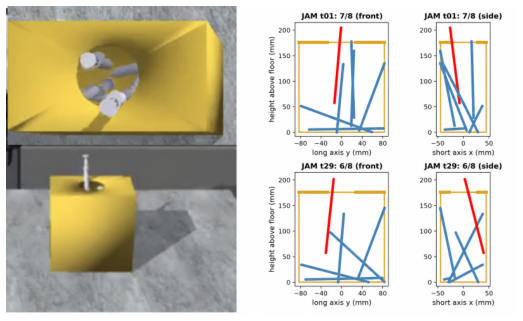
2. 诊断用执行记录:每一步记录真实物理状态、传感观测、系统估计状态、动作、接触和验证结果。于是“观测→估计”出错算感知失败,“估计→动作”出错算决策失败,“动作→物理结果”出错算抓取或运动失败(→ P.4 图 3)。接触记录能说明物体为什么停在错的位置,例如被卡住(→ P.4)。
3. 技能库:在 GaP(一个把策略表示成技能计算图的多智能体框架)原有技能库上新增 25 组,共 33 个技能,覆盖功能部位感知、受约束放置、线缆处理和执行检查(→ P.5-6 图 4)。每个任务还附一份人工写的参考解,用同一技能库和同一执行栈。
实验
本文方法 对比方法 · 数据来源:Table II, P.6
本文方法 对比方法 · 数据来源:Table II, P.6
数据来源:Table II, P.6
设置:6 类任务 × 2 档难度,每个条件 30 个独立生成的实例(→ P.7)。指标:成功率(越高越好);周期时间,即成功试次的仿真用时中位数(越低越好);失败来源占比(→ P.6)。分拣、挂工具这类物体彼此独立的任务按单个物体算成功率,齿轮这类前后相关的任务按整个实例算(→ P.6)。
对比系统(→ P.7):(a) 人工连接的技能图,在 Newton 和 Isaac Lab Arena 两种实现上跑;(b) Claude Code(Claude Opus 5),无机器人技能库;(c) GaP,用同一模型自动生成技能图,和 (a) 共用感知、技能、规划与执行模块。
结果(→ P.6 表 2): - 难度升高,成功率普遍下降、用时变长;USB-C 插线(人工图 86.7%→30.0%)和布线最明显(→ P.7)。 - GaP 在 12 个设置中 11 个高于 Claude Code(挂工具 Level 2 两者都是 10.0%);Claude Code 除挂工具两档和布线 Level 1 外全为 0(→ P.6-7)。 - GaP 在 Newton 上所有设置都低于人工图,说明“选对技能、调对参数、拼对结构”仍是难点(→ P.7)。人工图本身也远未满分,例如工具分拣 Level 1 只有 47.1%。 - 失败来源(→ P.7 表 3):低难度时主要是运动规划;高难度杂乱场景感知失败上升(分拣 Level 2 感知占 56.4%);插线 Level 2 运动失败占 96.0%。
哪些站得住:harness+技能库优于裸编码智能体这一点较清楚,但作者也说明这没有分开 harness 和技能库各自的贡献(→ P.7)。代价:在 NVIDIA L40 GPU 集群上运行(→ P.5),没有报告评测所需算力或墙钟时间。
要点 Take-home
- 同一大模型配上机器人技能库和编排框架,12 个设置中 11 个更好
- 自动生成的技能图仍全面落后人工图,难点在技能组合与参数
- 难度升高成功率普遍下降,精密插线和线缆任务掉得最多
- 同一人工方案换仿真实现成功率差别很大,且无真机验证
Claude 读完全文后的提炼。
更多:先读哪 · 值得看的理由 · 质疑
先读哪
先看第 1 页图 1 认识六个任务,再看第 6 页表 2 和第 7 页表 3
值得看的理由
- 同一大模型下,带技能库的 GaP 在 12 个任务-难度设置中 11 个胜过裸 Claude Code,量化了机器人专用 harness 的价值 → P.7 第 VIII(a), Table II 节
- 执行记录含仿真真值状态与接触,能把失败分到感知、抓取、运动三类,适合做可验证的反馈信号 → P.4 第 III-C, Fig. 3 节
质疑
- 没有真机实验检验“可物理实现、能预测真机表现”的主张;同一人工方案换仿真实现,布线 Level 2 成功率 46.7% 对 5.0% → P.6 表 II
审稿人笔记
表 3 中齿轮装配 Level 1 的失败来源记为 N/A,而 GaP 在该设置有 30% 失败,原因未说明。