Type 1 · Directly applicable 证据 B 收录
Robocasa-Mem: Benchmarking Environment and Process Memory in Long-Horizon Mobile Manipulation
发布 · 收录于 2026-11-06
移动操作里很多决策只能靠“记得之前发生过什么”,作者为此做了一个 9 任务的仿真基准,并给出一个带文本记忆的两层基线 HMAP。
- 任务
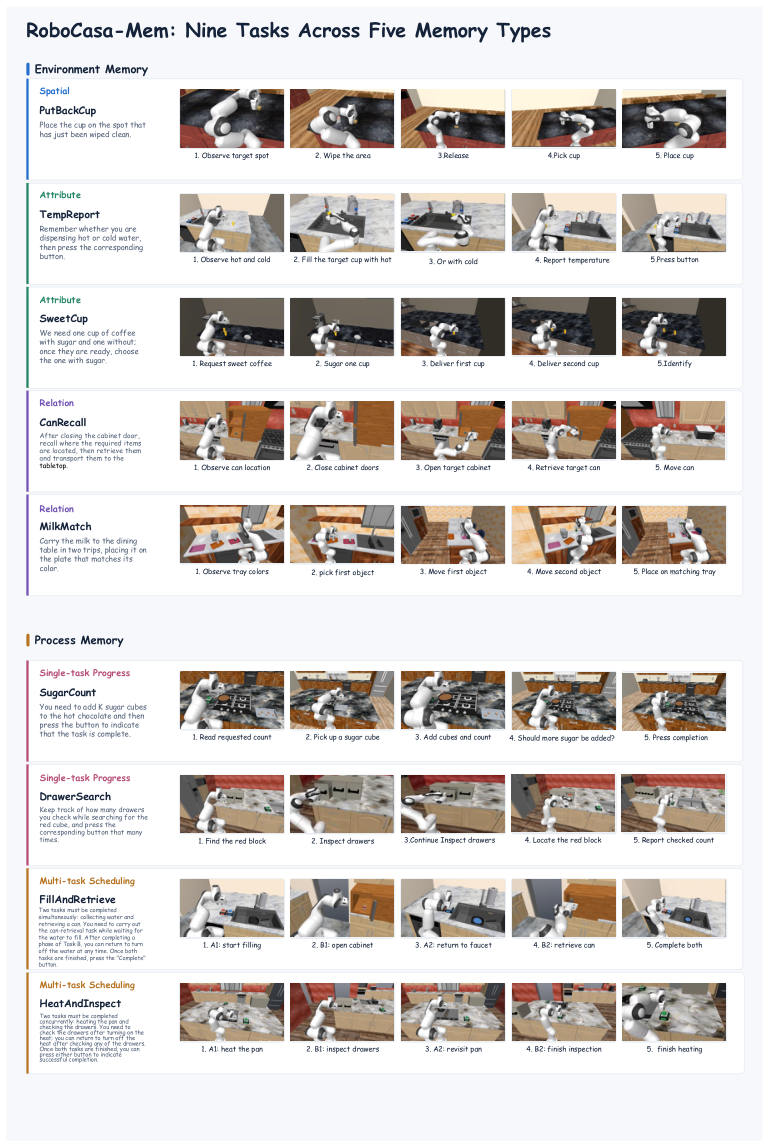
- 需要记忆的家庭移动操作(9 个任务、5 类记忆)
- 数据
- RoboCasa 仿真,1800 条成功示教,每任务 50 个测试场景
- 硬件
- 仿真为主;真机 AgileX Cobot Magic 一个任务各 10 次
- 代码
- 已开源代码、数据和项目页
- 主要数字
- 平均成功率 0.16(π0.5)→ 0.24(HMAP)
证据等级 B · 仿真充分 (A 真机 + 多基准 + 消融 / B 仿真充分 / C 单一基准或无代码)
动机
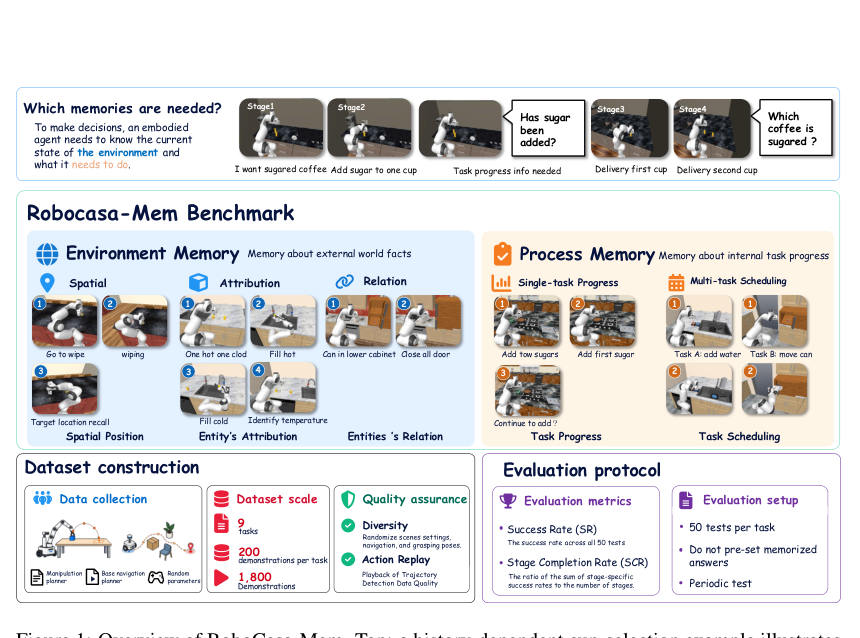
机器人在厨房里走来走去时,很多关键信息会“看不见”:糖溶化后看不出哪杯加过糖,柜门关上后看不到罐头在哪。这时只看当前画面是做不对的,必须记得过去。
现有移动操作基准(RoboCasa、BEHAVIOR-1K、Habitat 等)主要考执行和泛化,没有专门挑出“必须用历史”的决策点;已有的记忆基准(RMBench、RoboMME 等)大多是桌面固定底座。作者还强调:任务步骤多不等于需要记忆,只要当前画面够用,长任务也可以不靠记忆(P.1-2)。
他们用一个条件来设计任务:两段不同的历史在当前时刻看起来一样,但正确动作却不同(部分可观测问题里的“观测混叠”,observation aliasing,P.4 式 1)。
方法
- 1看两帧当前画面加 2.5 秒前的画面
- 2更新记忆VLM 改写实体记忆和过程记忆
- 3出子目标输出一句语言子目标给下层
- 4取几何VGGT-Ω 编码三路相机的 3D 特征
- 5生成动作π0.5 按子目标和几何特征出动作
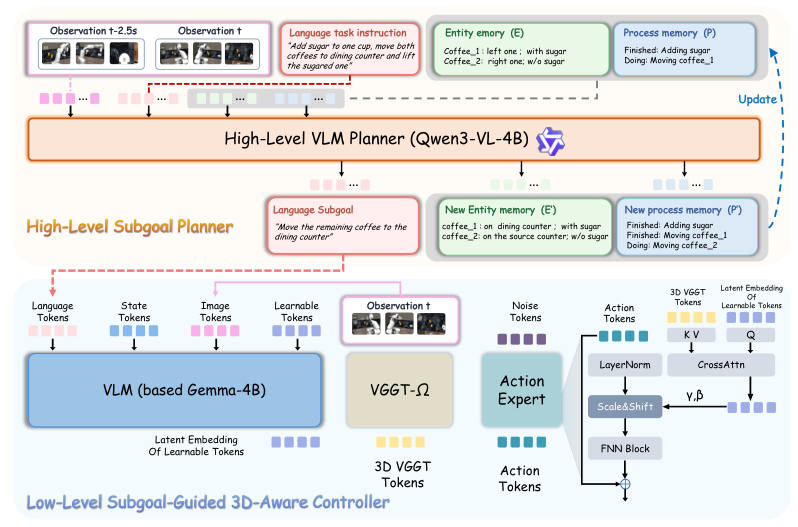
比喻:像厨师身边有个记事本。本子上记两样东西:“哪杯放了糖、罐头在哪个柜子”(实体记忆,entity memory),以及“已经做完哪步、还欠哪件事”(过程记忆,process memory)。助手每隔一会儿看看现场、改一下本子,然后只把下一句指令递给厨师;厨师只管照这句话干活。
上层:符号记忆规划器。用 Qwen3-VL-4B(一个视觉语言模型,VLM)。每次输入总指令、上一次的两种文本记忆、当前画面和约 2.5 秒前的画面,输出新记忆和一个可执行的语言子目标(P.7 式 2)。记忆在多次调用之间递归传下去,所以看不见的信息也能保留。规划器用从专家示教中离线生成的结构化标注来训练(P.7、P.16)。
下层:子目标引导的 3D 控制器。底座是 π0.5(一种视觉-语言-动作模型,VLA,直接从图像和语言输出机器人动作),用流匹配(flow matching,一种生成式训练目标)训练。另外用冻结的 VGGT-Ω(能从多张图直接推出 3D 几何的基础模型)编码三路相机。8 个可学习查询向量结合当前任务上下文,通过交叉注意力从几何特征里“取”有用信息,再以缩放和平移的方式调制动作专家的各层,而不是把几何 token 直接拼进去(P.7、P.16)。
上下两层分开训练。
实验
本文方法 对比方法 · 数据来源:Table 3(b), P.8
本文方法 对比方法 · 数据来源:Table 3(a), P.8
本文方法 对比方法 · 数据来源:Table 5, P.9
设置:9 个任务各 50 个固定测试场景,所有方法用同一批示教训练(P.6-7)。对比 ACT、Diffusion Policy(DP)、π0.5、MemER-style(与本文同一规划模型和同一下层骨干,只是记忆训练方式不同)。
指标(都是越高越好):任务成功率 SR(整件事做完的比例);阶段完成率 SCR(各阶段成功率的平均,看做到了哪一步)(P.6)。
主结果(P.8 表 3):HMAP 平均 SR 0.24、SCR 0.47,π0.5 为 0.16、0.41;ACT、DP、MemER-style 几乎做不完整个任务。
- 环境记忆收益最明显:TempReport 的 SR 从 0.22 升到 0.86;到达报告阶段后答对温度的比例从 0.41 升到 0.90;SweetCup 选对甜杯的条件成功率从 0.22 升到 0.45(P.8)。
- 过程记忆几乎没帮上忙:计数类任务两者相近;两个多任务交替任务(HeatAndInspect、FillAndRetrieve)所有方法 SR 都是 0(P.8)。
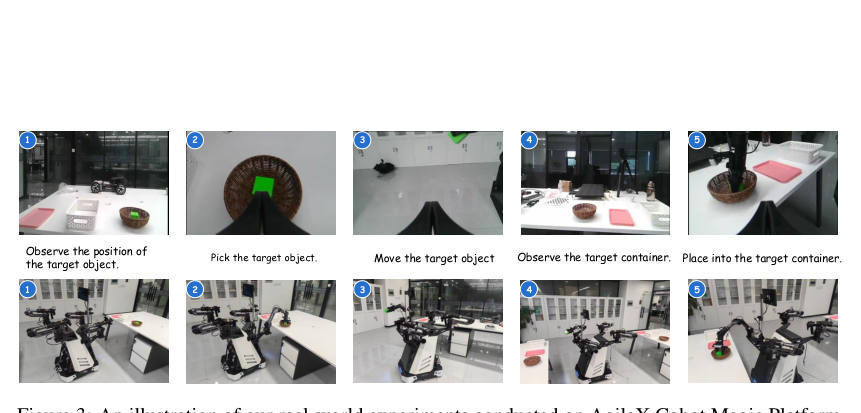
- 真机:AgileX Cobot Magic 上一个“记住源容器颜色再放对容器”的任务,放对容器 8/10 对 π0.5 的 2/10(P.9 表 4)。只有一个任务、每法 10 次,作者自己也说结论有限(P.10)。
- 消融(P.9 表 5,仿真 SingleMilkMatch):加规划器让最终成功从 0.20 到 0.34,再加 VGGT-Ω 到 0.40,加上可学习查询的完整模型到 0.46。
站得住的结论:显式文本记忆对“看不出来的属性”最有效。需要谨慎的:平均提升主要由一个任务撑起;消融只在一个任务上做;论文没有报告推理速度或计算开销。
要点 Take-home
- 当前画面看不出的属性,靠文本记忆最有用:TempReport 成功率 0.22→0.86。
- 九任务平均成功率只从 0.16 升到 0.24,基准远未被解决。
- 计数和多任务交替几乎没改善,交替任务所有方法成功率都是 0。
- 按机器人自己的实际选择来判后续对错,能避免固定答案带来的捷径。
Claude 读完全文后的提炼。
更多:先读哪 · 值得看的理由 · 质疑
先读哪
先看第 4 页图 1 和第 8 页表 3,再看第 9 页表 5 消融
值得看的理由
- 首个把“必须靠历史才能做对的决策”单独拿出来考的移动操作基准,任务、示教数据、代码都公开 → P.3 表 1;P.1 摘要链接
- 行为条件评测:先看机器人实际给哪杯加了糖,再据此判后面选得对不对,避免固定答案带来的捷径 → P.6 第 3.4 节
质疑
- 平均成功率提升几乎全来自 TempReport 一项(0.22→0.86);按表 3 去掉它,其余 8 项平均 SR 约 0.165 对 0.155,几乎没差 → P.8 表 3
- 同骨干的 MemER-style 基线平均 SR 仅 0.02,远低于不带记忆的 π0.5,疑似调参不足;附录承认优化器、LoRA 等设置尚未给出 → P.16 Appendix C
审稿人笔记
规划器靠从专家示教自动生成的记忆标注训练,换到无标注的真实长任务时这套监督怎么来,论文没有讨论。