Type 1 · Directly applicable 证据 C 收录
Can Astra Solve RoboMME without Breaking the Bank?
发布 · 收录于 2026-11-06
大视觉语言规划器不必每个动作块都调用:让一个小模型判断子任务何时完成再唤醒它,就能在需要记忆的操作任务上又准又省。
- 任务
- 需要记忆的桌面操作(RoboMME,16 个任务、4 个套件)
- 系统
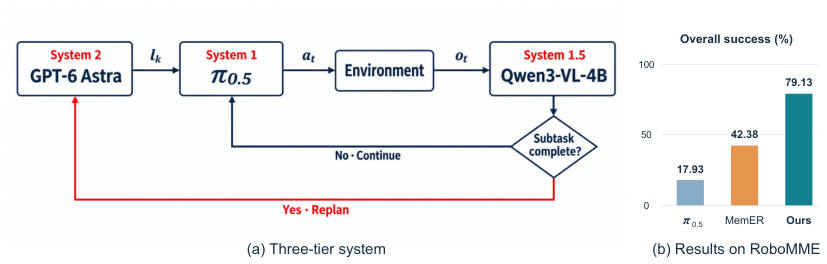
- GPT-6 Astra 规划 + π0.5 VLA 执行 + Qwen3-VL-4B 监视
- 平台
- 仅仿真;VLA、monitor、仿真器共用一张 L40S
- 主结果
- 成功率 79.13%,每局 3.63 次 Astra 调用、80.84 秒
- 代码
- 有项目主页,文中未说明是否开源代码
证据等级 C · 单一基准或无代码 (A 真机 + 多基准 + 消融 / B 仿真充分 / C 单一基准或无代码)
动机
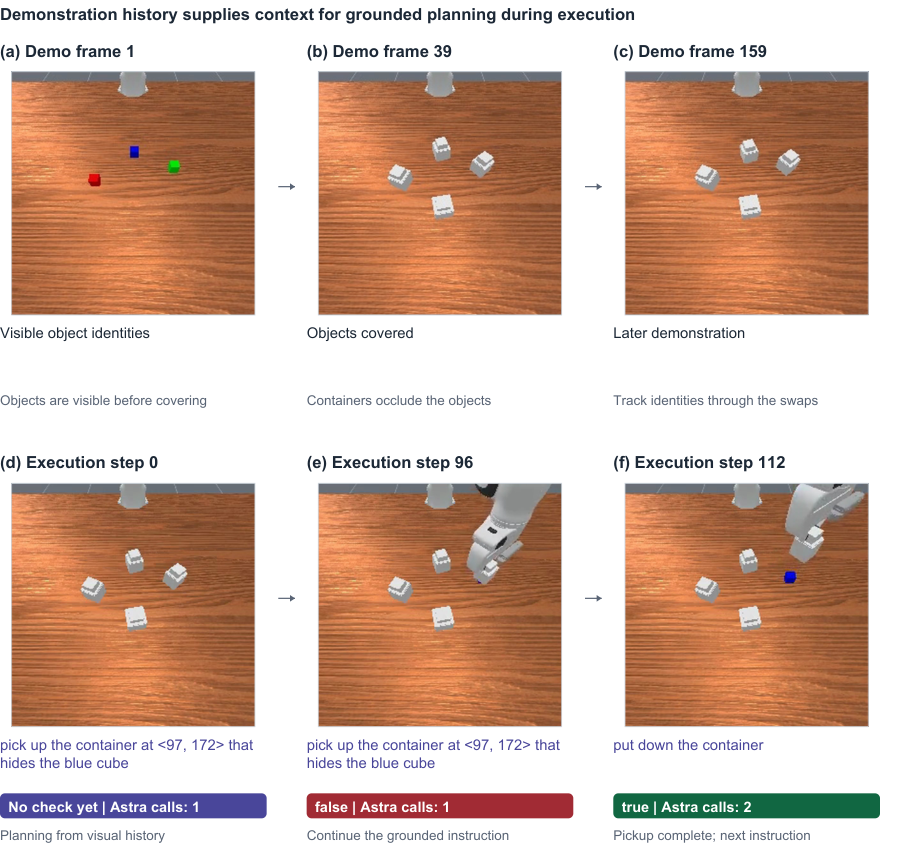
很多操作任务要记住已经看不见的信息:比如方块被杯子盖住之前在哪、示范里动作的先后顺序、已经重复了几次。RoboMME 是专门测这种记忆的基准(benchmark),有计数(Counting)、物体恒存(Permanence)、指代(Reference)、模仿(Imitation)四类共 16 个任务(→ P.1)。
常见做法是分层:上层视觉语言模型(VLM)选下一个子任务,下层视觉-语言-动作模型(VLA,直接输出机器人动作的模型)去执行。作者发现小 VLM 常读错视频、下错子任务,所以上层要用很强的 GPT-6 Astra;但每个动作块前都调用它又慢又贵,而且大多是多余的:一个子任务通常要持续好几个动作块(→ P.1)。
方法
- 1备历史示范视频、执行关键帧和进度表
- 2大模型规划GPT-6 Astra 给出带像素坐标的子任务
- 3VLA 执行π0.5 每次执行 16 步动作块
- 4小模型检查Qwen3-VL-4B 判断子任务是否完成
- 5按事件重规划完成才再调大模型,否则继续执行
比喻:工地上的总工程师(大模型)很贵,只在一道工序完工时被叫来安排下一步;工人(VLA)照着当前指令一段一段干活;质检员(小 monitor)每干完一段就看一眼“完工了没有”。没完工就接着干,完工了才去叫总工程师。
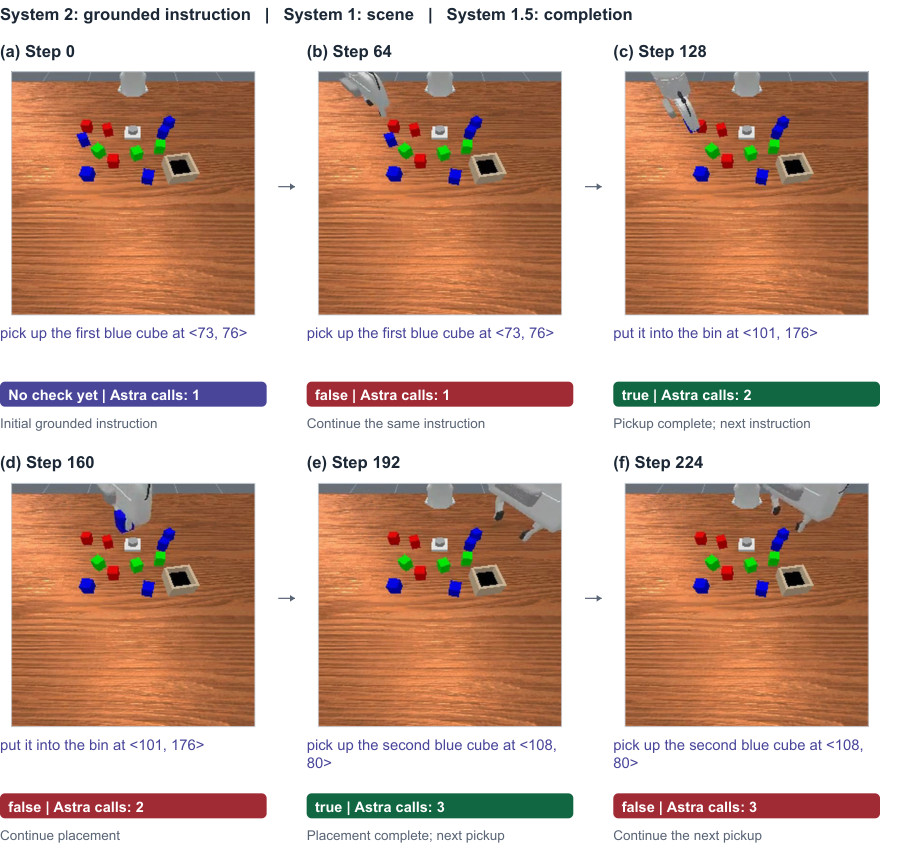
1. 上层规划(System 2):每次被叫到时,Astra 根据当前图像、任务目标和历史 m_t 输出一条可执行指令 l_k。历史有三部分:示范视频(如果任务有)、可能拍到现在被遮住物体的执行帧、以及一份文字进度表,进度表把“已下发的子任务”和“monitor 确认完成的子任务”分开记,重复动作逐条记录,所以次数和顺序不会丢。Astra 本身不保存状态,每次请求都把历史全部带上;需要定位目标时,指令里带一个当前图像的像素坐标(→ P.2)。给哪种历史、允许哪些输出模板是逐任务配置的:9 个任务给示范视频,4 个任务给密集执行历史(→ P.2, P.8)。
2. 下层执行(System 1):直接用 RoboMME 发布的 π0.5 检查点,每个动作块 16 步;同一条指令可以连续用好几个块,每块都基于新观测重新预测,所以 Astra 不在时控制仍是闭环的(→ P.2)。
3. 进度监视(System 1.5):Qwen3-VL-4B 用 LoRA(只训练少量附加参数的微调方法,秩 16)在 71,835 条由示范数据切出的样本上训练两轮,输入 10 张图(最近 8 帧前视图、本条指令开始时的前视图、当前腕部相机图),输出“完成 / 未完成”一个二值事件(→ P.2-3, P.8)。
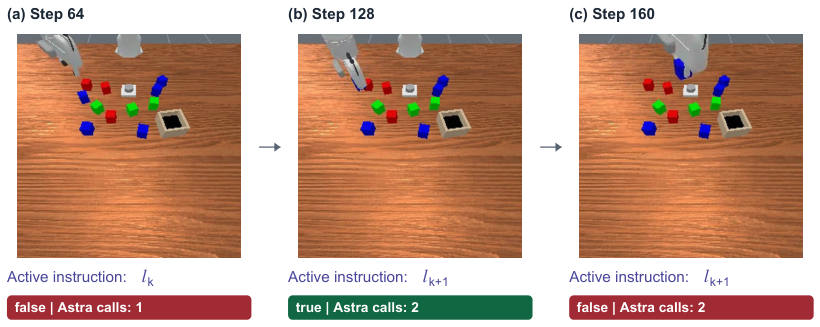
事件触发:开局调一次 Astra,之后每个动作块后跑一次 monitor;只有报告完成(或两个任务里的特殊事件)才再调 Astra。StopCube 里 monitor 在方块快到目标前约 16-32 步报警,由 Astra 数经过次数决定按不按按钮;ButtonUnmaskSwap 里由 Astra 复核第二次按键(→ P.3, P.8)。
实验
本文方法 对比方法 · 数据来源:Table 1, P.4
本文方法 对比方法 · 数据来源:Table 1, P.4
设置:RoboMME 官方测试集,每任务 50 局、共 800 局,每局 1,300 步预算,指标是仿真任务成功率(越高越好)。基线数字直接取 RoboMME 论文已发表结果,包括只看当前帧的 π0.5、感知记忆类方法(FrameSamp+Modul、SAM2Act+)、上层规划类(MemER、GroundSG+QwenVL、GroundSG+Gemini);GroundSG+Oracle 给下层真值子目标,当作参考上限(→ P.3)。
结果:总成功率 79.13%,比最强非 oracle 基线 FrameSamp+Modul(44.51%)高 34.62 点,比 Oracle(84.08%)低 4.95 点。分套件:Permanence 94.00%、Reference 92.00%、Counting 69.50%、Imitation 61.00%(→ P.3-4 表 1)。Permanence 上甚至略高于 Oracle 的 93.31%。
失败:167 局没成功,其中 103 局失败、64 局超时;StopCube 和 InsertPeg 各只成功 9/50,合计占 82 局。StopCube 要在运动方块的特定一次经过时按下按钮;InsertPeg 是接触密集的插入,41 局里 36 局超时(→ P.4, P.9 表 2)。作者尚未区分这些失败来自规划、监视还是执行。
代价:平均每局 3.63 次 Astra 调用、80.84 秒墙钟时间;轨迹平均 24.62 个动作块,按同样轨迹估算少调约 85.3%(→ P.4 式 4)。但这只是在已记录轨迹上的估算,没有真跑每块都重规划的版本,也没统计 token 和费用;且规划期间仿真器暂停,规划耗时不占步数预算(→ P.3-4)。
能站住的结论:整套系统在 RoboMME 上明显超过已发表基线;“小模型判完成 + 事件触发大模型”能把大模型调用压到每局几次。站不住或未验证的:各模块各自贡献多少(无消融)、和基线是否公平(规划器、输入、重规划频率都不同,作者也说不是匹配比较)。
要点 Take-home
- 用小模型判断子任务是否完成,大规划器每局只需调用约 3.6 次。
- 总成功率 79.13%,比最强非 oracle 基线高 34.62 点。
- 计数和精细插入是短板:StopCube、InsertPeg 都只有 18%。
- 没有消融,且规划时仿真暂停,真机实时性未验证。
Claude 读完全文后的提炼。
更多:先读哪 · 值得看的理由 · 质疑
先读哪
先看第 2 页图 1 和第 4 页表 1,再看第 4 页 Planner usage 一段
值得看的理由
- 把“什么时候叫大模型”交给微调的小 monitor,每局只调 3.63 次大模型,对比约 24.62 个动作块 → P.4 Planner usage, Eq. 4
- RoboMME 总成功率 79.13%,比最强非 oracle 基线高 34.62 点,离给真值子目标的 Oracle 只差 4.95 点 → P.4 表 1
质疑
- 没有任何消融,也没跑“每块都重规划”的对照;提升分不清来自更强的 GPT-6 Astra、历史输入还是 monitor(作者自己承认) → P.4 第 4 Limitations 节
- 历史选择、输出模板和事件规则逐任务手写,且规划时仿真器暂停,迁移到新任务和真机实时场景未验证 → P.8 App. B.1, B.3; Sec. 2.4
审稿人笔记
可当作“慢规划、快执行”接口的参考实现,但各模块的贡献要等消融补齐才能判断。