Type 1 · Directly applicable 证据 B 收录
Asynchronous Robot Policies
发布 · 收录于 2026-11-05
把 VLA 拆成慢速 VLM 和快速视觉-动作专家两个异步进程,并在训练时故意让动作专家看过期的语义记忆,就能在不牺牲大模型能力的前提下保持实时反应。
- 任务
- 桌面机械臂操作(Franka),含动态扰动
- 数据
- LIBERO、LIBERO-Perturb、Dynamic Bump、DROID / RoboLab
- 硬件
- Franka 真机 3 个任务各 10 次;推理用 A6000 GPU
- 代码
- 项目页 arp.insait.ai 称提供代码与权重
- 主要数字
- 目标位移 5 cm:51.5% 对 9.5%(ARP-1B 对 π0-1B)
证据等级 B · 仿真充分 (A 真机 + 多基准 + 消融 / B 仿真充分 / C 单一基准或无代码)
动机
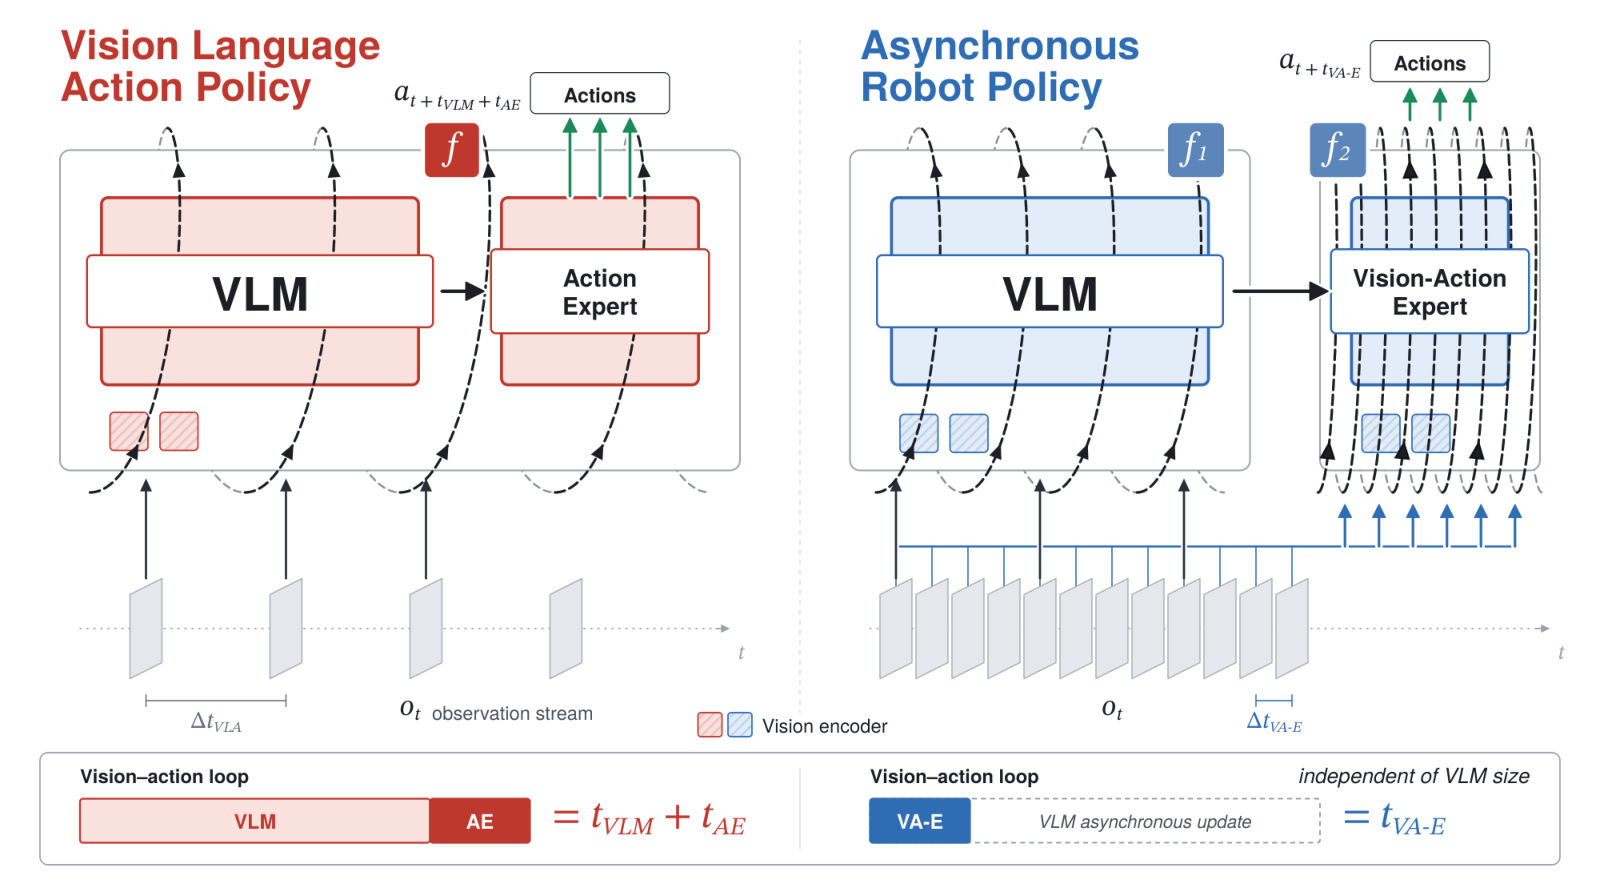
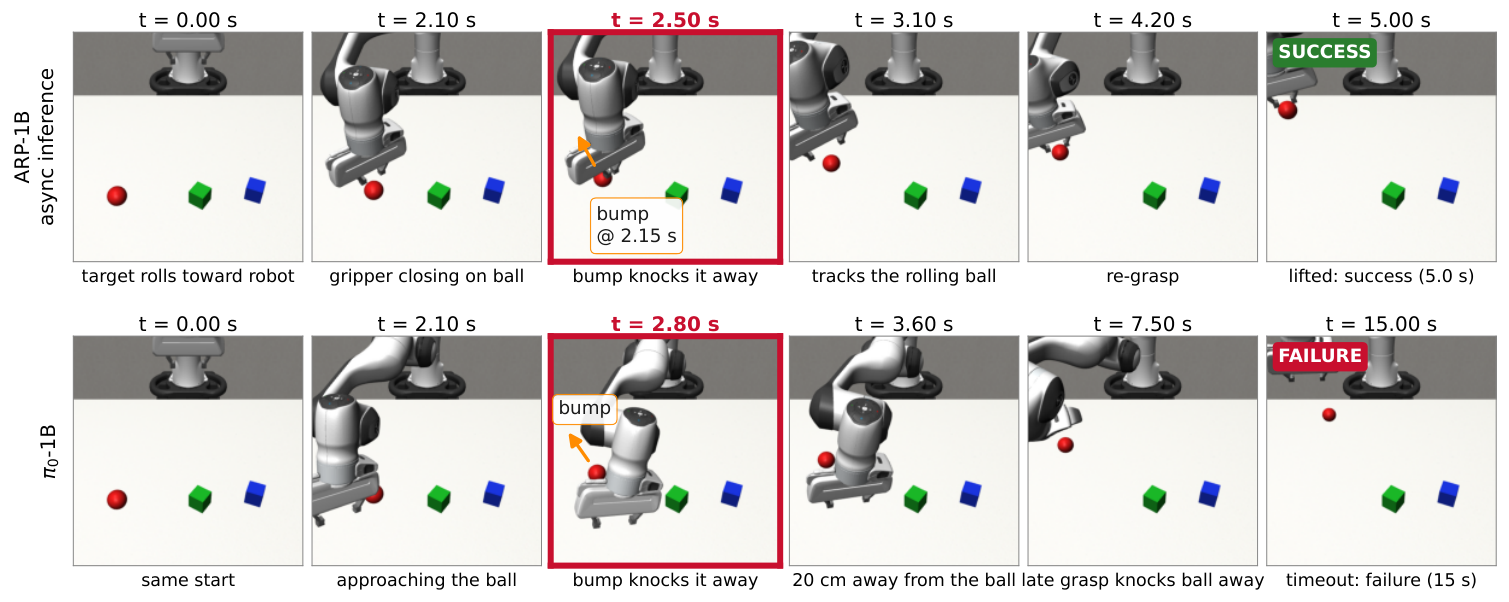
VLA(Vision-Language-Action,视觉-语言-动作模型)通常先跑一遍大视觉语言模型(VLM),再跑动作专家,两段延迟相加(t_VLM + t_AE)。模型越大,机器人“反应”越慢:目标被撞开或挪动时,动作已经过时。
已有的异步方案(如 AsyncVLA、实时动作分块 RTC)主要处理云端延迟或动作块衔接,动作生成仍依赖主模型的那一遍推理。难点在于:一旦让两部分异步,快环拿到的语义信息总是“旧的”,新算出的动作也可能晚到。
方法
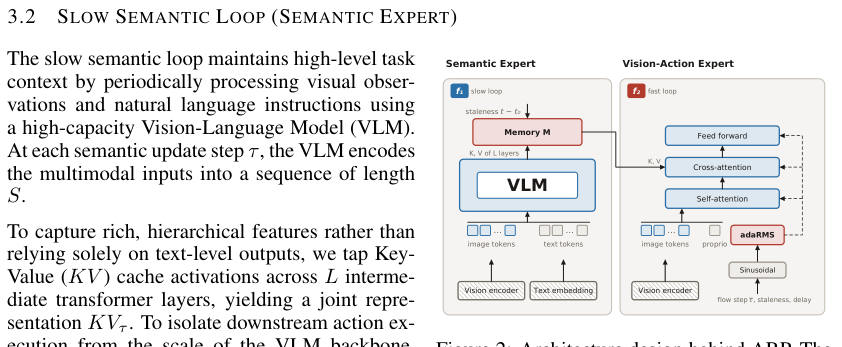
- 1慢环:VLM低频读图像和指令,取多层 KV 缓存
- 2压成记忆投影成固定大小记忆,附上“年龄”编码
- 3快环:看动作专家实时读多路相机和本体状态
- 4快环:动交叉注意力读记忆,流匹配生成动作块
- 5训练:喂旧记忆随机配对旧帧记忆与当前帧,学会容忍过期
比喻:像开车时司机和领航员分工。领航员(大 VLM)看地图想路线,隔一会儿才说一句;司机(动作专家)一直盯着路面打方向盘。司机知道领航员上一句话是多久以前说的,于是该信多少自己判断。
关键模块 1:固定宽度的语义记忆。 不用 VLM 输出的文字,而是取 L 层中间层的 Key-Value(KV)缓存,经过“层归一化 + 线性投影”压成大小固定(S × D)的记忆 M,并加上位置编码和陈旧度编码(staleness,记忆距今多少步)。因为大小固定,换更大的 VLM 时快环的计算量不变(→ P.4 式 2)。
关键模块 2:快环动作专家。 一个双向 Transformer,输入是当前图像 token、本体状态、若干寄存器 token 和待生成的动作 token;每层用交叉注意力读记忆 M。每层的自适应归一化(AdaRMS)同时接收流匹配步数、记忆陈旧度 d_t 和快环执行延迟 ℓ_t,让网络“知道”信息有多旧(→ P.4)。
关键模块 3:陈旧度训练。 训练时,把当前帧和同一条示范中更早的一帧配对:以一定概率不加延迟,否则在 1 到 d_max 步之间均匀随机取延迟(默认 d_max = 40)。另外用动作前缀条件化(prefix conditioning),让新动作块与已执行的动作平滑衔接(→ P.5 式 3,P.14)。
实验
本文方法 对比方法 · 数据来源:Table 3, P.7
本文方法 对比方法 · 数据来源:Table 1, P.6
本文方法 对比方法 · 数据来源:Table 4, P.8
指标:成功率 SR(越高越好);执行时间(越低越好);RoboLab 的平滑度指标 ISJ(越低越平滑)和 SPARC(越接近 0 越平滑)。
静态任务(LIBERO):所有变体共用冻结的 InternVL-4B 视觉编码器,只换语言模型大小。ARP-1B 平均 84.8%,ARP-8B 89.3%;同结构的复现版 π0-1B / 8B 为 80.2% / 82.7%。但官方 π0 报 94.2%,比所有 ARP 都高(→ P.6 表 1)。
动态任务:LIBERO-Perturb 在夹爪距目标 10 cm 时把目标横移 5 cm,ARP-1B 51.5%,π0-1B 9.5%(→ P.7 表 3)。Dynamic Bump 中滚动的球被中途撞偏,p = 1 时 44.7% 对 12.7%,p = 0.5 时 46.7% 对 20.0%(→ P.7 表 2)。两项只比较了 1B 模型。
降低 VLM 频率:同步基线在算力受限时从 81.5% 掉到 45.0%;ARP-1B 保持在 79.0%–84.8%(→ P.8 图 6)。
消融:结构不变,只改训练时的陈旧度分布。不加陈旧度训练时,VLM 降到 0.5 Hz 成功率只剩 2.0%;默认设置为 81.8%;范围更宽(1–80 步)为 86.5%(→ P.8 表 4)。这是全文最站得住的结论。
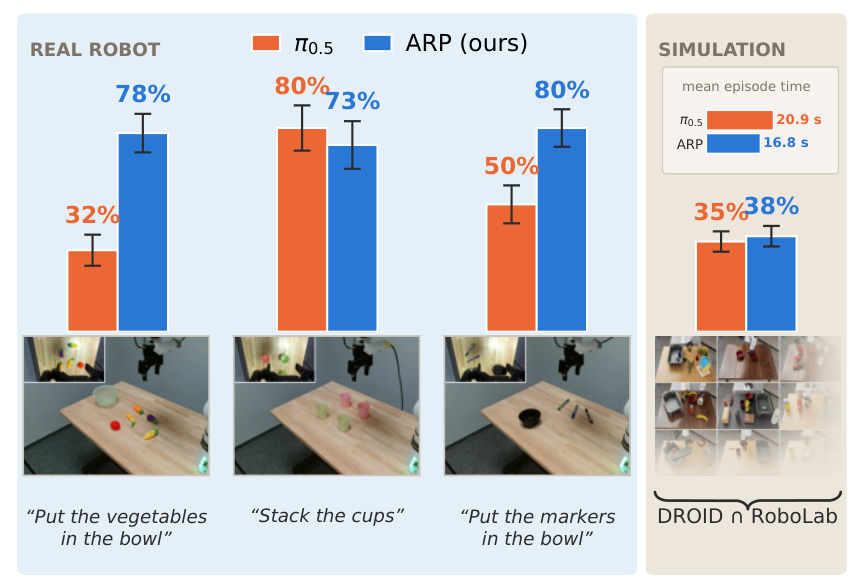
DROID 真机与 RoboLab:3 个真机任务各 10 次,按完成进度打分,“放蔬菜”78% 对 π0.5 的 32%,“放马克笔”80% 对 50%,“叠杯子”73% 对 80%(→ P.7 图 3)。RoboLab 全部 120 个任务上 ARP-3B 平均 20.0%,高于 LAP-3B 的 18.4%,但低于 π0.5 的 37.9%(→ P.16 表 6)。异步推理加前缀条件化后,成功率从 31.9% 升到 37.5%,末端抖动(ISJ)降 39.4%(→ P.9 表 5)。
速度:A6000 上,VLM 预填充 + 适配器 1B 约 64 ms、8B 约 125 ms;视觉-动作专家约 55 ms(→ P.14)。
要点 Take-home
- 把大 VLM 移出控制环,目标突然移动时成功率从一成升到五成
- 关键在训练时喂过期记忆,否则 VLM 一降频成功率就崩到个位数
- VLM 降到 0.5 Hz,LIBERO 成功率仍保持在八成以上
- 整体仍弱于官方 π0 与 π0.5,大规模预训练的差距没有被抹平
Claude 读完全文后的提炼。
更多:先读哪 · 值得看的理由 · 质疑
先读哪
先看第 1 页图 1,再看第 8 页表 4 和第 7 页表 2、表 3
值得看的理由
- 把大模型推理移出控制环后,目标突然移动 5 cm 时成功率 51.5% 对 9.5% → P.7 表 3
- 消融干净:同一结构只改训练时的记忆陈旧度分布,VLM 降到 0.5 Hz 时成功率从 2.0% 变为 81.8% → P.8 表 4
质疑
- 对比的 π0 是自行复现版(LIBERO 平均 80.2%,官方 94.2%),且图 1b 中 Diffusion Policy 的动态成功率反而高于 ARP,“反应性”优势主要相对一个偏弱的同步基线 → P.6 表 1;P.1 图 1b
- 图 3 仿真只报告手选的 18 个任务子集(ARP 38% 对 π0.5 35%);在 RoboLab 全部 120 个任务上 ARP 为 20.0%,π0.5 为 37.9% → P.16 表 6
审稿人笔记
动态任务只比较了 1B 模型,且未说明仿真中推理延迟如何折算成仿真步数,复现时应先确认这一点。