Type 1 · Directly applicable Must-readKey groupRequested 证据 A 收录
WayTrace: A Map-to-Language-to-Trace Hierarchy for Embodied Urban Navigation
发布 · 收录于 2026-11-05
把网页地图的逐步路线变成一句句“看得见的”原子语言指令,再让机载模型把每句指令画成图像里的路径,机器人就能不依赖精确 GNSS 在城市里走长路线。
- 任务
- 按网页地图路线的城市长距离导航(走人行道、过斑马线)
- 数据
- 1.19M 条轨迹样本,来自 182 个城市的 Mapillary 街景序列
- 硬件
- Unitree B2W 轮腿机器人 + ZED X 双目 + Jetson AGX Thor/Orin
- 代码
- 有项目页,代码、数据、仿真基准承诺发布,尚未放出
- 主要数字
- 仿真成功率 83.3%(基线 ≤20%),真机最长 1.37 km
证据等级 A · 真机 + 多基准 + 消融 (A 真机 + 多基准 + 消融 / B 仿真充分 / C 单一基准或无代码)
动机
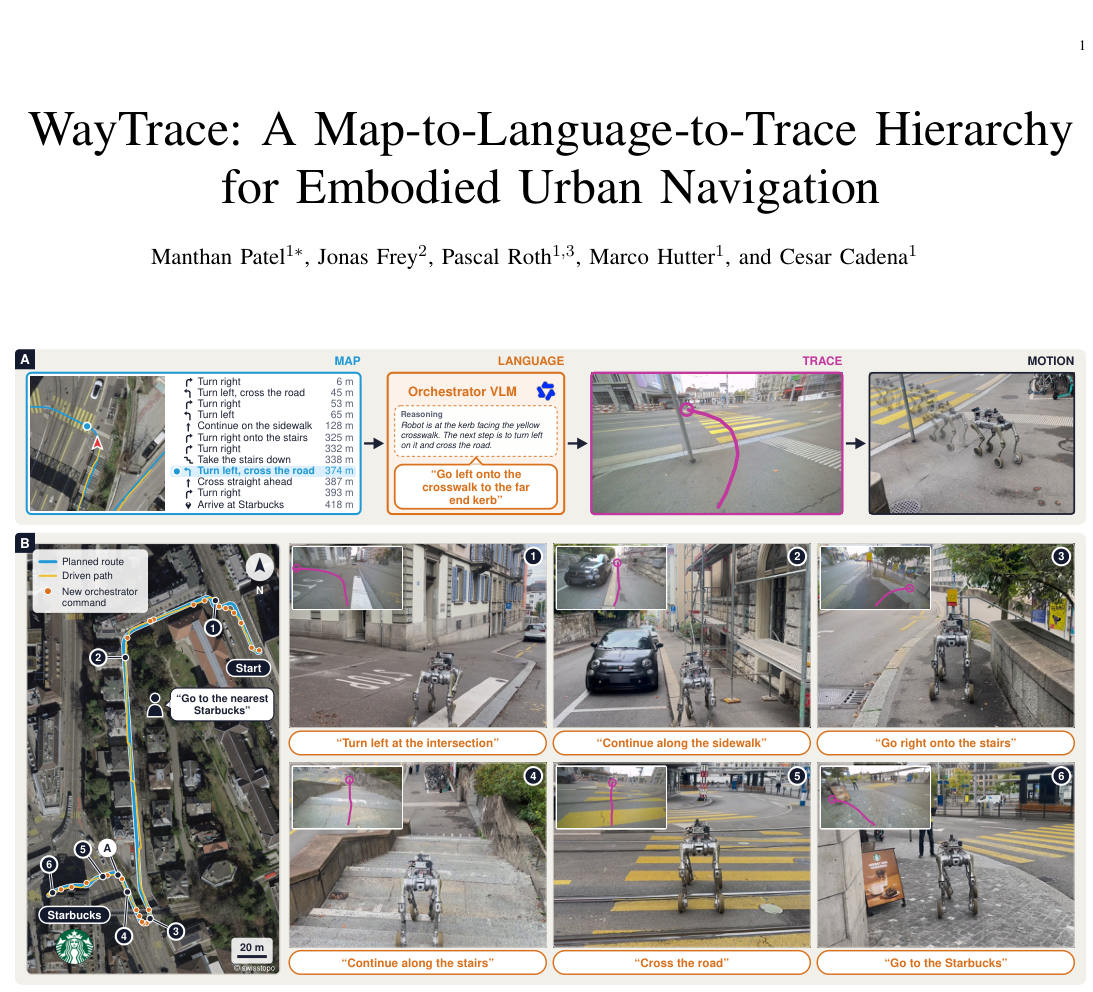
人在陌生城市走路,只看手机地图的“左转、过马路、走楼梯”,再用眼睛判断斑马线从哪开始。机器人现有两条路都不好走:
- 点目标导航(point-goal navigation,按坐标航点走):完全依赖 GNSS(卫星定位)。城市里 GNSS 常错几米,航点可能落在马路上,而且航点不知道“必须走斑马线”这种规则。
- 视觉语言导航(VLN,按文字指令走):多在室内仿真里研究,真机上通常只演示一句短指令。作者发现它们连单句原子指令都执行不稳(P.9 表 III)。
作者的办法是把问题拆开:一层只决定“现在该执行哪一句”,只需要粗略位置;另一层只负责“把这一句做好”,只需要相机。
方法
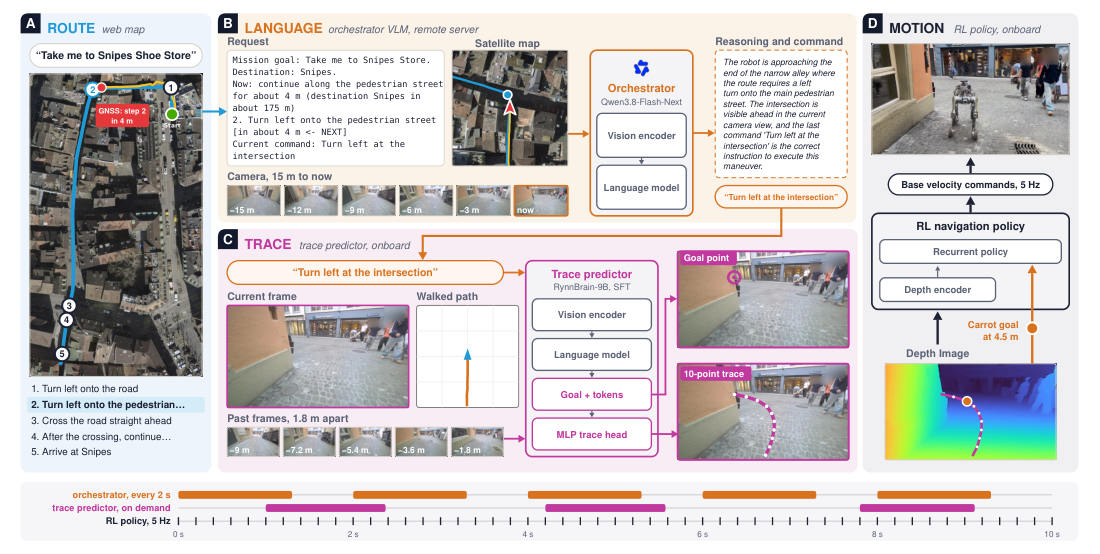
- 1查路线网页地图给出逐步文字路线
- 2选指令远程 VLM 每 2 秒给一条原子指令
- 3画轨迹机载模型在图像里画 10 点路径
- 4抬到3D用深度把路径投到可走地面
- 5跟着走RL 策略 5Hz 追 4.5 m 前的目标点
比喻:像一个坐在后座看地图的领航员(编排器)和一个只看前方路面的司机(轨迹预测器 + RL 控制)。领航员只说“下个路口左转”,不报坐标;司机自己看路决定怎么转。
1. 编排器 VLM(orchestrator):现成的 Qwen3.8-Flash-Next,不微调,跑在远程 4 张 H100 上,每次约 1.3 s。输入是附近几步路线文字、50 m 宽的卫星图(车头朝上)、过去 15 m 的相机图像和当前指令;输出一句理由加一条指令,如“过左边的斑马线到对面路沿”。GNSS 只用来判断“到了第几步”,提示词明确告诉它距离可能错 10–20 m,时机要看相机。机器人端还有几条手写规则拦截明显过早的指令(P.14 表 V)。
2. 语言条件轨迹预测器(trace predictor):基于 RynnBrain-9B 微调,输入当前图像、5 张相隔 1.8 m 的历史帧和走过路径的俯视图。它先生成一个“终点”像素坐标(约 15 个 token),再用一个小 MLP 头从隐状态直接回归 10 个轨迹点,省去解码约 140 个 token。先定终点是为了在岔路口先“选一边”,避免轨迹在两条路中间犹豫。历史帧让模型知道“转弯已经转完了”。
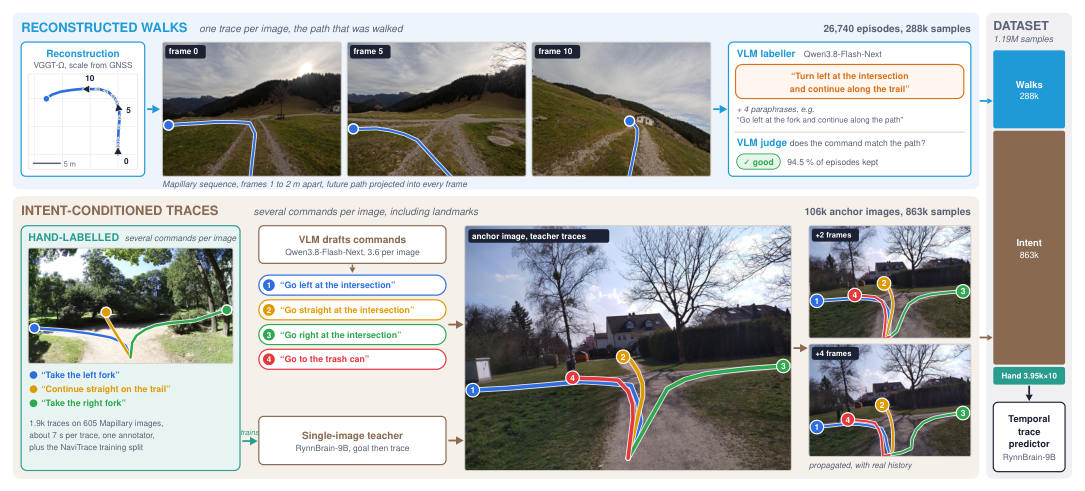
3. 训练数据:两部分。(a) 重建步行:用 VGGT-Ω 对街景序列做三维重建,把行人后来走过的路投回早先的图像,再让 VLM 写指令、另一个 VLM 审核,得 288k 样本。(b) 意图条件轨迹:同一张路口图配多条指令(左岔、右岔、去垃圾桶),由一个用人工标注训练的单图“老师”模型画轨迹,再借重建传播到后续帧,得 863k 样本。后者让模型学会“听指令”而不是只走最常见的路。
4. 执行:轨迹用深度抬到 3D,只保留落在可走地面上的部分;RL 导航策略追踪前方 4.5 m 的目标点并自己避障。三层异步运行,新指令生效前机器人继续沿旧路径走。
实验
本文方法 对比方法 · 数据来源:Table I, P.7
本文方法 对比方法 · 数据来源:Table VII, P.17
本文方法 对比方法 · 数据来源:Table XI, P.18
仿真闭环:作者在 Isaac Sim 里重建苏黎世老城(0.91 km²,123 个斑马线),10 条路线共 4.68 km,每条 3 个种子。成功 = 停在终点 5 m 内且每次过马路都走在斑马线上(越高越好);另报斑马线违规率和走上车道的比例(越低越好)。
- 完美 GNSS 下 WayTrace 成功率 83.3%;点目标基线 CityWalker 20.0%、VAMOS 13.3%、OmniVLA 0%;语言类基线即便用人工调好的“预言机”指令,也只有 3.3–6.7%(P.7 表 I)。
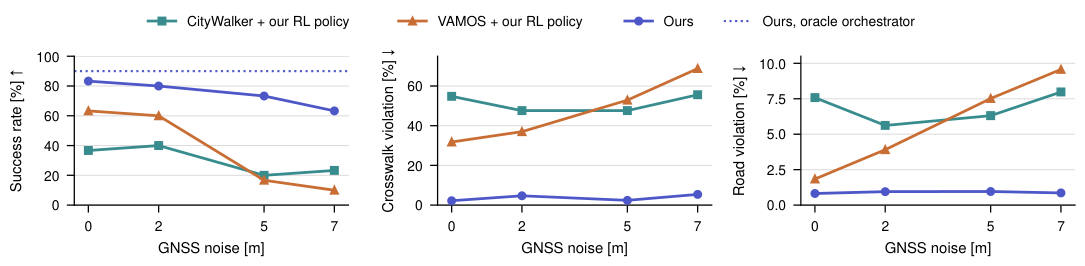
- 把基线的底层换成同一个 RL 策略后,CityWalker/VAMOS 升到 36.7%/63.3%,但斑马线违规率 54.8%/31.8%,WayTrace 为 2.2%(P.17 表 VII)。这一组对比最公平。
- GNSS 误差加到 7 m(RMS),WayTrace 从 83.3% 降到 63.3%,基线降到 23.3% 和 10.0%(P.7–8,图 5)。WayTrace 的失败多是编排器转弯时机或路口选错。
- 用预言机替换编排器,成功率从 83.3% 升到 90.0%,说明瓶颈主要在编排器。
开环轨迹:人工标注测试集上 NaviTrace 分数(越高越好)83.2,基线最高 57.0;转弯方向正确率 97.9%(P.9 表 III)。
消融:加历史帧后单指令闭环成功率 74.7%→94.7%(P.18 表 XI);意图条件数据从 0 加到 863k,NaviTrace 分数 79.3→83.3 单调上升(P.18 表 X)。编排器换成更强的商用模型,关键错误率从 5.1% 降到 3.2%,但每次调用慢 3–5 倍(P.9 表 IV)。
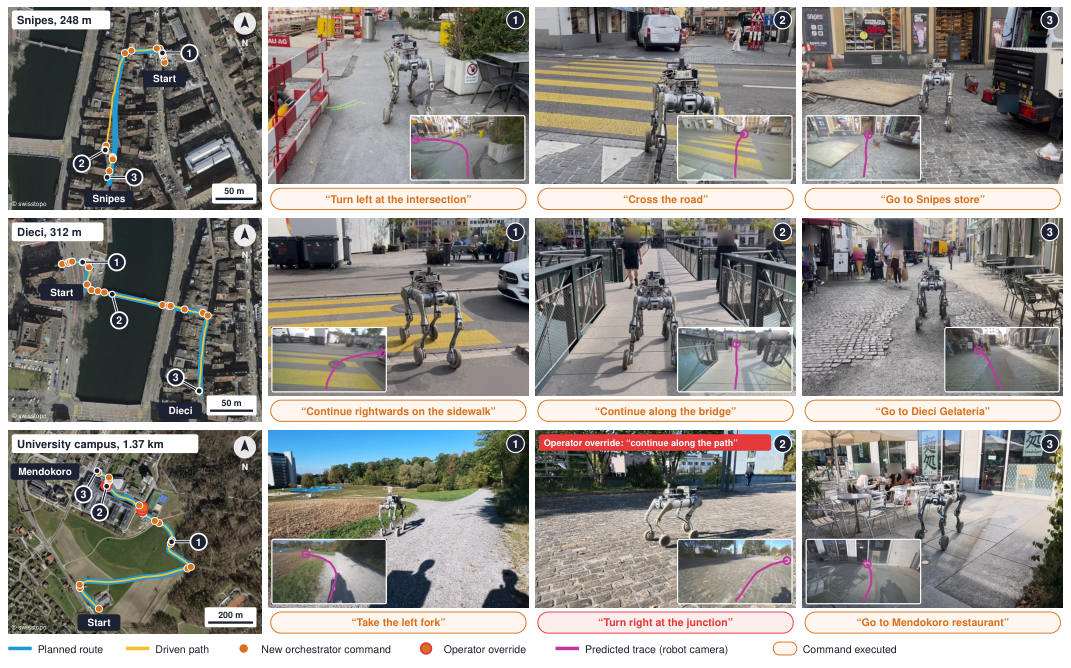
真机:4 条苏黎世任务 248 m–1.37 km,平均速度约 1.0–1.2 m/s;3 条城市任务零干预,1.37 km 任务有 2 次操作员改发语言指令(P.8 表 II)。
代价:一条新指令从拍图到生效约 3 s,约等于 3 m 路程;因此无法应对红灯或电车这类需要秒级反应的情况。
要点 Take-home
- 把路线拆成看得见的原子指令再画成图像路径,比追 GNSS 航点稳得多
- GNSS 误差 7 m 时成功率仍有 63%,基线跌到 10–23%
- 给轨迹模型加历史帧,转弯后不再打转,闭环成功率 75%→95%
- 剩余失败主要来自编排 VLM 的时机判断,每次决策约 5% 关键错误
Claude 读完全文后的提炼。
更多:先读哪 · 值得看的理由 · 质疑
先读哪
先看第 4 页图 2(整体分层),再看第 7 页表 I 和第 8 页图 5(GNSS 噪声下的对比)
值得看的理由
- 完整的“远程 VLM 决策 + 机载轨迹 + RL 跟踪”异步分层在真机上跑通,4 条城市/校园任务最长 1.37 km,只有 2 次由操作员改发语言指令的干预 → P.8 表 II
- GNSS 误差 7 m 时成功率仍 63.3%,点目标基线降到 23.3% 和 10.0%,且离开斑马线/人行道的次数约少十倍 → P.7 第 V-B, Fig. 5 节
质疑
- 闭环对比只在作者自建的 10 条仿真路线上做,仿真里没有行人和车辆,真机任务是无基线的定性演示 → P.11 第 VI 节
审稿人笔记
编排器依赖机器人端几条手写护栏规则(P.14 表 V),复现时别漏掉。