Type 1 · Directly applicable 证据 C 收录
Caging Vision-Language Navigation for Legged Robots via Barrier-Certified Safety Architecture
发布 · 收录于 2026-11-05
不改大模型,只在它和腿式机器人之间加一层带碰撞证明的规划“笼子”,就能让语言导航在真机上基本不撞。
- 任务
- 语言指令导航(VLN)的安全执行
- 硬件
- Unitree G1 人形、Ghost Vision 60 四足,均带 LiDAR
- 语义前端
- ChatGPT、Gemini、Claude、NaVILA
- 主要数字
- 12 m 场地长任务碰撞 60/60 → 0/60
- 代码
- 论文未提及开源
证据等级 C · 单一基准或无代码 (A 真机 + 多基准 + 消融 / B 仿真充分 / C 单一基准或无代码)
动机
大模型(VLM,看图懂话的模型;VLA,直接输出动作的模型)能听懂“出门左转停在自行车旁”,但它给出的动作不考虑机器人有多宽、眼前障碍在哪,直接执行容易撞。
已有的安全化做法要么重新训练模型(如 SafeVLA),要么针对机械臂操作。作者想要的是:不碰大模型本身,在它后面加一层专门管“别撞”的模块,而且这层模块能换机器人、换模型都照用。作者把这种做法叫“关进笼子”(caging)。
方法
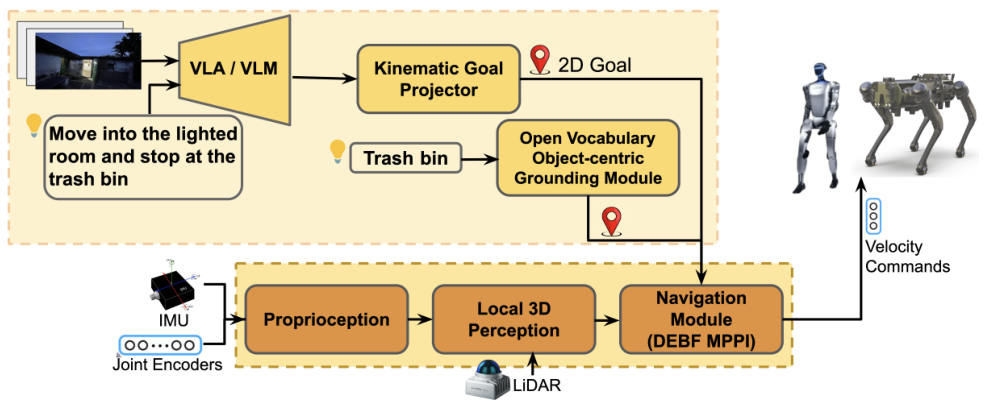
- 1听指令VLM 输出转向或前进等离散动作
- 2投目标动作变成目标点,避开障碍 0.3 m
- 3建距离场LiDAR 增量更新 SDF 距离场
- 4采样规划MPPI 采样 200 条平滑轨迹
- 5安全审核只执行满足 dEBF 的轨迹,否则停
- 6找物体可选:检测分割目标后靠近停下
比喻:大模型像坐在副驾驶的导游,只说“往前走、左转”;真正握方向盘的是一个谨慎的司机,他只采纳不会撞车的建议,实在不行就踩刹车。
1. 目标投影器(Kinematic Goal Projector):VLM 每次输出“左/右转 15°-45°”或“前进 25-75 cm”这类动作,模块把它换成地图上的目标点。若该点离障碍不足 0.3 m,就在附近找一个兼顾“离原目标近、朝向不乱转、离障碍远”的替代点(P.3 式 2)。
2. 低维 MPPI 规划:MPPI(模型预测路径积分)是一种随机撒很多条候选轨迹、按代价加权平均的规划方法。这里每条轨迹的速度指令用少量 Bézier 控制点描述,维度低、指令天然平滑。地图用 SDF(有符号距离场,每个位置存“离最近障碍多远”)表示,只查数值、不求梯度。
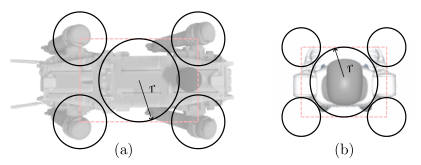
3. dEBF 安全约束:把机器人近似成几个圆(P.4 图 2),每个圆到最近障碍的距离减去半径就是“屏障值” h。离散指数屏障条件要求下一步的 h 不小于当前 h 乘以 γ(实验取 0.95):离障碍越近,允许靠近的速度就越小,所以机器人会提前减速而不是冲到边上才躲。规划时它先作为软代价引导采样,执行前再作为硬条件逐条审核;全不合格就用“速度为零”的后备动作。作者据此证明:在平面模型、地图完整、跟踪无误差等假设下,机器人永远不撞(P.4 定理 1)。注意这个证明依赖“原地停一定安全”,地图里没看到的障碍它管不了。
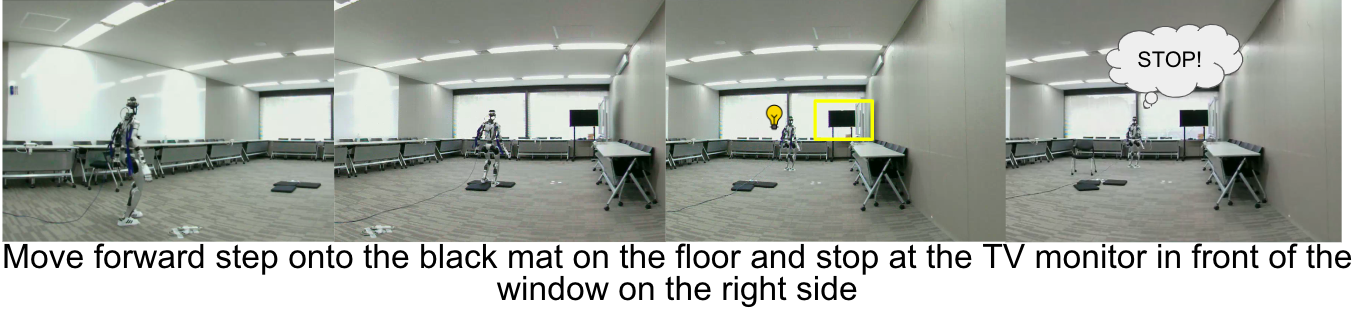
最后可选一个找物体模块:用 GroundingDINO 检测、SAM2 分割用户说的物体,投到 3D 后靠近到 0.5 m 停下。
实验
本文方法 对比方法 · 数据来源:Table III, P.7
本文方法 对比方法 · 数据来源:Table II, P.7
指标:碰撞率 CR(越低越好)、任务成功率 SR(越高越好)、端到端成功率 E2E SR(完成任务且不撞,越高越好)、终点误差 NE(米,越低越好)。
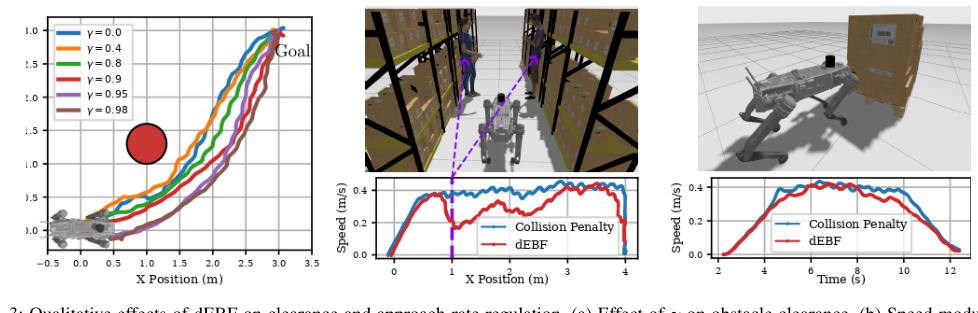
仿真(Gazebo):γ 越大绕障越保守;窄道里 dEBF 会随间距变小而减速,普通碰撞惩罚 MPPI 则几乎不减速(P.6 图 3)。
G1 4×4 m 对照实验(每个前端 5 次):不开全局规划 JPS 时,汇总 CR 从 80% 降到 0%;开 JPS 并突然放入新障碍时,CR 从 100% 降到 0%,E2E SR 从 0% 升到 70%(P.7 表 I、II)。成功率仍取决于大模型本身,例如 Claude 前端在表 I 中不撞但也没完成任务。
G1 6×6 m 与 Vision 60 室内外:G1 每种配置 75 次,CR 降到 0 而 SR 保持 0.75;Vision 60 复杂任务 CR 从 0.91 降到 0.08(P.7 表 III)。Vision 60 剩余碰撞多来自细电线、桌边、细杆和老款 VLP16 雷达盲区。
G1 12×12 m 长任务:四个前端各 15 条指令,无笼 60/60 次碰撞,有笼 0/60(P.7 表 IV)。物体定位模块把 Vision 60 终点误差从 1.50 m 降到 0.29 m,但只有 5 和 3 个终点(P.7 表 V)。
代价:每步 200 条样本、10 次迭代、2.5 s 预测时域,跑在 NVIDIA A4500 上;论文没有报告规划耗时。样本量小(每格 5 次),无标准基准,结论应视为初步。
要点 Take-home
- 让大模型只给目标,由几何安全层负责执行,换模型换机器人都能用
- 加 dEBF 后真机碰撞率大幅下降,G1 上降到 0 且成功率不变
- 安全层只防撞,选错目标、听错指令仍要靠大模型自己
- 证明依赖地图完整,细电线、雷达盲区里的障碍仍会撞上
Claude 读完全文后的提炼。
更多:先读哪 · 值得看的理由 · 质疑
先读哪
先看第 2 页图 1 的整体结构,再看第 7 页表 III 和表 IV
值得看的理由
- 把 VLM/VLA 输出当“提议”,由独立的几何安全层执行,换模型、换机器人都不用改安全层 → P.3 第 III-B, Fig. 1 节
- 人形和四足两台真机、四个语义前端都做了开/关对比,长任务碰撞从 60/60 降到 0/60 → P.7 表 IV
质疑
- 表 IV 的“无笼”基线同时关掉 MPPI、JPS 和 dEBF,等于直接执行 VLM 指令,100% 碰撞主要说明需要局部规划器,而非 dEBF 本身更好 → P.6 第 VI-E 节
审稿人笔记
有两台真机的开关对照,但每格仅 5 次、无标准基准、未提代码,证据按 C 计。