Type 1 · Directly applicable Must-read 证据 B 收录
FEIJOA: Task-Driven Grounding and Execution for Mobile Manipulation
发布 · 收录于 2026-11-05
移动操作中,应在收到指令后按任务直接查原始 RGB-D 扫描来找物体,并在每个技能前后做可行性检查和效果核验,而不是依赖事先建好的场景表示。
- 任务
- 开放语言指令下的长程移动操作(拿、放、推、擦)
- 数据
- 自建 4 个场景 103 条定位查询;Spot 真机 50 个任务
- 硬件
- 带机械臂的 Spot 四足(另在 RB-Y1 上演示)
- 代码
- 有项目主页,正文未提代码发布
- 主要数字
- 定位精确命中 94.2%;真机成功 35/50
证据等级 B · 仿真充分 (A 真机 + 多基准 + 消融 / B 仿真充分 / C 单一基准或无代码)
动机
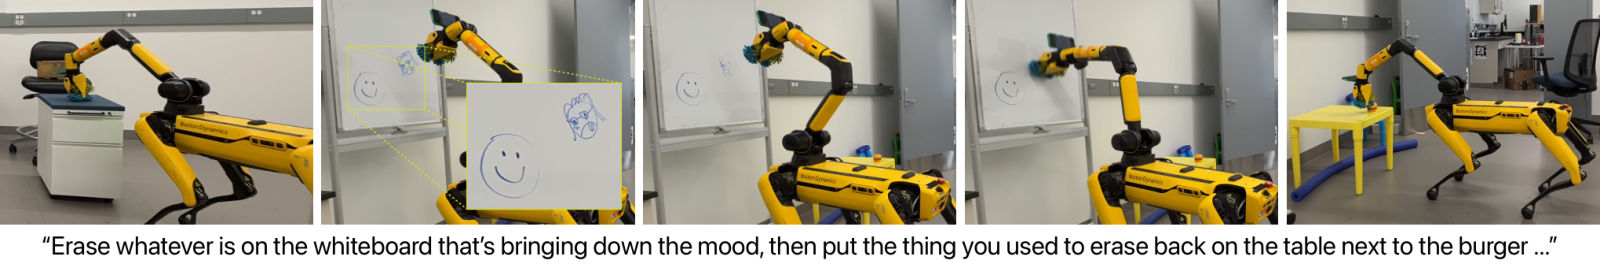
一句“把玩具收进玩具箱”,机器人要先判断哪些是玩具、用户指的是哪个箱子,再找到能站、能抓、能放的位置(P.1)。
常见做法是先建图、后提问:事先把场景做成开放词汇物体地图或 3D 场景图(scene graph,用节点和边记录物体及其关系),每个物体只留一个嵌入向量或一段文字描述。问题在于建图时还不知道任务,“最花哨的物体”“系领结的毛绒玩具”这类细节往往没被记下(P.2)。另外,“哪里够得着”取决于机器人自身的身体结构,也很难提前算全(P.3)。
第二个难点是执行:底层技能常常失败,智能体若不知道失败,就会把没完成的步骤标成完成,继续往下做(P.7)。
方法
- 1录扫描事先录一段带位姿的 RGB-D
- 2定计划LLM 拆出带完成标准的子目标
- 3现场找物按任务提问,检测+聚类+VLM 复核
- 4选站位采样不碰撞且够得着的底盘位姿
- 5执行核验VLM 裁判比对动作前后两张图
- 6调整失败则重导航、重试或改计划
比喻:预建场景图像一本提前写好的目录,只记了每样东西的大概;本文的做法是保留原始“录像”,接到任务后带着具体问题回去翻录像,找不到就换个问法再翻。
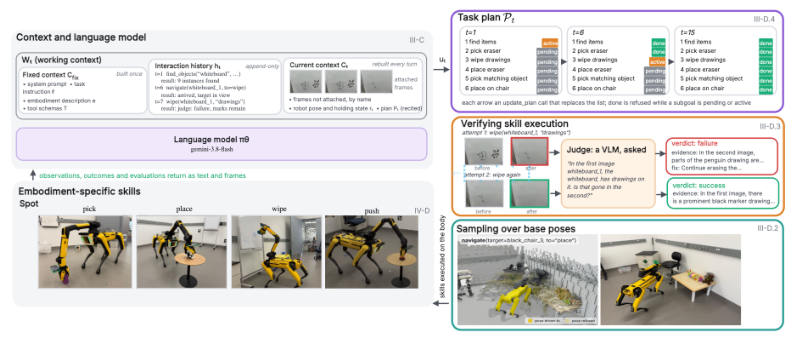
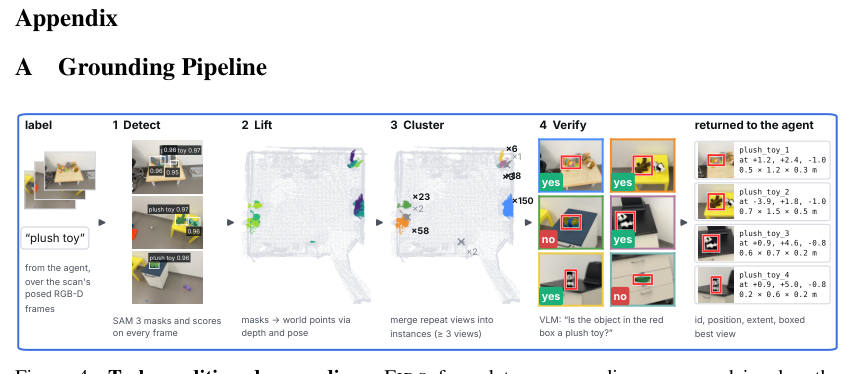
1. 任务驱动的定位(FIDO):智能体用的大模型是 Gemini-3.8-Flash(P.4)。它把指令拆成若干查询词(如“毛绒玩具”“垃圾桶”),调用 find_objects 工具。工具在每帧图像上用 SAM 3(按文字提示分割物体的模型)找物体,用深度和相机位姿把掩码投到 3D,把多视角看到的同一物体合并(至少 3 次检测才保留),再用本地 Qwen3-VL-8B 看框选图确认“这是不是毛绒玩具”(P.12)。返回每个候选的编号、3D 位置、尺寸和最佳视角图。智能体看完结果可以比较位置、换词再查,例如先找玩具和椅子,再挑离椅子最近的玩具(P.5)。
2. 懂身体的执行框架(harness):每个技能都有前提条件和预期效果。执行前,从扫描生成二维占据栅格(occupancy grid,标出哪里能走),采样朝向目标的底盘位姿,只保留不碰撞且手臂够得着的;一个都没有就拒绝执行并说明原因(P.5)。执行后,另开一个干净上下文的 Gemini-3.6-Flash 当裁判,只看“预期效果的陈述 + 动作前后两张图”,判成功、失败或不确定,并可给修正建议(P.5-6)。
3. 持续的任务计划:计划是“子目标 + 完成标准 + 状态”的列表,由 LLM 通过 update_plan 修改,框架检查后保存,每一步都放进上下文(P.4)。另有 estimate_cost 工具比较不同访问顺序的导航代价(P.4)。
实验
本文方法 对比方法 · 数据来源:Table 1, P.6
本文方法 对比方法 · 数据来源:Table 2a, P.7
本文方法 对比方法 · 数据来源:Table 4, P.14
定位实验(P.6 表 1):4 个场景、103 条查询,类型包括物体类别、属性、空间关系、多目标集合和需要推理的(否定、功能、比较)。指标是精确命中率 Exact(全部目标找到且无误报,越高越好),人工判定。本文 94.2%,最好的基线 TextMap(把物体地图写成文字场景图再让 LLM 回答)68.0%,只调一次 find_objects 不加智能体是 47.6%。代价是慢:每条查询 29.5 秒、3.1 美分,TextMap 8.5 秒、1.4 美分(P.6)。
但要注意附录表 4(P.14):把整段扫描所有帧一次性交给 Gemini 3.8 Flash,精确命中 96.1%,每条 16.7 秒,比本文更准更快。作者的解释是这类做法只返回一个 3D 点、没有尺寸,而且扫描变大后上下文装不下(P.13)。所以站得住的结论是“在原始观测上按需定位优于预建表示”,而不是“本文的智能体流程优于强 VLM”。
执行框架消融(P.7 表 2):① 20 个真实失败的放置/擦除步骤回放,只给状态文字时智能体漏判 9 次,加前后图 6 次,再加裁判结论 2 次(越低越好)。② 去掉可达位姿采样,柜子场景成功从 5/5 降到 2/5,泰迪熊场景降到 1/5。③ 去掉 estimate_cost,10 条导航指令平均多走 9.8%、多花 12.3% 时间(p=0.039 / 0.020)(P.8)。
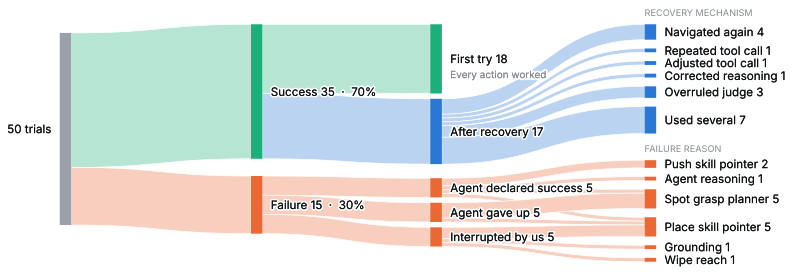
Spot 真机(P.8 表 3):50 个任务成功 35 个(70%),短/中/长任务分别为 81%、67%、62%。35 个成功里 17 个是先失败再恢复的,最常见的办法是重新导航(P.7 图 3)。15 个失败中 13 个来自抓取规划、放置等底层技能,只有 2 个来自定位或推理。平均每个任务 5.2 分钟、20.9 次工具调用、0.58 美元;41% 的时间花在 LLM 调用上,每次约 7 秒(P.8)。
要点 Take-home
- 接到任务再去原始扫描里找物体,比预建场景图准得多:94.2% 对 68.0%。
- 让独立 VLM 裁判比对动作前后图,漏判的失败从 9/20 降到 2/20。
- Spot 真机 50 个任务成功 35 个,失败多半出在抓、放等底层技能。
- 代价是慢;而把整段扫描直接交给强 VLM,精度还略高一点。
Claude 读完全文后的提炼。
更多:先读哪 · 值得看的理由 · 质疑
先读哪
先看第 3 页图 2,再看第 6 页表 1 和第 14 页表 4
值得看的理由
- 103 条开放查询上精确命中 94.2%,比最好的预建场景图(TextMap,68.0%)高 26 个点 → P.6 表 1
- 可行性采样、效果核验、代价估计三个执行模块都有消融,并对 50 次 Spot 试验逐条归因失败 → P.7 表 2, Figure 3
质疑
- 附录中把整段扫描直接交给 Gemini 3.8 Flash,精确命中 96.1%,高于本文 94.2% 且更快,智能体反复查询本身的增益未被证明 → P.14 表 4
- 消融样本很小(每个场景 5 次、10 条导航指令),且假设环境只因机器人动作而改变 → P.7 表 2; Sec. 3.1 (P.3)
审稿人笔记
正文称也部署在 RB-Y1 上,但全文只给出 Spot 的定量结果。