Type 1 · Directly applicable 证据 B 收录
TAMPAgent: Agentic Belief-Space Planning for Mobile Manipulation
发布 · 收录于 2026-11-04
让大模型 agent 充当信念空间策略写计划,由 TAMP 规划器把计划编译成约束、工具认证后才执行,能在部分可观测的家庭移动操作中明显胜过直接写代码调工具的 agent。
- 任务
- 家庭移动操作:找被挡住的物体、挪开障碍、取放
- 机器人
- Rainbow RB-Y1 轮式双臂、Unitree G1 人形(仿真为主,真机演示)
- 模型与工具
- Codex + GPT-6-Astra;SAM 3、GraspGenX、cuRobo
- 代码
- 有项目主页,文中未提供代码
- 主结果
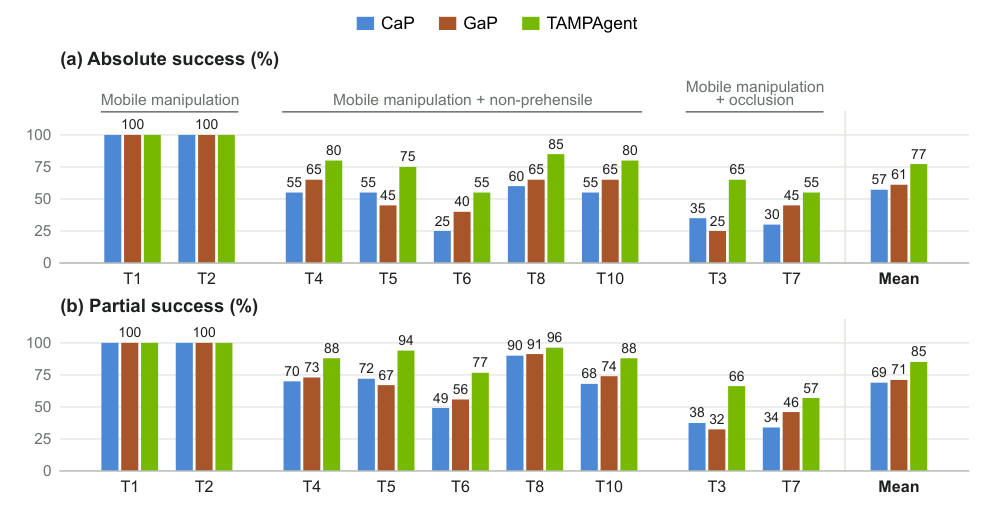
- RB-Y1 厨房任务平均成功率 77.2%(CaP 57.2%,GaP 61.1%)
证据等级 B · 仿真充分 (A 真机 + 多基准 + 消融 / B 仿真充分 / C 单一基准或无代码)
动机
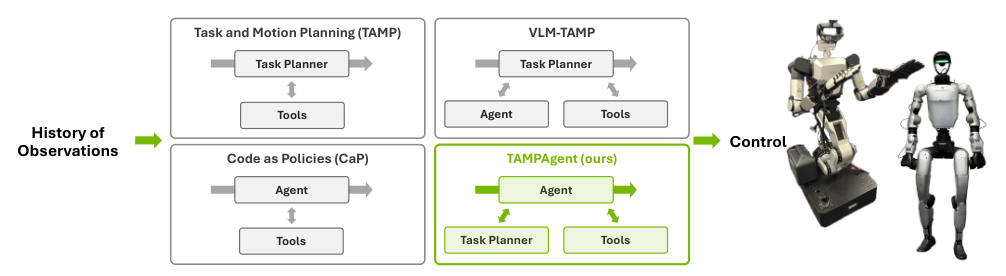
家里的机器人常常看不全:苹果可能在冰箱里、被盒子挡住,或者杯子挡住了所有抓取方向。
- 直接调工具的 agent(如 Code as Policies,CaP:让大模型写程序直接调用感知和控制)有常识,但调用工具时不显式表示每个动作必须满足的几何约束,换到新任务时常常失败(P.1)。
- TAMP(任务与运动规划:先定动作顺序,再求抓取、位姿、轨迹等连续参数)能在执行前验证计划,但需要人写好问题、场景完全已知(P.1)。
- 信念空间 TAMP(在“状态的概率分布”上做规划)能处理看不全,但分布表示和推断过程复杂、谓词和动作词汇固定(P.1、P.10)。
难点在于:既要大模型的开放世界常识,又要规划器“先验证再动手”的保证。
方法
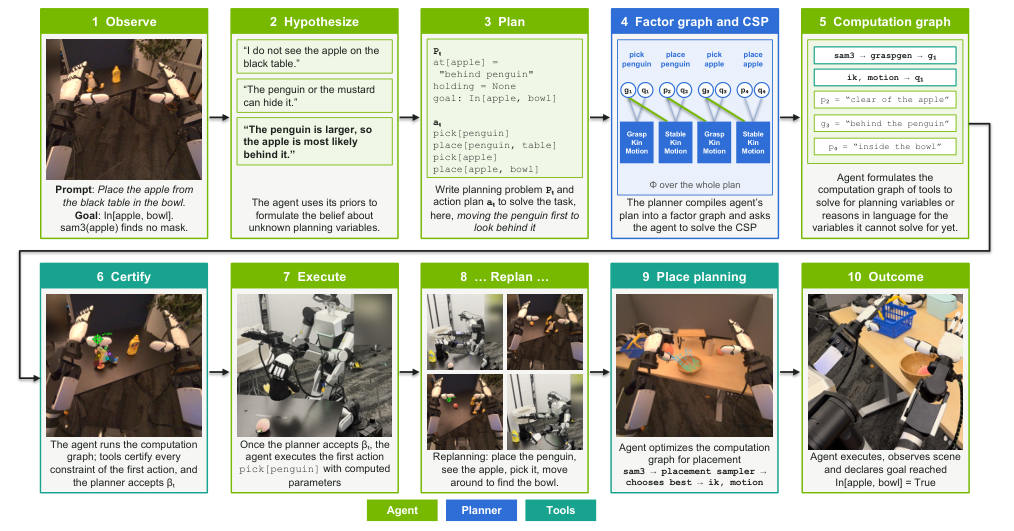
- 1观察与假设agent 用语言写出物体可能在哪
- 2写问题和计划列出物体、目标和动作序列
- 3编译约束规划器把计划变成约束问题
- 4工具认证分割、抓取、运动规划给出合格参数
- 5执行一步只执行第一步,观察后重新规划
比喻:agent 像会猜的项目经理,负责提方案;规划器像审批处,把方案拆成一条条必须满足的条件;工具像质检员,逐条盖章。没盖齐章,机器人一步也不准动。
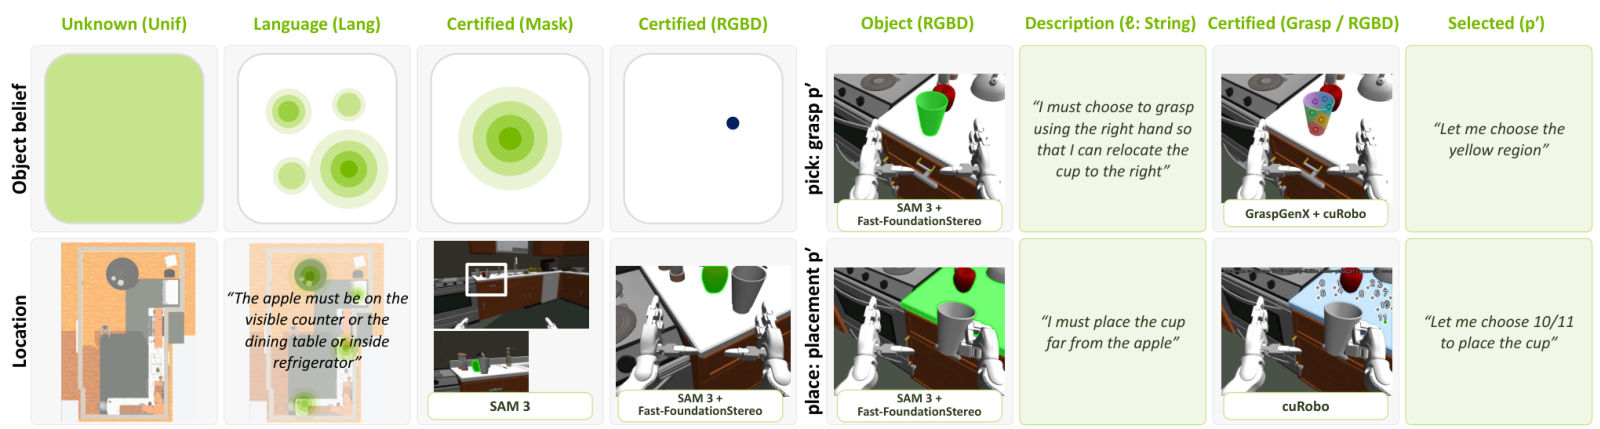
1. 混合信念(hybrid beliefs):每个变量(物体位置、抓取、放置点)的“信念”可以是三种形式之一:什么都不知道(均匀分布)、agent 写的一句语言假设(如“苹果多半在企鹅玩偶后面”)、或工具算出并认证过的连续值(分割掩码、RGB-D 位姿估计、抓取、关节构型、轨迹)。语言假设让 agent 不用对概率分布做积分就能隐式权衡风险,真正驱动电机的参数必须是工具认证过的(P.4)。
2. 带类型的三种动作:detect(走到某视角看物体)、pick、place。类型强制顺序:pick 只接受 RGB-D 形式的位置,所以必须先有一次成功的 detect(P.4–5)。
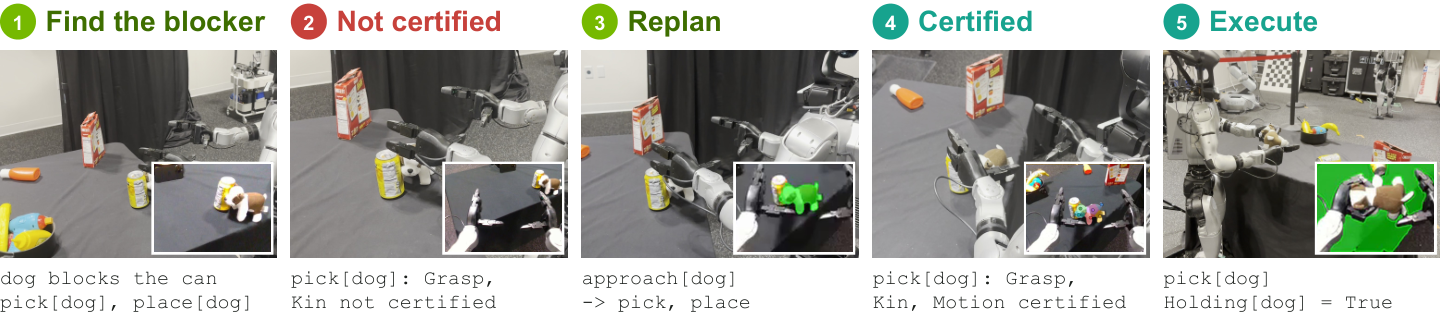
3. 规划循环:agent 写问题 P_t 和计划;规划器把整条计划编译成因子图(factor graph,变量是节点、约束是连线)表示的约束满足问题(CSP);agent 写一小段 Python 调用工具,只给第一步绑定参数,后面的变量先留语言描述;全部约束认证通过才执行,然后重新观察、重写计划。认证失败时会指出是哪条约束不满足,agent 依次尝试:换候选/换视角 → 换计划 → 换假设(P.5–6)。例如拿着苹果却够不到碗里,Kin(运动学可达)约束返回空,agent 就加一步“走近碗”(P.21)。
实验
本文方法 对比方法 · 数据来源:Figure 7(a) Mean, P.8;数值见 Sec. 1, P.2
本文方法 对比方法 · 数据来源:Figure A2 与 App. D 正文, P.25
本文方法 对比方法 · 数据来源:Figure 10(b), P.10
设置:MuJoCo 仿真,RB-Y1 在一个厨房里做 T1–T10(找苹果放到盘子上,含遮挡和挡路),另有三房间任务 T11–T13;每任务每方法 20 次(三房间 5 次)。G1 人形在 T1–T6 上各跑 5 次。基线 CaP 和 GaP(Graph as Policy,让辅助 agent 写并审核工具调用图)在同一套机器人、工具、模型和沙盒上实现(P.7、P.30–31)。
指标:绝对成功率、部分成功率(完成子任务比例),越高越好;每分钟仿真时间的 token 用量,越低越好。
结果: - 平均绝对成功率 77.2%,CaP 57.2%,GaP 61.1%(P.2)。苹果就在眼前的 T1、T2 三者都是 100%(P.8)。 - 遮挡任务(冰箱里 T3、盒子后 T7):本文 20 次里分别 14、13 次找到苹果,CaP 和 GaP 都是 9、10 次(P.8)。 - 需要先挪障碍的 5 个任务:75% 对 50%(CaP)和 56%(GaP);超时次数 16 对 30 和 33(P.9)。 - 三房间任务三种方法一样:T11、T12 都 5/5,T13 都 4/5(P.9),说明简单长距离搬运不是优势所在。 - G1 上平均绝对成功率从 CaP 的 6.7% 升到 53.3%,部分成功率从 30.3% 到 76.6%(P.25)。
代价:每分钟仿真时间本文用 19.3k 输入 / 1.75k 输出 token,CaP 为 20.3k / 1.91k,GaP 为 27.4k / 2.73k(P.9)。真机演示每回合 token 从简单取放的 376k/39k 增到找隐藏物体的 973k/127k(P.10)。
站得住的结论:在“需要假设和多步依赖”的任务上,结构化表示带来的增益一致且跨两种机器人。局限:没有逐模块消融;真机无成功率统计;作者承认概率未标定,agent 有时在该动手时还在搜索,这是它多数超时的原因(P.11)。
要点 Take-home
- 让 agent 写计划、工具先认证再执行,比直接写代码调工具成功率高约 20 个点。
- 收益集中在物体被遮挡或被挡住的任务,简单取放三种方法都满分。
- 结构化的问题描述让 agent 少翻文档、少写代码,token 反而更省。
- 保证只到工具和感知正确为止;概率未标定,有时过度搜索导致超时。
Claude 读完全文后的提炼。
更多:先读哪 · 值得看的理由 · 质疑
先读哪
先看第 5 页图 4 的十步流程,再看第 8 页图 7 的成功率和第 31 页表 A6 的基线差异
值得看的理由
- 同模型同工具下,只换成“计划+约束认证”的表示,9 个厨房任务平均绝对成功率 77.2%,高于 CaP 57.2% 和 GaP 61.1% → P.2 第 1;Figure 7(a), P.8 节
- “语言假设→掩码→RGB-D”的混合信念给出了一个可落地的接口:先猜物体在哪、挪开障碍、再取放 → P.4 图 3, Sec. 3.1
质疑
- GaP 基线去掉了预演、检查点和自带技能库,且本文 agent 多拿到规划相关的手册页,提升不全来自表示本身 → P.31 App. H, Table A6
- 真机只有演示和 token 统计,没有成功率;也没有拆掉语言假设或约束认证的消融 → P.10 第 4 Real-world experiments 节