Type 1 · Directly applicable Key group 证据 B 收录
SNAP: Semantic Navigation Among Pedestrians
发布 · 收录于 2026-11-04
用一张同时画着地面语义和行人的机器人中心鸟瞰图做输入,单个 RL 策略就能既避开人群又守住人行道,并零样本迁移到四足机器人。
- 任务
- 城市场景中的语义约束人群导航(Crowd Navigation)
- 训练环境
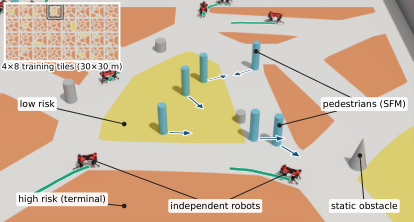
- 程序生成的 30×30 m 场景,社会力模型驱动行人
- 硬件
- ANYmal-D 四足 + LiDAR,策略 10 Hz
- 代码
- 承诺开源,已有项目页
- 主结果
- 20 个行人时成功率 0.818,DRL-VO* 为 0.504
证据等级 B · 仿真充分 (A 真机 + 多基准 + 消融 / B 仿真充分 / C 单一基准或无代码)
动机
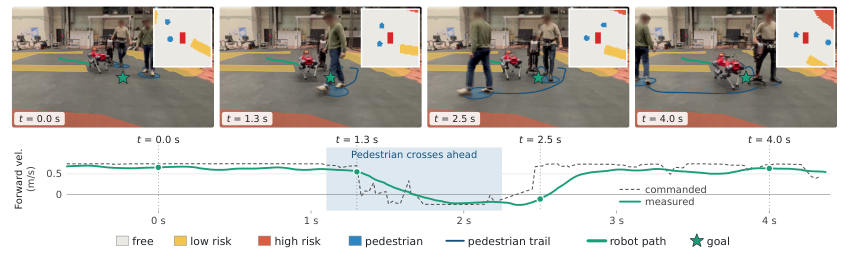
机器人在城市里走,既要躲开行人,又要守社会规则(比如走人行道、别上马路)。
现有方法通常只管一半: - 人群导航(Crowd Navigation)方法如 SARL、DRL-VO 需要每个行人的位置和速度。真实人群里遮挡多,跟踪容易出错,而且它们把所有空地看成一样能走。 - 语义规划方法如 ViPlanner 会看地面类别,但默认环境是静止的,遇到行人只能靠简单的反应规则。
作者想用一个策略同时解决这两件事(→ P.1-2)。
方法
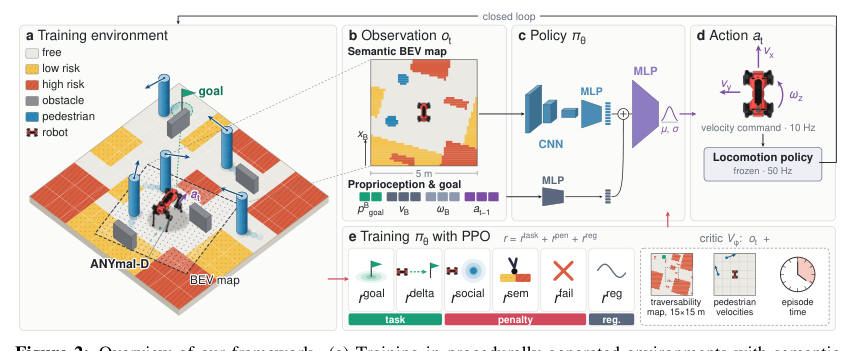
- 1截地图在预建语义地图里定位,截出 5×5 m 鸟瞰图
- 2画行人激光检测行人,直接投进鸟瞰图
- 3出指令CNN+MLP 策略输出速度指令,10 Hz
- 4走起来冻结的步态策略以 50 Hz 跟踪速度
- 5仿真训练随机行人群 + PPO + 带特权信息的评论家
比喻:像一个低头看手机地图过马路的人——地图上既标了哪里是人行道、哪里是车道,也实时标出身边的人。他不用记住每个人的速度,只看“人在图上的位置分布”就决定怎么走。
关键模块: 1. 语义鸟瞰图(BEV, bird's-eye-view,从上往下看的俯视栅格图):以机器人为中心,每格标为可走、低风险、高风险、障碍或行人。策略的“眼睛”只有这张图加上本体信息和目标方向,不给行人的位置/速度(→ P.2-3 表 1)。 2. 非对称 actor-critic:负责出动作的 actor 只看机载可得的信息;负责打分的 critic 在训练时额外看到 15×15 m 的可通行图和行人速度。这样训练更稳,部署时又不依赖这些特权信息(→ P.2 图 2e)。 3. 奖励设计:到达目标的奖励 + 每步靠近目标的奖励;离行人越近罚得越多(指数衰减),踩到高风险地面罚分,全部脚踩进禁区或碰撞则失败;再加若干让动作平滑的正则项。行人数量用课程(curriculum)逐步加多(→ P.3 表 2)。
训练中的行人用随机参数的社会力模型(SFM, Social Force Model)驱动,会成群走、也会对机器人减速,以免策略只学会应付一种固定的人群行为(→ P.2)。
实验
本文方法 对比方法 · 数据来源:Table 3, P.4
本文方法 对比方法 · 数据来源:Table 3, P.4
本文方法 对比方法 · 数据来源:Table 5, P.7
指标:成功率(SR,越高越好),每个设置 500 个回合,机器人到达目标 0.5 m 内算成功。
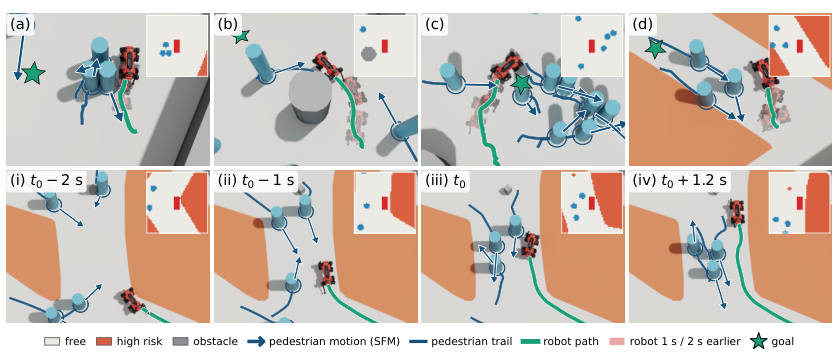
三组对比(→ P.3-4 表 3),每组都另外在本文仿真里重训了基线(带 * 号): - 纯人群、无障碍:对比 SARL。行人速度 0.5 m/s 时,本文 0.932,SARL* 0.592;1.3 m/s 时本文 0.586,SARL* 0.384。 - 人群 + 静态障碍:对比 DRL-VO。20 个行人时本文 0.818,DRL-VO* 0.504。作者认为 BEV 保留了几何结构,而且是 360° 视野。 - 语义地形:对比 ViPlanner。无行人时本文 0.960,ViPlanner 0.804;16 个行人时 ViPlanner 掉到 0.580,本文 0.826。只看前方 90° 的版本 Ours* 为 0.762,说明全向视野有用。
附录分析(→ P.7 表 4-5):行人从 10 增到 16,SR 只从 0.820 降到 0.732;但行人速度从 0.5 升到 1.3 m/s,SR 从 0.844 掉到 0.452。原因是 5×5 m 的视野太小,快的人一进图就到眼前。
真机:ANYmal-D 上 10 Hz 运行,用 Open3D SLAM 在预建语义地图中定位,激光检测行人。图 1 展示了机器人为横穿的行人减速、短暂后退再继续前进;没有给出真机统计数字(→ P.4)。
要点 Take-home
- 把行人和地面语义画进同一张鸟瞰图,策略不跟踪行人也能避让。
- 20 个行人时成功率 0.818,比重训后的 DRL-VO 高约 0.31。
- 全向视野比前向 90° 更稳:有行人时 0.826 对 0.762。
- 主要短板是只看 5×5 m:行人快到 1.3 m/s 时成功率降到 0.45。
Claude 读完全文后的提炼。
更多:先读哪 · 值得看的理由 · 质疑
先读哪
先看第 2 页图 2(整体框架),再看第 4 页表 3(三组对比)
值得看的理由
- 同一张语义 BEV 图同时编码地面类别和行人,三组仿真对比都明显胜过重训后的 SARL、DRL-VO、ViPlanner → P.4 表 3
- 策略以 10 Hz 零样本部署到 ANYmal-D,行人靠激光检测后直接投进 BEV,不需要行人轨迹跟踪 → P.4 第 4 末段 节
质疑
- 真机只有图 1 的定性演示,没有真机成功率;也没有对社会奖励、非对称评论家等设计做消融,附录只改了人数和速度 → P.7 Appendix Tables 4-5
审稿人笔记
真机依赖预建语义地图定位,机载实时语义建图尚未实现(作者列为后续工作)。