Type 1 · Directly applicable 证据 B 收录
Ray-SCR: Generalizing Scene Coordinate Regression Across Camera Models
发布 · 收录于 2026-11-04
给场景坐标回归(SCR)的每个局部特征配上它的标定视线方向,并在射线空间里训练,就能让一个用全景图建的地图模型准确定位针孔、鱼眼和全景相机拍的查询图。
- 任务
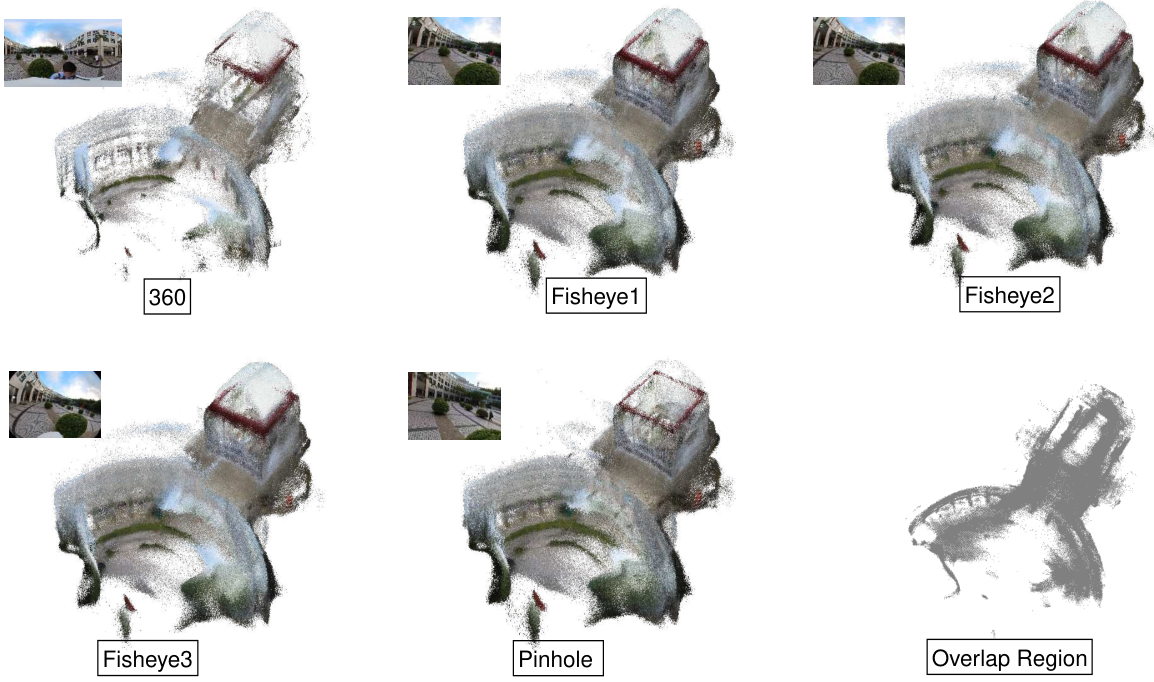
- 跨相机视觉定位:全景建图,针孔/鱼眼/360° 查询
- 数据
- 360Loc(主)、OmniScenes、Aachen
- 硬件
- 无真机闭环;离线数据集,RTX A5000 训练
- 代码
- 有项目页,论文未说明是否开源;WACV 2027
- 主要数字
- 360Loc Atrium 白天平均旋转误差 3.0°(CDG-Loc 14.5°)
证据等级 B · 仿真充分 (A 真机 + 多基准 + 消融 / B 仿真充分 / C 单一基准或无代码)
动机
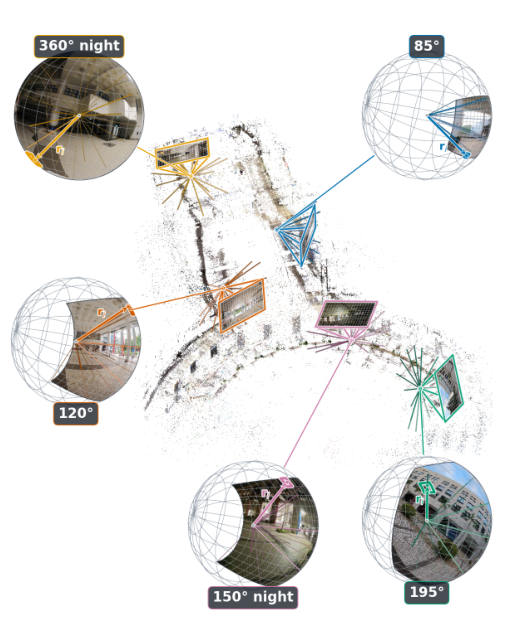
问题:场景坐标回归(Scene Coordinate Regression, SCR)是一种视觉定位方法:网络为图像里每块区域直接预测它在场景中的 3D 坐标,再用 PnP 解出相机位姿。它模型小、速度快、精度高(P.1)。
卡在哪:现有 SCR 默认针孔相机。鱼眼或全景图中,同一个物体出现在画面中心和边缘时形状、分辨率都不同,而 SCR 只看局部小块,不知道这块在画面里处于什么方向,于是换一种相机就定位不准(P.1-2)。
常见补救为什么不够:用渲染出的多种相机视角做数据增强有帮助,但网络仍然不知道每块特征的视线方向(P.2,表 5);把图转成立方体贴图(cubemap)会在边缘引入拉伸和重采样(P.3,表 6)。
方法
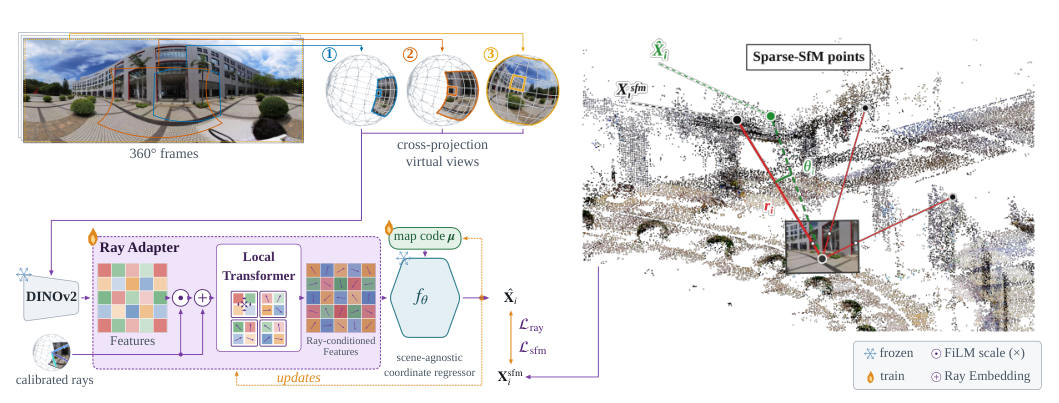
- 1算视线按相机标定把每个特征位置变成单位视线方向
- 2射线调制用 FiLM 把视线编码注入 DINOv2 特征
- 3局部注意8×8 邻域内单层 Transformer 互相修正
- 4回归坐标沿用原 SCR 头,为每个特征预测 3D 点
- 5射线监督角度误差 + 约 5% 的稀疏 SfM 锚点
- 6求位姿视线-3D 对应进 P3P + RANSAC
比喻:像给每张拼图碎片背面写上“我来自画面哪个方向”。同样一块墙角,在鱼眼边缘被拉弯,在针孔中间是正的;知道方向后,网络就能把两者认成同一个东西。
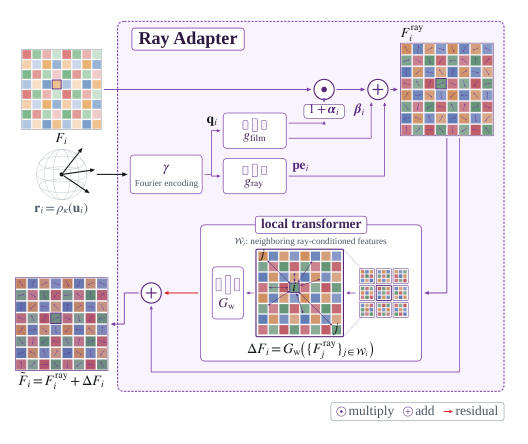
模块 1:射线适配器(Ray Adapter)。每个特征对应一条由相机标定算出的视线 r(单位向量)。视线先做傅里叶编码,再分两路:一路用 FiLM(Feature-wise Linear Modulation,按通道缩放和平移特征)调制视觉特征,另一路直接加一个射线嵌入。之后 8×8 邻域内的特征经过一层 4 头的小 Transformer 互相交流,学习“这个位置的畸变长什么样”(P.4-5,式 8)。适配器只有 0.9M-1.54M 参数,能接在 DSAC*、ACE、GLACE、ACE-G 任一前面(P.3,P.11)。
模块 2:在射线空间训练。预测出的 3D 点经已知位姿变回相机坐标后得到一个方向,与真实视线的夹角就是损失(式 10-11)。夹角不依赖投影模型,因此针孔、鱼眼、全景用同一个公式。另外约 5% 的特征位置配有 SfM 稀疏点作为“米制锚点”(式 12),把不同视角、不同相机看到的同一结构拉到同一个 3D 坐标上(P.4-5)。
模块 3:位姿求解。不再投影到图像平面,而是用视线-3D 对应和 OpenGV 的 bearing-vector P3P + RANSAC,再最小化角度误差做精修(P.5)。
实验
本文方法 对比方法 · 数据来源:Table 1, P.6
本文方法 对比方法 · 数据来源:Table 5, P.8
本文方法 对比方法 · 数据来源:Table 7, P.8
指标:360Loc 上报告中位平移误差(米)和中位旋转误差(度),越低越好;OmniScenes 和 Aachen 报告落在阈值内的查询比例(%),越高越好。
360Loc 主结果(P.6 表 1、表 2):对比绝对位姿回归方法 PoseNet、MS-Transformer 及其虚拟相机版本,以及跨设备方法 CDG-Loc(基线数字取自 CDG-Loc 论文)。Ray-ACEG 用一个场景模型定位五种相机,在全部 8 个场景×光照组合中旋转误差最低,平均平移误差 8 个中 6 个最低(Piatrium 白天、Atrium 夜晚输给 CDG-Loc)。论文称平均旋转误差降低 2 倍以上,窄视场针孔收益最大(P.7)。
换骨干(P.7 表 3):DSAC*、ACE、GLACE 加上射线后都能定位五种相机,ACE-G 版本最好;但表里没有不加射线的原版数字。
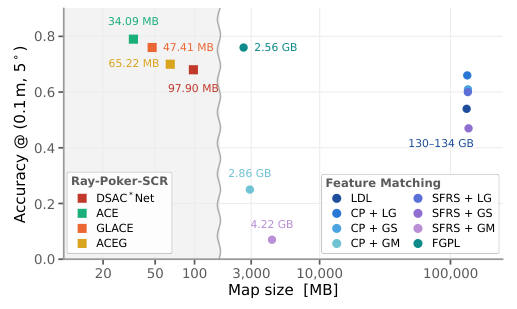
OmniScenes(P.7 图 5):机器人拍的全景建图、手持全景查询且场景被重新摆放过。Ray-Poker-ACE 的召回比 FGPL 高 3.9%,场景存储小 77 倍(34 MB 对 2.56 GB)。
Aachen(P.8 表 4):纯针孔但焦距各异的城市场景,(5 m, 10°) 内比例 ACE(N=50) 50.0% → Ray-ACE 80.1%,GLACE 64.0% → Ray-GLACE 72.3%。
消融(P.8 表 5-7,P.11 表 8):同等视角增强下 Ray-ACEG 始终优于 ACE-G;cubemap 方案在 360° 查询上反而比 Ray-ACE 好(3.1 m 对 5.0 m),但针孔和鱼眼差很多;去掉射线损失伤害最大。
代价:射线模块每张图多 1 ms(Ray-ACE)或 7 ms(Ray-ACEG);每个场景训练 7 万次迭代;需要准确的相机标定(P.11)。
要点 Take-home
- 把每个特征的标定视线喂给网络,同一 SCR 地图就能跨针孔、鱼眼、全景相机定位
- 360Loc 上平均旋转误差比 CDG-Loc 低一半以上,窄视场针孔查询收益最大
- 只做虚拟视角增强不够:同样增强下加射线条件,平均平移从 5.1 米降到 1.0 米
- 需要准确标定,每个场景仍要单独训练,中位误差仍在米级
Claude 读完全文后的提炼。
更多:先读哪 · 值得看的理由 · 质疑
先读哪
先看第 4 页图 2 和第 6 页表 1,再看第 8 页表 5、表 7
值得看的理由
- 同一个场景模型服务五种查询相机,360Loc 白天四个场景的平均中位旋转误差都在 6° 以内,CDG-Loc 为 6.4°-14.5° → P.6 表 1
- 相同虚拟视角增强下,加射线条件后平均平移误差从 5.1 m 降到 1.0 m,说明收益不只来自数据增强 → P.8 表 5
质疑
- 表 3 只列出 Ray 版本,没有同设置下原版 DSAC*/ACE/GLACE 的数字,“多数设置优于原基线”无法从表中核对;360Loc 上也没有和 HLoc 类特征匹配方法比较 → P.7 表 3
审稿人笔记
OmniScenes 数据来自机器人相机但没有闭环真机实验,代码是否开源论文未说明。