Type 1 · Directly applicable Must-read 证据 B 收录
Solv3R: 3D Looped Transformer as a Multi-view Solver
发布 · 收录于 2026-11-06
让同一个 Transformer 块像经典迭代求解器一样反复更新重建状态、且不依赖迭代步数,就能随时加入新视图、复用旧结果,用一个模型同时做离线重建、增量建图、重定位和流式重建。
- 任务
- 多视图三维重建:离线、增量、重定位、流式
- 数据
- DTU、ETH3D、7-Scenes、ScanNet++、nuScenes、Cambridge、TUM 等
- 硬件
- 无机器人实验;H100 GPU 上评测
- 模型
- 117M 参数,单个共享 Transformer 块反复调用
- 代码
- 论文称将公开(已有项目页)
证据等级 B · 仿真充分 (A 真机 + 多基准 + 消融 / B 仿真充分 / C 单一基准或无代码)
动机
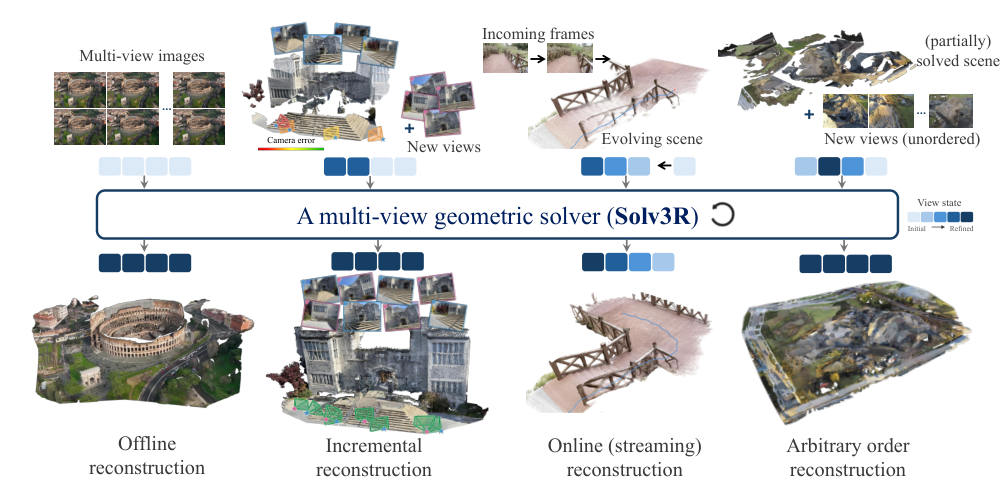
问题:几何基础模型(GFM,geometric foundation model,例如 VGGT,一次前向就从多张图预测相机位姿和深度)通常一口气算完。新图来了只能把所有图重新算一遍;流式模型(如 CUT3R)能逐帧更新,但只接受按顺序到来的帧。
卡在哪:经典 SfM(运动恢复结构)可以从当前解继续优化、随时加新视图。而 GFM 每一层权重不同,中间结果和“第几层”绑定,没法接着算。之前的循环 Transformer DéjàView 虽然共享了一个块,但每一步都要告诉它“现在是第几步”,所以迭代超过训练长度就会变差,也无法同时更新“算过 8 步”和“刚加入”的视图(→ P.2-3)。
方法
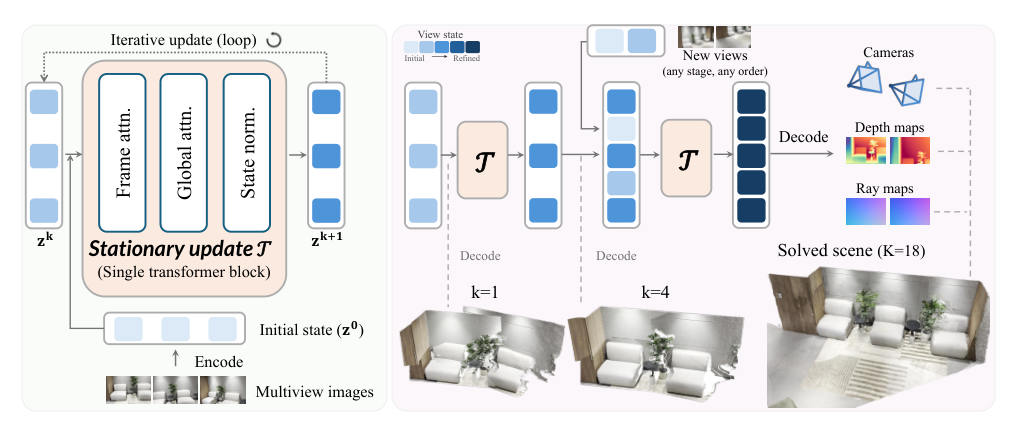
- 1编码图像编码成初始状态 z0
- 2反复更新同一个块更新状态,不看步数
- 3注入约束每步都把 z0 加回,并归一化
- 4加新视图新视图从 z0 起,旧视图保留状态
- 5自适应停状态变化小于 2% 就停
- 6解码随时解码出相机、深度、射线图
比喻:像解线性方程组的 Jacobi 迭代。每一轮用同一条规则修正答案,规则不关心这是第几轮;答案对了,再算也不变;答案被打乱,继续算会回到正确答案;方程多了几个未知数,旧未知数从已有的解出发,新未知数从初值出发,一起接着算(→ P.3-4)。
关键模块: 1. 平稳更新算子(stationary operator,不依赖迭代次数的更新规则):把 DéjàView 里按步数变化的门控换成固定的可学习门控,循环 Transformer(looped transformer,同一层反复使用)因此能同时更新进度不同的视图(→ P.4)。 2. 每步注入原始输入 + 状态归一化:每次更新都把图像编码 z0 加回去,相当于每轮都重新看一遍方程;再把整体状态缩放到固定大小,防止多次迭代后数值漂移(→ P.4, P.16)。 3. 专门的训练方式:先不带梯度随机跑 16-40 步,再跑 8 步带监督;以 0.15 的概率给状态加噪声或把部分视图重置到 z0,逼模型学会“稳住已解好的”和“纠正错的”(→ P.5, P.16)。
副产品:已解好的视图状态不再变,它们的 KV cache(注意力用的键值缓存)只需算一次,对所有迭代步都能复用,比 DéjàView 按步存缓存小 16 倍(→ P.6-7)。
实验
本文方法 对比方法 · 数据来源:Table 2, P.8
本文方法 对比方法 · 数据来源:Table 3, P.10
本文方法 对比方法 · 数据来源:Table 4, P.10
离线重建(表 1,P.7):指标是位姿 AUC@3/@30(越高越好)。117M 的 Solv3R 与 DéjàView 在同样 16 步时持平;用自适应停止后,DTU AUC@3 85.5、ETH3D 70.4,参数量是 VGGT 等的约十分之一,精度相当或更好。
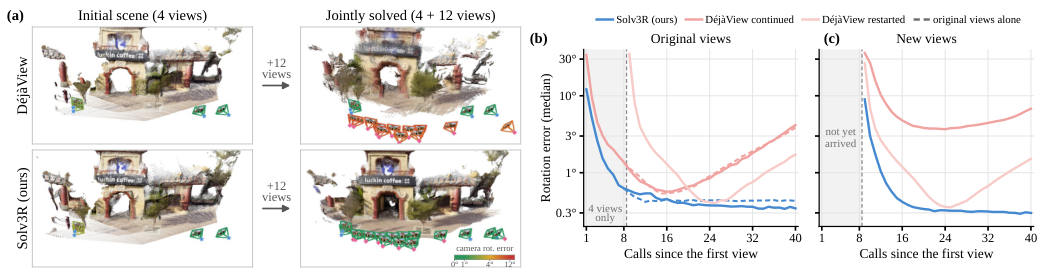
增量重建(图 8-9,P.8;附录 C.4,P.20):先解 4 个视图再加 12 个,Solv3R 不仅解出新视图,还让旧视图更准;DéjàView 则逐渐发散。从 8 张扩到 64 张,每次插入跑 8 步继续算,AUC@10 达 92.2,从头重解 8 步只有 84.8。
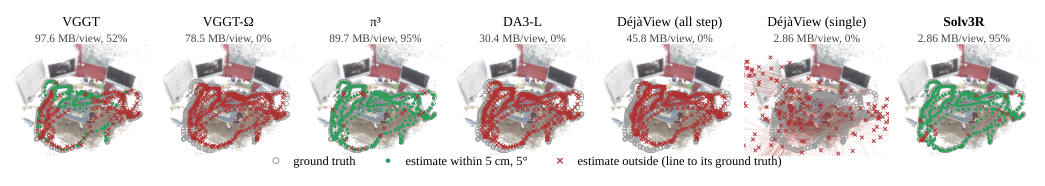
地图重定位(表 2,P.8):地图帧解好后冻结,查询只读它们的缓存。召回率越高越好、缓存越小越好。Solv3R 每视图缓存 2.86 MB(VGGT 97.6 MB),7-Scenes 5cm/5° 召回 72.8%,Cambridge 25cm/2° 召回 24.9%,单次查询 51 ms。DéjàView 只存一份缓存时召回为 0。
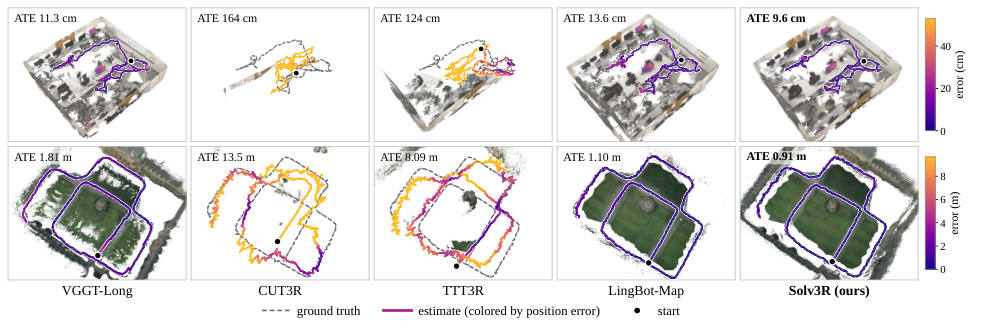
流式重建(表 3,P.10):没有做流式专门训练。TUM 动态序列 ATE(绝对轨迹误差,越低越好)0.015 m,好于 LingBot-Map 的 0.032 m;每帧 95 ms、峰值显存 5.0 GB,2000 帧长序列显存有上限(P.20)。
站得住的结论:消融(表 4,P.10)显示,只追求固定步数精度不够,必须同时训练稳定和纠错;去掉扰动训练后,加入新视图的误差从 0.62° 升到 4.24°。
代价与局限:训练约一周、8 张 H100(P.7);两组视图几乎不重叠时会收敛到错误位置且不再纠正(P.20)。
要点 Take-home
- 更新规则不看迭代步数,新旧视图才能在同一步里一起被修正。
- 地图只存一份 KV 缓存(2.86 MB/视图),7-Scenes 重定位召回 72.8%。
- 不做流式专门训练,TUM 动态序列 ATE 0.015 m,好于专用流式方法。
- 两组视图几乎不重叠时,会停在错误的解上不再纠正。
Claude 读完全文后的提炼。
更多:先读哪 · 值得看的理由 · 质疑
先读哪
先看第 4 页图 4,再看第 8 页图 8 和表 2
值得看的理由
- 地图只存一份 2.86 MB/视图的 KV 缓存,7-Scenes 和 Cambridge 重定位召回都是表中最高(72.8% / 24.9%) → P.8 表 2
- 消融清楚:去掉输入注入、状态归一化或随机预迭代,迭代到 1024 次后精度都掉到 0 → P.10 表 4
质疑
- 重定位时用检索到的地图帧的真值位姿还原查询的绝对位姿,地图自身的误差没算进去;所有耗时都只在 H100 上测 → P.17 Appendix B, Map-based relocalization
审稿人笔记
代码和模型论文中只说将公开,端侧设备上的速度未报告。