Type 1 · Directly applicable 证据 A 收录
HeLM: Hierarchical Explicit Language Memory for Non-Markovian Manipulation
发布 · 收录于 2026-11-04
让 VLM 用显式的文字记录任务进度,并且只在检测到关键事件时才改写,就能让只看当前画面的 VLA 完成需要记忆的操作任务。
- 任务
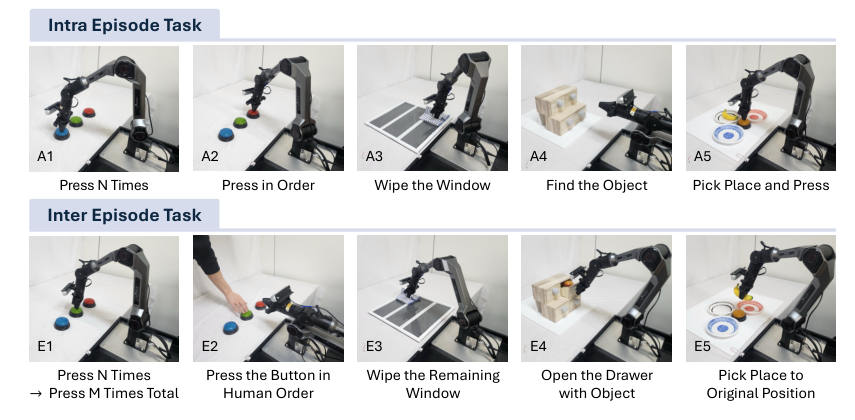
- 需要记忆的桌面操作:计数、按顺序、跨回合回忆(10 个任务、56 个变体)
- 硬件
- AgileX PiPER 7 自由度机械臂 + 桌面/腕部 RGB 相机
- 模型
- 上层 Qwen2.5-VL-7B(QLoRA 微调),下层 π0;仿真用 π0.5
- 代码
- 有项目页;文中未说明是否开源代码
- 主结果
- 任务内严格成功率 81.3%,跨回合子任务成功率 89.2%
证据等级 A · 真机 + 多基准 + 消融 (A 真机 + 多基准 + 消融 / B 仿真充分 / C 单一基准或无代码)
动机
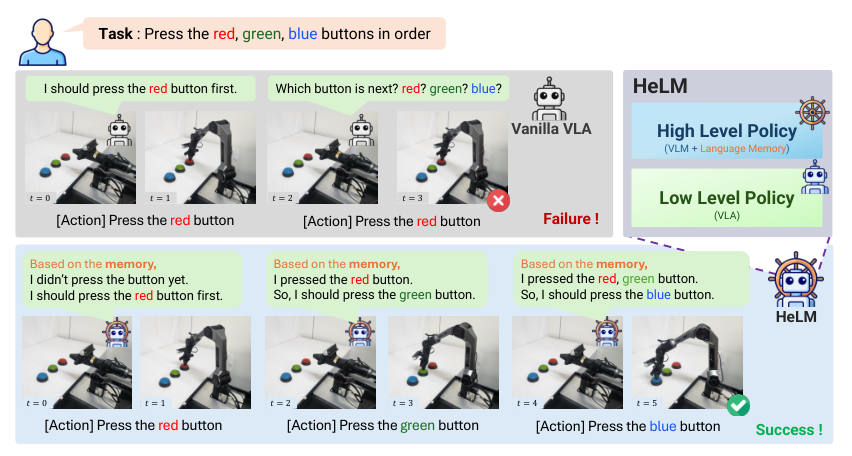
问题:很多操作任务光看当前画面不够。比如“按红、绿、蓝顺序按按钮”,按完红色后桌面看起来和没按时一样,机器人就会再按一次红色。这类任务叫非马尔可夫(non-Markovian)任务:最优动作取决于过去发生了什么,而不仅是现在看到什么。
现有方法卡在哪:大多数 VLA(视觉-语言-动作模型,把图像和指令直接变成动作)只看当前帧。已有的记忆方法要么把历史压成隐向量(latent),出错时说不清原因;要么堆叠过去的图片或关键帧,历史越长计算越贵(P.1)。
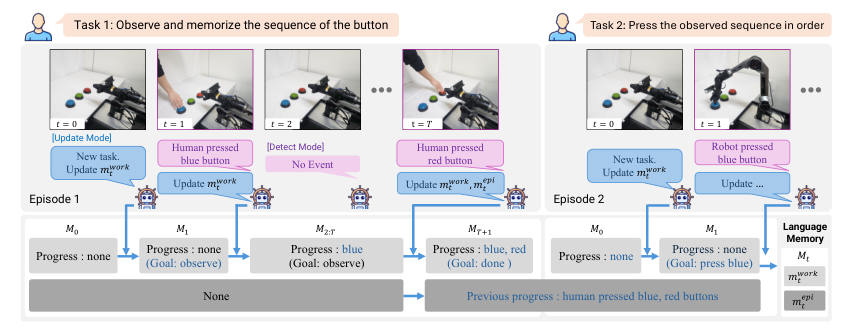
更难的一层:换一条新指令后,还要用上一轮学到的信息(例如“刚才人按的顺序”)。作者称之为跨回合(inter-episode)任务,现有基准基本只考单回合内的记忆(P.3)。
方法
- 1看一眼VLA 每执行一段动作,VLM 看一次当前画面
- 2查事件检测模式:判断预定义事件是否发生
- 3改记忆有事件或换指令时才改写文字记忆
- 4发指令按记忆给出下一条动作指令
- 5执行π0 把指令变成机械臂动作
比喻:像做家务时在便利贴上写“红色已按,下一个绿色”。手(VLA)只管按按钮,脑子(VLM)只管看有没有新进展、改便利贴、告诉手下一步。
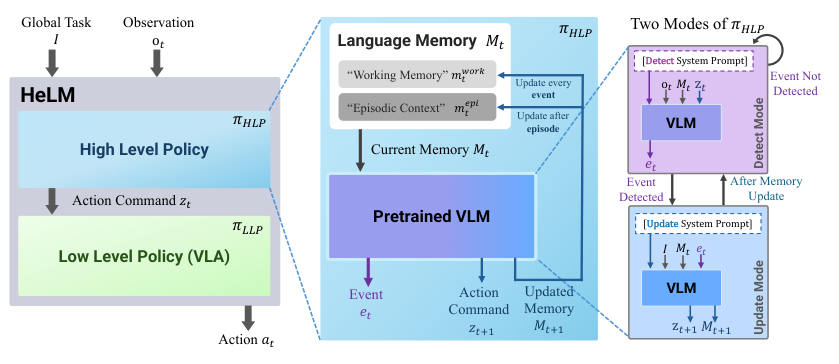
模块 1:两层分工(P.4)。上层策略(HLP,High Level Policy)是微调过的 Qwen2.5-VL-7B,负责维护记忆并发出“按蓝色按钮”这类动作指令;下层策略(LLP,Low Level Policy)是 π0,把指令和当前画面变成连续动作。上层每 10 步下层动作调用一次(P.7)。
模块 2:两段式推理(P.4-5)。同一个 VLM 用两种系统提示词切换角色:检测模式(Detect)只回答“预定义的某个事件发生了吗”,答案保守,不确定就说没有;更新模式(Update)只在检测到事件或指令改变时才运行,改写记忆并选出下一条指令。用公式说:动作原本只依赖当前画面和指令,现在额外依赖一段文字记忆 M。
模块 3:两栏记忆与造数据(P.4-5, P.15)。记忆分成工作记忆(working memory,本回合进度,如“Count: 2 (Goal: 3)”)和回合记忆(episodic context,回合结束时把进度总结进来,如“Previous_Count: 3”),换新指令时前者清空、后者保留。训练数据不用录长视频:用 TaskSpec(一份写明合法指令、事件和对应记忆状态的 JSON 表)把短的子任务片段拼起来,生成约 16.7 万条“图像 + 记忆文字”样本,单张 A6000 训练约 15 小时(P.16)。
实验
本文方法 对比方法 · 数据来源:Table 8, P.23
本文方法 对比方法 · 数据来源:Table 1, P.7
本文方法 对比方法 · 数据来源:Table 2, P.8
真机设置:10 个任务(5 个回合内、5 个跨回合),每个变体测 5 次(P.7)。主指标是子任务成功率(完成的子任务占比,越高越好);另报严格成功率(全部子任务按顺序完成且正确停机,越高越好)。对比:Keyframe-HLP(同一上层模型和事件检测,但记忆存图片而非文字)、PCMB-π0(把 MemoryVLA 的隐式记忆库移植到 π0)、Naïve-π0(无记忆)。
回合内:子任务成功率 85.7%,对比 72.9% / 39.5% / 16.7%(P.8);严格成功率 81.3%,Keyframe-HLP 29.3%,两个 π0 基线为 0(P.23 表 8)。
跨回合:HeLM 89.2%,Keyframe-HLP 16.6%(P.7 表 1);π0 类基线因换指令就丢失状态而未参与。
消融(仿真 LIBERO-Mem):完整方法 58.5%,π0.5 单独 36.5%;去掉记忆只剩层级结构降到 12.0%,有记忆但上层不微调降到 8.5%(P.8 表 2),说明提升不是来自多加一层模型。真机上把两段式合成一段,平均从 85.7% 降到 67.7%(P.9 表 3)。
泛化:没见过的计数、更长顺序、新物体,子任务成功率 78.0%,Keyframe-HLP 65.7%(P.9 表 4)。
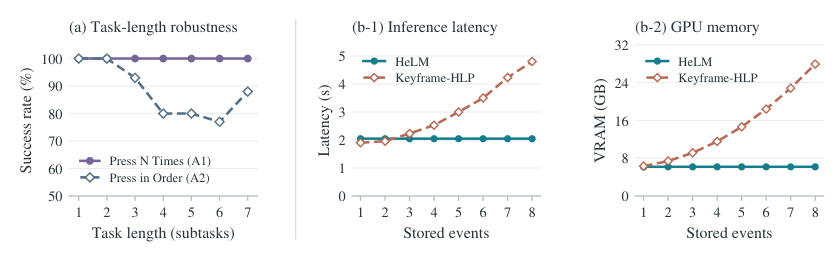
代价:8 个事件时 Keyframe-HLP 显存 28 GB,HeLM 不到 6 GB,长时程快 2.5 倍;但比纯 VLA 多了上层推理开销(P.10)。换成 SmolVLM + SmolVLA 小模型,成功率降到 58.7%,峰值显存 13.18→2.3 GB,端到端延迟 1.9→0.7 s(P.24)。
失败来源:事件检测错误占 64.1%,下层执行错误占 31.2%,几乎没有顺序或停机错误(P.8);检测误报会写坏记忆且系统无法自我纠正。
要点 Take-home
- 任务进度写成文字交给 VLM 管,VLA 就能做计数、按序和跨回合任务。
- 真机严格成功率 81.3%,只把记忆换成图片的同构对照仅 29.3%。
- 8 个事件时文字记忆显存不到 6 GB,图片记忆要 28 GB。
- 事件要逐任务预先定义,事件误检会写坏记忆,目前无法自我纠正。
Claude 读完全文后的提炼。
更多:先读哪 · 值得看的理由 · 质疑
先读哪
先看第 4 页图 2(结构)和第 5 页图 3(记忆怎么变),再看第 7 页图 5、表 1 和第 8 页表 2 消融
值得看的理由
- 真机任务内严格成功率 81.3%,只换记忆形式(存图片)的同构对照为 29.3%,π0 类基线为 0 → P.23 表 8
- 文字记忆不随历史变长而膨胀:8 个事件时显存不到 6 GB,图片记忆达 28 GB,长时程快 2.5 倍 → P.10 图 6 / Sec. 5.6
质疑
- π0 类基线本身没有停机机制,严格成功率归零部分源于结构而非记忆;跨回合任务只和自家 Keyframe 变体比较 → P.22 App. D.1; Sec. 5.2 (P.8)
- 每个变体只测 5 次,且事件词表由 TaskSpec 逐任务人工预定义,泛化到开放任务的证据有限 → P.10 第 6 Limitations; Sec. 5.1 (P.7) 节
审稿人笔记
想迁移到导航或移动操作,最大障碍是 TaskSpec 预定义的事件词表,以及检测误报后记忆无法回滚。