Type 2 · Promising method Key group 证据 B 收录
GoalDex: Learning Image-Goal-Conditioned Policies for Dexterous In-Hand Manipulation
发布 · 收录于 2026-11-04
灵巧手在手内转动物体时,可以不估计物体位姿,直接用「当前图像 + 目标图像 + 关节读数」端到端学出动作,并在真机上比基于位姿的方法好得多。
- 任务
- 手内重定向(把手里的物体转到目标朝向)
- 硬件
- 16 自由度 Allegro 灵巧手 + 腕部 RealSense D435i 单目 RGB
- 数据
- Isaac Lab 仿真,5 个物体与 25 个物体两组,3DGS 渲染图像
- 主要结果
- 真机 100 次试验成功 80%,最强位姿基线 27%
- 代码
- 项目页称提供视频和代码
证据等级 B · 仿真充分 (A 真机 + 多基准 + 消融 / B 仿真充分 / C 单一基准或无代码)
动机
常见做法是先估计物体的位姿(pose,即位置和朝向),再把位姿交给控制器。问题有三个:
- 手指会严重遮挡物体,位姿跟踪不稳(P.1)。
- 位姿要求每个物体都有一个事先定义好的「标准坐标系」,物体一多就很难定义(P.2)。
- 位姿只描述物体在哪、朝哪,丢掉了局部形状和接触信息,而这些正是灵巧操作需要的(P.2)。
另一条路是直接用 DINOv2 这类预训练视觉特征,但它们是为看静态图片训练的,不懂接触和运动(P.2)。作者想要的是:目标也用一张图表示,策略直接从图像和关节读数学会怎么转。
方法
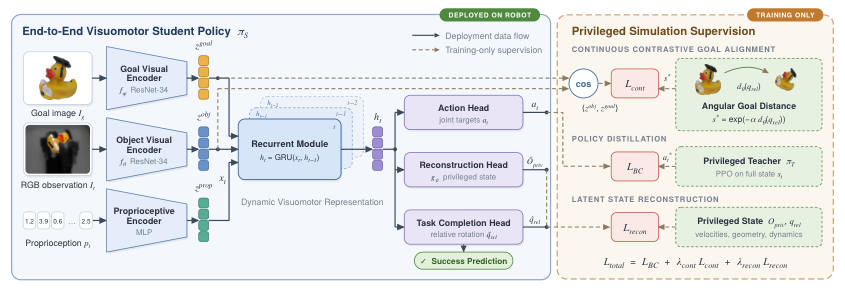
- 1教师先学仿真里用全部真值状态 PPO 训教师
- 2看两张图两个 ResNet-34 分别编码当前图和目标图
- 3记住过程GRU 把图像和关节读数按时间融合
- 4输出动作给出 16 个关节的目标角度
- 5判断完成预测剩余转角,低于 0.4 弧度算成功
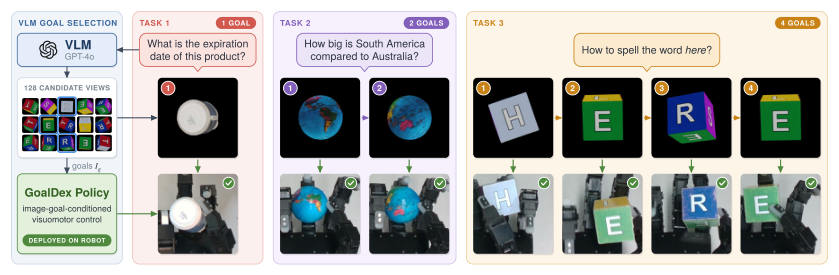
- 6VLM 选图大模型从 128 张候选图挑目标
比喻:不告诉机器人「把杯子转到 (x, y, z, 角度)」,而是给它一张照片说「转成这个样子」。
1. 师生蒸馏(teacher-student distillation):先在仿真里用强化学习(PPO)训练一个「教师」策略,它能看到物体真实位姿、质量、摩擦等特权信息(privileged state,真机上拿不到的仿真真值)。再训练只能看图像和关节读数的「学生」去模仿教师的动作,训练方式是在线 DAgger:开始时多由教师执行,逐步交给学生(P.3、P.15)。
2. 带记忆的学生网络:当前图像和目标图像各用一个 ResNet-34 编码,关节读数(本体感知,proprioception:机器人对自身关节角度和历史动作的感知)用 MLP 编码,三者拼起来送进两层 GRU(一种循环神经网络,能记住前几帧)。旁边加一个重建头,要求网络从记忆里还原物体速度、尺寸、质量等真值,逼它把物理信息记下来(P.4)。
3. 连续对比对齐(continuous contrastive alignment):对比损失(contrastive loss)通常只分「像 / 不像」。这里把当前图和目标图嵌入的余弦相似度,回归到 exp(-α × 两者真实转角差),α = 2.5。于是转角差越小,嵌入越接近,而且是连续变化的,给策略一个「还差多少」的渐进信号(P.5、P.18)。另有一个头直接预测相机坐标系下的剩余转角,连续 3 步低于 0.4 弧度就宣布完成(P.5、P.18)。
实验
本文方法 对比方法 · 数据来源:Table 1, P.6
本文方法 对比方法 · 数据来源:Table 2, P.6
本文方法 对比方法 · 数据来源:Table 5, P.8
设置:仿真结果取 3 个随机种子,每个 64 个环境、每环境 2 回合(P.5)。指标:连续成功次数 CS(越高越好)、单次到达时间 TTS(秒,越低越好)、成功预测 F1(越高越好)、误报完成率(%,越低越好)。只有策略自己宣布完成且真实误差 < 0.4 弧度才算成功(P.5)。
输入对比(表 1,P.6):基于位姿估计的基线最好只有 11.23 次;只用图像不用关节读数几乎为 0(0.01);图像 + 关节读数 + 位姿目标为 69.20;本文图像目标 77.30。附录表明,即使给真值位姿也只有 22.49,要再加上物体类别和尺寸才到 98.64(表 6,P.13),说明位姿本身缺物体形状信息。
结构消融(表 2,P.6):冻结的 ImageNet、DINOv2、Depth Anything V2 编码器都接近 0;去掉记忆降到 38.64,记忆里不放视觉降到 47.83,只重建位姿为 66.03。文字称去掉重建头会完全失败,但表中没有这一行(P.7)。
对齐方式(表 3,P.7):连续对比 77.30,高于 InfoNCE 63.01、共享编码器 67.18、EMA 67.95、两编码器分开 56.99。
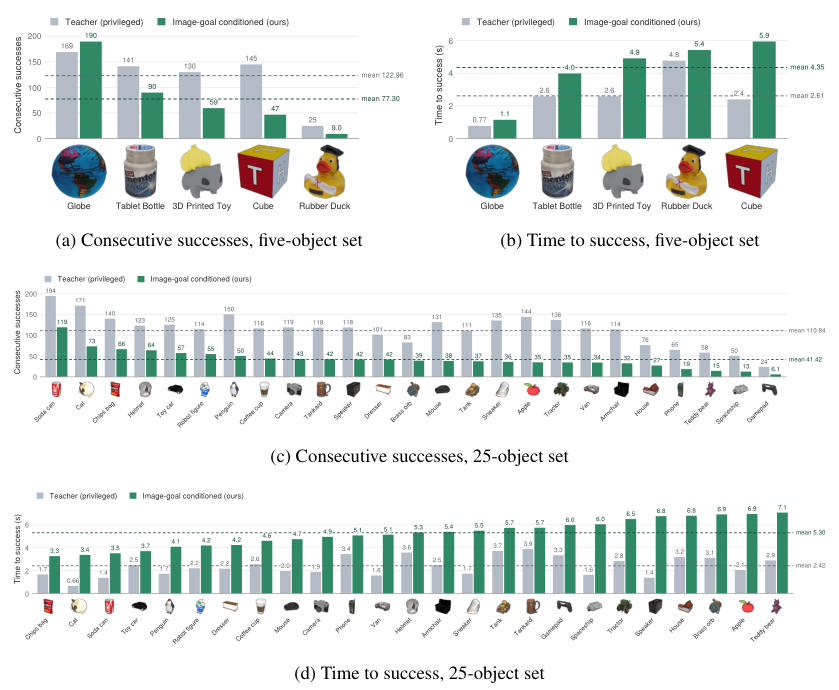
扩展到 25 个物体(表 4,P.7):教师仍有 110.84,学生原设置只有 10.11,并行环境翻倍(1280 个)后回到 41.42,与教师差距明显。
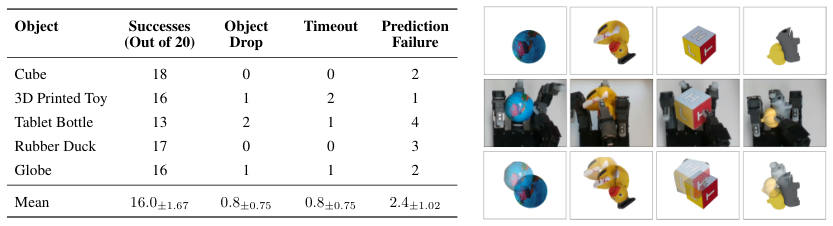
真机(表 5,P.8):5 个物体各 20 个随机目标,共成功 80 次;最强位姿基线(带类别编码)同协议只成功 27 次(P.8,仅给总数)。主要失败是误报完成(平均每物体 2.4 次),掉落和超时较少;表面光滑、对称的药瓶最难(13/20)。
代价:策略在 RTX 6000 Ada 上 30 Hz 运行,视觉编码器异步执行;每个策略在 2 张 H100 上训练约 30 小时(P.17)。
要点 Take-home
- 不估计位姿、直接用目标图像指挥灵巧手,真机五个物体成功率 80%。
- 关节读数不可缺:只用图像几乎全失败,加上后连续成功约 77 次。
- 冻结的 DINOv2 等预训练特征在此任务上几乎无效,表征要在交互中学。
- 物体从 5 个增到 25 个后成绩明显下降,且仍依赖物体网格与分割掩码。
Claude 读完全文后的提炼。
更多:先读哪 · 值得看的理由 · 质疑
先读哪
先看第 4 页图 2(整体结构),再看第 6 页表 1、表 2 和第 8 页表 5(真机结果)
值得看的理由
- 用目标图像代替位姿目标,高层 VLM 只需挑图就能指挥底层灵巧控制,接口简单 → P.9 图 4, Sec. 4.6
- 消融较全:冻结预训练编码器、去掉记忆、换对齐损失都逐一对比,并有 100 次真机试验 → P.6 表 1-2; Table 3 (P.7); Table 5 (P.8)
质疑
- 「不需要位姿」有前提:目标图要用已知物体网格渲染,输入还需微调 SAM2 生成的物体掩码 → P.9 第 5 Limitations; App. B.4 (P.17) 节
- 正文称 InfoNCE 的成功预测 F1 最高,但表 3 中 Shared 为 0.936,高于 InfoNCE 的 0.934 → P.8 第 4.3 vs Table 3 (P.7) 节
审稿人笔记
这是同组 ViserDex 的延续,对导航方向的直接价值主要在「图像目标 + 连续相似度」这一接口思路。