Type 1 · Directly applicable 证据 B 收录
ParetoSaddler: Pareto-Guided Optimization of Agent Harnesses for Quality and Cost
发布 · 收录于 2026-11-05
自动优化智能体外壳时,中间版本只要在质量或成本任一项上“可信地”变好就该保留,最终部署偏好留到最后再用,这样两项指标都能更好。
- 任务
- LLM 智能体外壳(harness)的自动优化,同时看质量和花费
- 数据
- ClawMark(92 题)、GAIA2,按领域划分训练/开发/测试
- 模型
- 任务模型 GPT-5.4 / GPT-5.5,优化器 GPT-5.5(xhigh)
- 代码
- 论文称项目页与代码将发布,目前未见
- 主结果
- ClawMark 质量 70.86%→81.35%,每题花费 $1.17→$1.01
证据等级 B · 仿真充分 (A 真机 + 多基准 + 消融 / B 仿真充分 / C 单一基准或无代码)
动机
问题:智能体的能力不只来自模型,也来自外壳(harness,即模型外面的提示词、工具、中间件和控制逻辑)。已有自动外壳优化(AHO)方法主要只追求答题质量,不管花多少 token 钱。
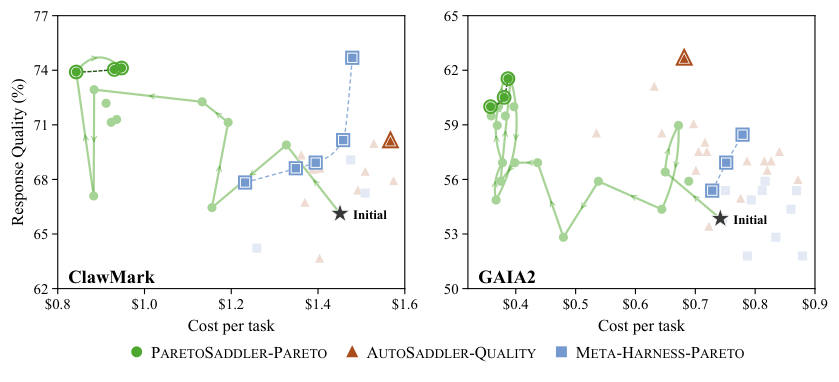
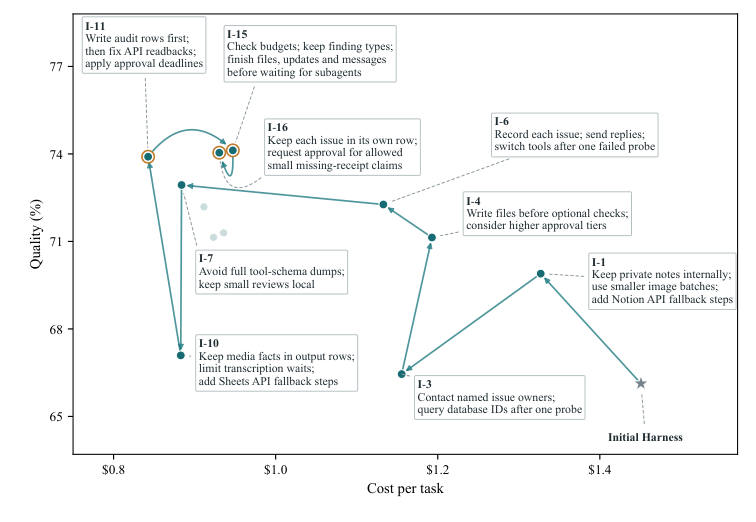
卡在哪:想同时管质量和成本,最直接的做法是每一步都按最终部署要求筛选(比如“质量不降且更便宜才收”)。作者指出这会过早扔掉有用的中间版本:一个补丁修好了“提前放弃”的毛病,质量上去了,但因为多想、多交互,花费也上去了,按部署要求会被拒,后面的补丁就没机会在它上面再压成本(P.2)。
为什么难:同一个外壳反复运行,质量和花费波动很大,ClawMark 上任务内变异系数(CV,标准差除以均值)质量约 18.8%、成本约 25.6%(P.5)。只比一次运行的平均值,很容易把运气当成进步。
方法
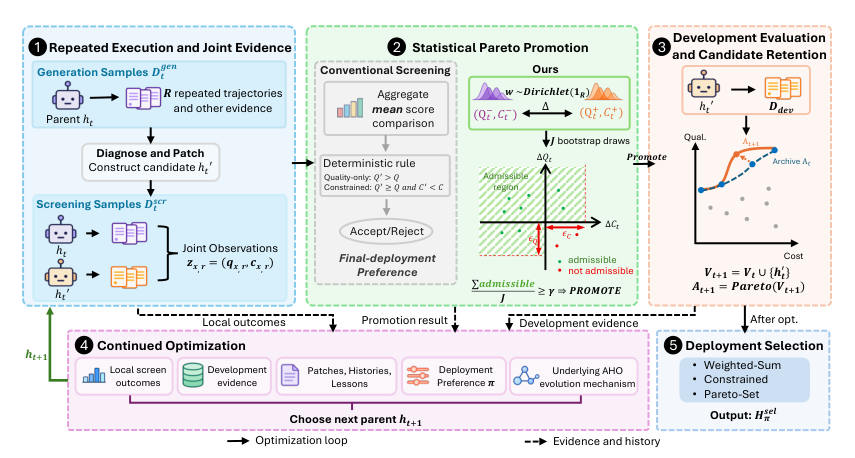
- 1跑三遍父版本与新版本在小批任务上各跑 3 次
- 2打补丁优化器读运行轨迹,给外壳生成改动
- 3抽样判贝叶斯自助法算“进步可信度”
- 4双向放行质量或成本任一项可信变好即晋级
- 5开发集评晋级者上开发集,进入候选池
- 6最后挑预算用完才按部署偏好选最终版
比喻:像登山找路。你最终要的是“又高又近”的山头,但中途有时得先往远处走一段更高的坡,才能翻到更好的位置。如果每一步都要求“又高又近”,就会困在附近的小山包上。
模块一:帕累托式晋级门(Pareto-aware promotion)。帕累托(Pareto)的意思是:没有别的方案在两项指标上都不差、且至少一项更好。本文在中间筛选时不套用最终部署要求,而是只要“质量涨了、成本没失控”或“成本降了、质量最多掉 10 个点”就放行(P.6 式 7;实验里成本上涨不设上限)。所有晋级过的版本都留在候选池里,后续都能当父版本(P.6)。
模块二:重复运行 + 贝叶斯自助筛选(Bayesian bootstrap)。贝叶斯自助法:给每次运行随机分配一组加起来为 1 的权重(Dirichlet 分布),重新算一遍平均,重复 1 万次,看结论稳不稳。本文在每次抽样里同时算质量差和成本相对变化,统计有多大比例的抽样满足放行条件;比例达到 γ=0.7 才晋级(P.6 式 8,P.7)。
模块三:部署选择后置。预算用完后,再按部署偏好(加权和、约束、或给出整条帕累托前沿)从候选池里挑最终外壳(P.6)。本文把这套规则装在已有方法 AutoSaddler 上(P.7)。
实验
本文方法 对比方法 · 数据来源:Table 1, P.8
本文方法 对比方法 · 数据来源:Table 1, P.8
本文方法 对比方法 · 数据来源:Table 3, P.9
数据与指标:ClawMark(多轮多天的办公协作任务,用 stage-0 评分细则打分)和 GAIA2(动态异步环境,Pass@1),训练/开发/测试按领域分开,测的是没见过的领域(P.7、P.14)。质量越高越好,每题美元花费越低越好;测试结果是 3 次重复的均值±标准差。
对比对象:Meta-Harness 的帕累托版和最低成本版(MH-PARETO、MH-MINCOST),以及只看质量的 AutoSaddler(AS-QUALITY)。Meta-Harness 被给了约 1.37 倍(ClawMark)和 1.22 倍(GAIA2)的任务执行预算(P.15)。
主结果(P.8 表 1):质量端点 PS-PARETOQ 在 ClawMark 上 81.35%、$1.01,在 GAIA2 上 62.89%、$0.45,两项都优于初始外壳和全部基线;比只追质量的 AS-QUALITY 高 7.49 点(ClawMark)和 5.56 点(GAIA2),还更便宜。最低成本设定 PS-MINCOST 在 GAIA2 上做到每题 $0.44、质量 56.11%,而 MH-MINCOST 质量掉到 39.78%。
消融: - 换成“只收更便宜”的晋级门后,开发集只晋级 3 个候选(帕累托门为 11 个),测试结果 73.95%/$0.90,差于 75.16%/$0.82(P.8 图 3)。 - 每题只跑 1 次时,质量端点测试质量从 81.35% 降到 75.71%(P.9 表 2);作者承认这项对比没有对齐计算量(P.20)。 - 把贝叶斯筛选换成比均值,两个端点都更差(P.9 表 3)。 - GAIA2 上补跑的第二次优化,质量 61.44%-62.22%,与第一次接近(P.22 表 10)。
代价:本方法优化器每个补丁约 $9.62、982 秒,高于 AS-QUALITY 的 $6.01 和 MH-PARETO 的 $5.42(P.22 表 11)。
要点 Take-home
- 中间版本只要质量或成本一项可信变好就保留,最终效果更好
- ClawMark 上质量从 70.86% 升到 81.35%,每题花费反而降了
- 同一外壳多跑几次再比,比只看一次平均值更不容易被运气骗
- 代价是优化器本身更贵,每个补丁比只追质量的基线多花约六成
Claude 读完全文后的提炼。
更多:先读哪 · 值得看的理由 · 质疑
先读哪
先看第 2 页图 1 和第 5 页图 2,再看第 8 页表 1
值得看的理由
- 给出一个可照搬的判定规则:重复运行后用贝叶斯自助法算“进步可信度”,超过 0.7 才晋级 → P.6 式 6-8
- 三组受控消融(换晋级门、单次 vs 三次运行、均值 vs 贝叶斯筛选)在留出测试集上都支持各模块 → P.9 表 2, Table 3
质疑
- 每种方法基本只跑一次优化(仅 GAIA2 补了一次),且本方法每个补丁的优化器花费更高($9.62 对 $6.01),对 AS-QUALITY 的 7.49 点优势缺少多次优化的方差 → P.22 表 10, Table 11
审稿人笔记
这是纯软件智能体工作,没有机器人实验;价值在于“如何判断一次自动改进是真的”这套评估协议。