Type 2 · Promising method 证据 B 收录
OpenNWM: A Generalist Navigation World Model with Latent Action Pretraining
发布 · 收录于 2026-11-04
先从大量没有动作标签的导航视频中学出“隐动作”来预训练世界模型,再用少量真实动作数据对齐,就能让导航世界模型预测更准、泛化更好。
- 任务
- 导航世界模型(预测未来画面,用来规划路线)
- 数据
- NavAnywhere 1750 万帧无动作视频;RECON、SCAND、HuRoN、TartanDrive 微调
- 硬件
- 离线评测,含 Unitree Go2 办公室录制数据;无闭环部署
- 代码
- 项目页已上线;论文称将发布代码与权重
- 主结果
- Office-Go2(未见场景)ATE 2.89,NWM 为 3.03
证据等级 B · 仿真充分 (A 真机 + 多基准 + 消融 / B 仿真充分 / C 单一基准或无代码)
动机
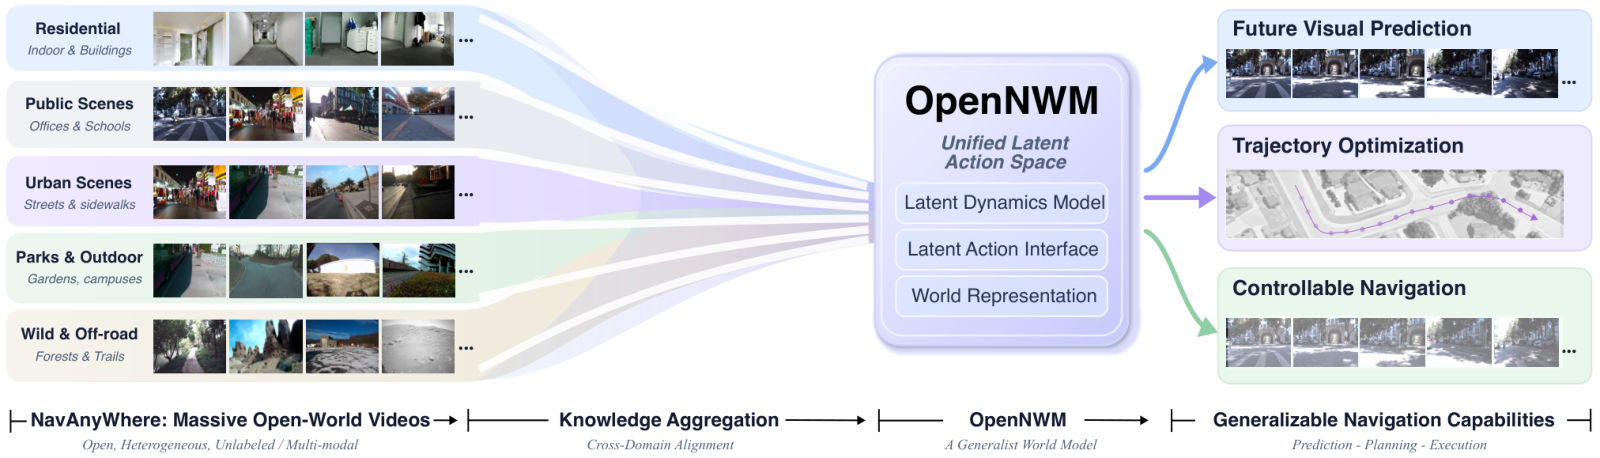
导航世界模型(Navigation World Model, NWM) 是一个“想象器”:给它当前画面和一串动作,它画出机器人走过去后会看到什么,规划器就能先想象再挑动作。
问题在于训练它需要“画面+动作”成对的数据,而带动作标签的机器人轨迹又贵又少,场景覆盖窄。网上的步行、行车、无人机视频很多,却没有记录动作。原版 NWM 只能用“时间间隔”当条件去利用这些视频,但时间只说“预测多久以后”,不说“往哪走了”。
本文想回答:怎样把海量无动作视频变成对“动作→画面变化”有用的训练信号?(→ P.2)
方法
- 1汇视频15 个来源、1750 万帧无动作导航视频
- 2学隐动作从前后两帧推断 32 维隐动作,少量位姿数据校准
- 3预训练扩散世界模型以隐动作为条件预测未来画面
- 4换真动作换成位移动作编码器,在 4 个机器人数据集微调
- 5想象规划CEM 采样动作,想象 2 秒后画面,选最像目标的
比喻:像看行车记录仪学开车,虽然不知道司机怎么打方向盘,但从前后两帧画面的变化就能猜出“左转了一点、往前走了两米”。这个“猜出来的动作”就是 隐动作(latent action):一个由模型自己学出的、代替真实动作的向量。
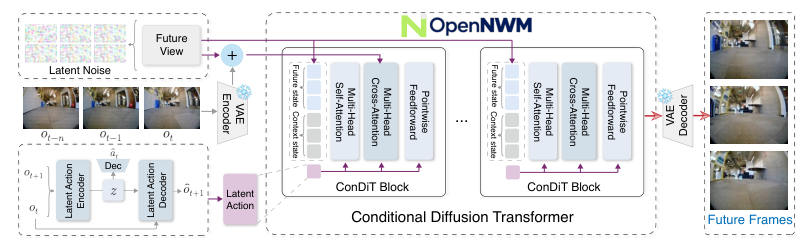
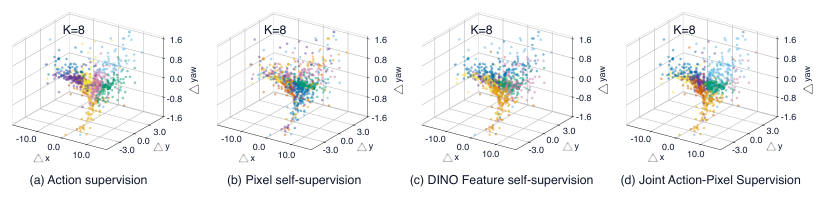
1. 隐动作模型(LAM)(→ P.4-5,P.19):编码器看两帧画面,输出一个 32 维的隐动作;解码器要用“当前帧+隐动作”重建下一帧(像素监督)。对少量带位姿的数据(RECON、HuRoN、SCAND),再要求隐动作能还原真实位移(动作监督,每批 25% 样本)。两种监督一起用,隐动作既保留画面变化,又对应真实运动方向。
2. 隐动作条件的扩散世界模型(→ P.5):主干是 CDiT-B/2 扩散 Transformer,在 Stable Diffusion VAE 的压缩空间里工作。隐动作、预测时长和扩散步数的嵌入相加后,通过自适应层归一化注入;过去 4 帧通过交叉注意力提供上下文。
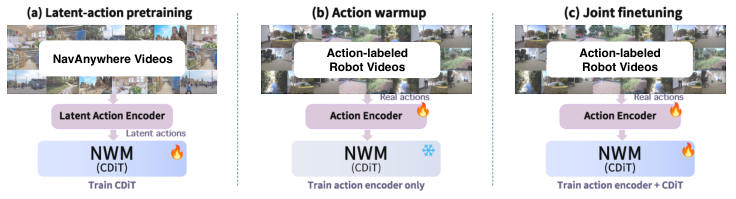
3. 三阶段训练与规划(→ P.7,P.20):先用隐动作在无动作视频上预训练;再把隐动作编码器换成真实位移 (Δx, Δy, Δyaw) 编码器,冻结主干热身 3K 步;最后全部联合微调 100K 步。规划时直接在真实动作空间里用交叉熵方法(CEM)采样 80 条动作序列,每条想象 3 次,用 LPIPS 比较想象画面与目标图,执行第一步后重新规划。隐动作只用于预训练,不参与在线规划。
实验
本文方法 对比方法 · 数据来源:Table 1, P.8
本文方法 对比方法 · 数据来源:Table 2, P.8
本文方法 对比方法 · 数据来源:Table 4, P.10
数据:在 RECON、SCAND、HuRoN、TartanDrive 上测域内(ID);在 Go Stanford、TUM RGB-D、月球/火星车图像、作者自采的 Go2 办公室数据上测域外(OOD)。(→ P.7)
指标:画面预测用 LPIPS、DreamSim(越低越好)和 PSNR(越高越好);导航用 ATE(绝对轨迹误差)和 RPE(相对位姿误差),都是越低越好。导航评测是离线的:给起点画面和目标画面规划轨迹,再与数据集真值轨迹比较。
对比:NWM、NWM-XL+Ego4D、RAE-NWM(预测与规划),以及 GNM、NoMaD、CompACT 等导航策略。
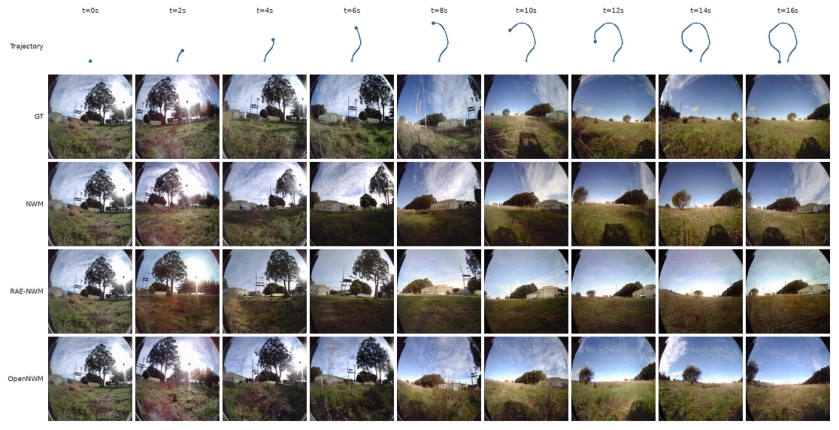
结果: - 4 秒画面预测:ID 平均 LPIPS 0.368,优于 NWM 的 0.405;OOD 的 PSNR 在 4 个集里 3 个最好,Go2 上第二。(→ P.8 表 1) - 导航:三个数据集上 ATE 都最低,但比 NWM 只小一点(RECON 1.13→1.12,SCAND 1.01→0.98,Go2 3.03→2.89)。(→ P.8 表 2) - 消融:只用时间条件 vs 时间+隐动作,SCAND ATE 1.045→0.950;像素+动作联合监督的隐动作最好。(→ P.10 表 4、表 5) - 加大无标签视频量(25%→100%),RECON DreamSim 从 0.20059 降到 0.18840,单调下降。(→ P.21 图 8)
站得住的:隐动作预训练对画面预测有稳定好处,消融清楚。站不太稳的:导航提升幅度小、只有离线开环评测、没有多次运行误差棒。
代价:训练用 8 张 L20;推理用 250 步 DDPM 采样,规划每步要做 80×3 次想象,论文未报告规划耗时。(→ P.19 表 8)
要点 Take-home
- 用无动作视频学出的隐动作做预训练,导航世界模型的画面预测更准
- 同约 280M 参数,域内平均 LPIPS 从 0.405 降到 0.368
- 隐动作要配少量真实动作监督,才能对应到真实运动方向
- 规划误差只比 NWM 略小,且仅离线评测,没有闭环真机
Claude 读完全文后的提炼。
更多:先读哪 · 值得看的理由 · 质疑
先读哪
先看第 4 页图 2 和第 7 页图 3,再看第 8 页表 1、表 2 和第 10 页表 4
值得看的理由
- 消融干净:预训练时“时间+隐动作”条件明显优于只用时间(SCAND ATE 1.045→0.950),说明无动作视频里的运动信息确实有用 → P.10 表 4
- 同为约 280M 参数,视觉预测 ID 平均和 3/4 个 OOD 集上最好,胜过 1.1B 的 NWM-XL+Ego4D → P.8 表 1
质疑
- 导航只是离线开环评测(对着数据集真值轨迹算 ATE),对 NWM 的提升很小(RECON 1.13→1.12),无闭环真机、无多次运行方差 → P.8 表 2
- 号称 15 个来源,但 Ego4D 占 NavAnywhere 约 75% 帧(13.09M/17.50M),多样性要打折扣 → P.17 表 6
审稿人笔记
论文未报告规划耗时,而每步规划需 240 次 250 步扩散采样,实时部署可行性存疑。