Type 2 · Promising method Key group 证据 C 收录
Learning Agile Humanoid Dodgeball with Onboard Monocular Vision
发布 · 收录于 2026-11-03
只用机身单目 RGB 相机得到的球检测框历史,就能让人形机器人在真机上完成“跟踪—躲避—恢复—再搜索”的连续闭环。
- 任务
- 人形机器人躲避抛来的球(躲避球)
- 硬件
- Unitree G1(29 关节)+ 躯干单目 RGB 相机
- 训练
- Isaac Lab 仿真强化学习,不渲染图像
- 主要结果
- 仿真 6 m/s、5 m 发射成功率 97.8–100%;真机单次 >85%
- 代码
- 论文未提供代码或项目页
证据等级 C · 单一基准或无代码 (A 真机 + 多基准 + 消融 / B 仿真充分 / C 单一基准或无代码)
动机
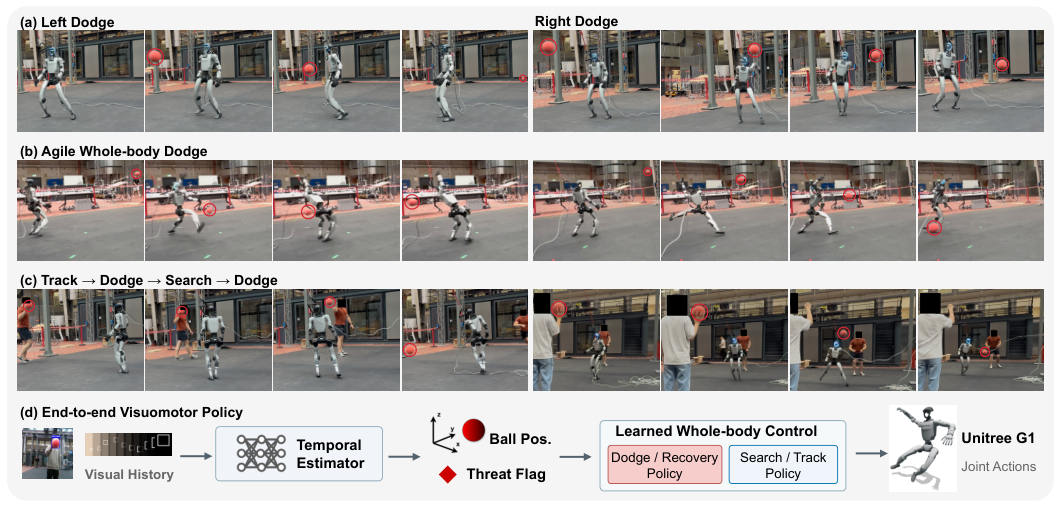
人形机器人在有人走动的地方工作,可能突然有东西飞过来。它要在很短时间内看见、判断、躲开,而且不能摔倒,躲完还要站稳、重新找到下一个目标。
难点在于相机装在躯干上:身体一转,视野就变,转太快图像还会模糊。已有的人形球类工作多依赖外部跟踪或结构化定位,相近的 PAC-MAN 用的是深度相机(→ P.1-2)。
这篇论文把躲避球当作一个可控的测试:球速、距离、方向都能设定,便于反复实验。
方法
- 1看微调的 YOLOv8 从单目图像框出球
- 2估小 MLP 由框历史估球位置与威胁
- 3选技能找没找到、有无威胁决定用哪个策略
- 4动躲避/恢复或搜索/跟踪策略输出关节目标
- 5训仿真解析投影代替渲染+三阶段课程
比喻:像教新手打躲避球——先由教练直接报出球的位置让他练步法(真值训练),等步法稳了再让他边练边学看球,最后完全靠自己的眼睛。
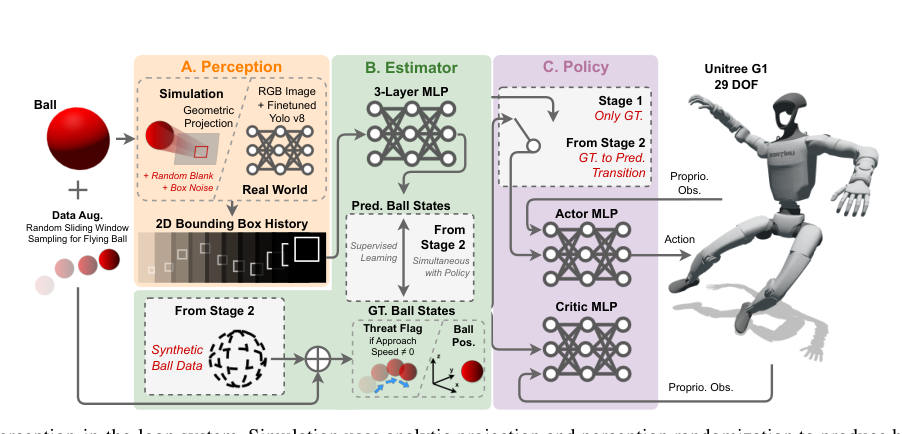
1. 检测框接口(bounding box,目标在图像里的矩形框):真机上由 YOLOv8 检测器给出球的框;仿真里不渲染图像,而是已知球的半径和位置,用相机几何直接算出球在图像上的切线边界,得到同样格式的框。再人为加入漏检、位置噪声、大小噪声和 30–50 ms 延迟,让仿真的框像真检测器一样“脏”(→ P.3)。
2. 时序估计器:单帧框看不出球在怎么动,所以把最近 2–20 帧的框送入一个三层 MLP(多层感知机,最简单的神经网络),输出球相对机器人的三维位置和一个“威胁标志”(threat flag,球是否正在飞过来)。框的大小用来推深度,所以假设球的大小已知。因为球在飞的时间很短,作者专门截取飞行片段并合成静止球、慢速球样本,避免估计器总是猜“没威胁”(→ P.3-4)。
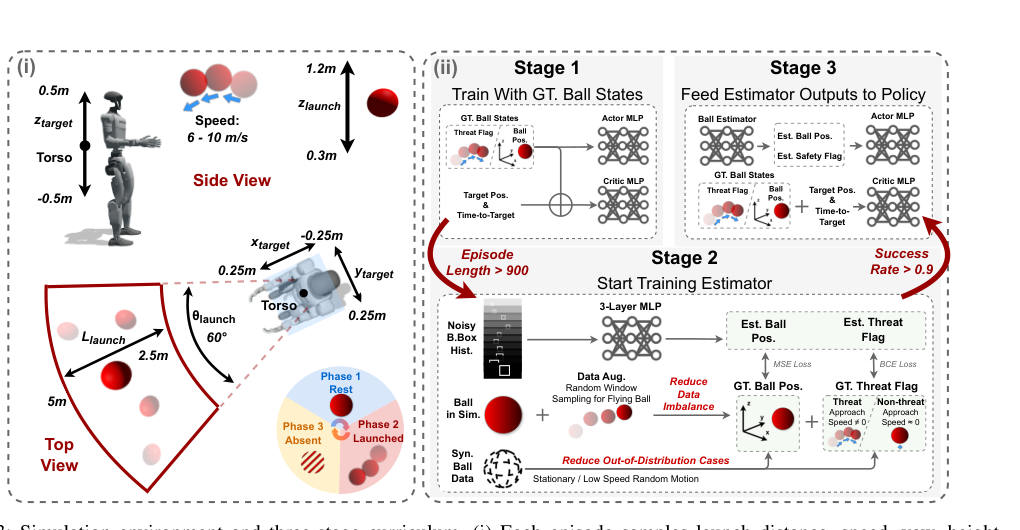
3. 两个策略 + 三阶段课程:躲避/恢复策略负责躲开并回到准备姿势;搜索/跟踪策略负责转身让相机对准球。两者都是非对称 actor-critic(演员只用部署时能拿到的信息,评论家可以用仿真里的真值)。训练分三步:第一阶段演员看真值学躲;回合长度超过 900 步后开始训练估计器;躲避成功率超过 0.9 后,把演员的输入换成估计器输出(→ P.4-5)。
实验
本文方法 对比方法 · 数据来源:Table III, P.7
数据来源:Table II, P.7
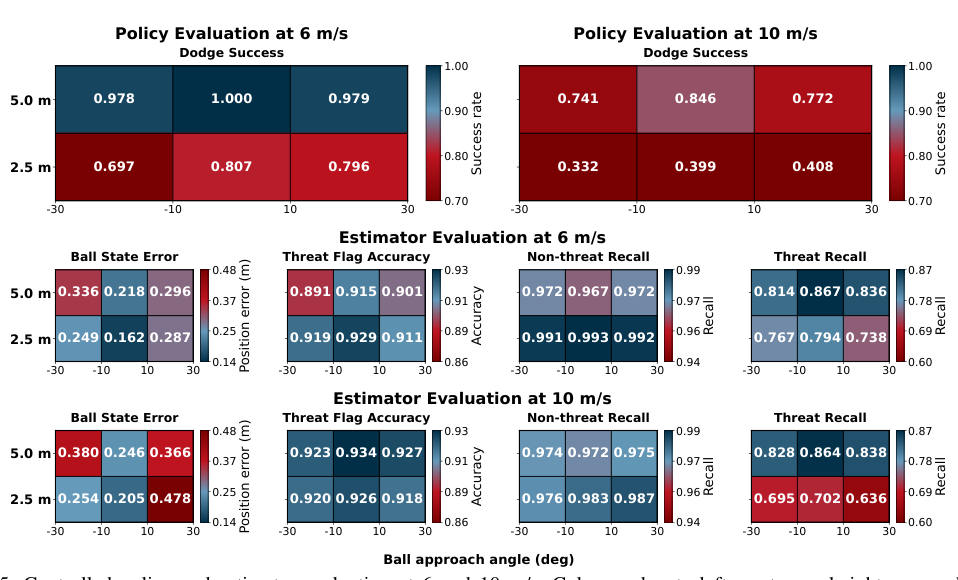
仿真设置:Isaac Lab 中,球速 6 和 10 m/s,发射距离 5.0 和 2.5 m,按左/中/右来球方向分三组,每个速度-距离组合 1000 次投掷。指标是躲避成功率(球没碰到任何身体部位且不摔倒,越高越好)和估计器位置误差(越低越好)。
主要结果(→ P.6 图 5): - 6 m/s、5.0 m:成功率 97.8–100%;10 m/s、2.5 m:只有 33.2–40.8%。反应时间越短越难。 - 估计器位置误差 0.162–0.478 m,威胁召回率 0.636–0.867。
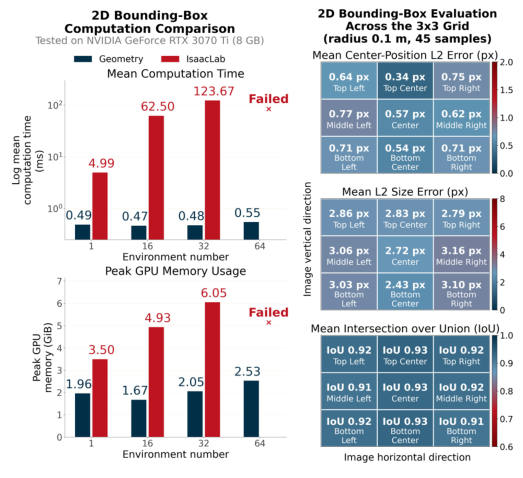
感知(→ P.5-6):检测器在 313 张验证图上 mAP@0.5 为 99.5%。解析投影每步约 0.5 ms,而 Isaac Lab 渲染从 4.99 ms 增长到 32 个环境时的 123.67 ms,64 个环境时直接失败。
噪声鲁棒性(→ P.7 表 II):小噪声几乎无影响(84.40% 对 83.53%),大噪声降到 26.90%。作者称真实检测框噪声介于小、中档之间。
课程消融(→ P.7 表 III):完整三阶段 90.8%,其余变体 67.6–80.6%。
真机:策略 50 Hz 输出关节目标,单次投掷成功率超过 85%(超过 15 次);另有一段“跟踪—躲避—全向搜索—再躲避”的演示(→ P.7)。真机统计偏少,连续多次投掷的鲁棒性作者自己也列为待做(→ P.8)。
要点 Take-home
- 只靠单目检测框历史,人形机器人就能估出球的位置并在真机上躲开
- 仿真里用几何公式算检测框代替渲染,观测生成快一到两个数量级
- 先用真值学会躲、再换成估计值,比一开始就用估计值高约 17 个百分点
- 球快且近(10 m/s、2.5 m)时成功率只剩三到四成,真机统计也偏少
Claude 读完全文后的提炼。
更多:先读哪 · 值得看的理由 · 质疑
先读哪
先看第 1 页图 1(真机效果和整体流程),再看第 4 页图 3(三阶段课程)和第 6 页图 5(不同球速、距离下的成功率)
值得看的理由
- 训练时用解析几何直接算出球的检测框,代替相机渲染,生成观测快 10.2–259.7 倍,与渲染框的 IoU 为 0.912–0.933,可借来训练其他视觉闭环策略 → P.6 第 IV-B, Fig. 6 节
- 课程消融清楚:完整三阶段 90.8% 成功率,从第一步就用估计值直接训练只有 74.1% → P.7 表 III
质疑
- 真机结果只有“超过 15 次、成功率超过 85%”的笼统数字,作者说确切次数和条件以后再补;没有和 PAC-MAN 等方法对比,也没有公开代码 → P.7 第 IV-E.2 节
审稿人笔记
与导航和记忆主线距离较远,主要可借鉴的是“解析投影代替渲染、分阶段换入估计值”的训练做法。