Type 1 · Directly applicable 证据 B 收录
Auriga Technical Report: A Task-Agnostic Agent Harness for Zero-Shot Embodied Manipulation
发布 · 收录于 2026-11-03
大模型会规划却不会精确动手;给它一个能测量、能预演、偏差即停并回报的工具层,就能在不试错、不重置的单次尝试里补回大部分差距。
- 任务
- 零样本双臂桌面操作 + 厨房移动操作(仿真)
- 数据
- RoboDojo 42 任务(6,300 集)、RoboCasa365 Target50(250 集)
- 硬件
- 仿真 ARX X5 双臂;Franka + 移动底盘;无真机实验
- 代码
- 已开源(GitHub + 项目页)
- 主结果
- RoboDojo 成功率 57.7%(同模型参考接口 22.5%)
证据等级 B · 仿真充分 (A 真机 + 多基准 + 消融 / B 仿真充分 / C 单一基准或无代码)
动机
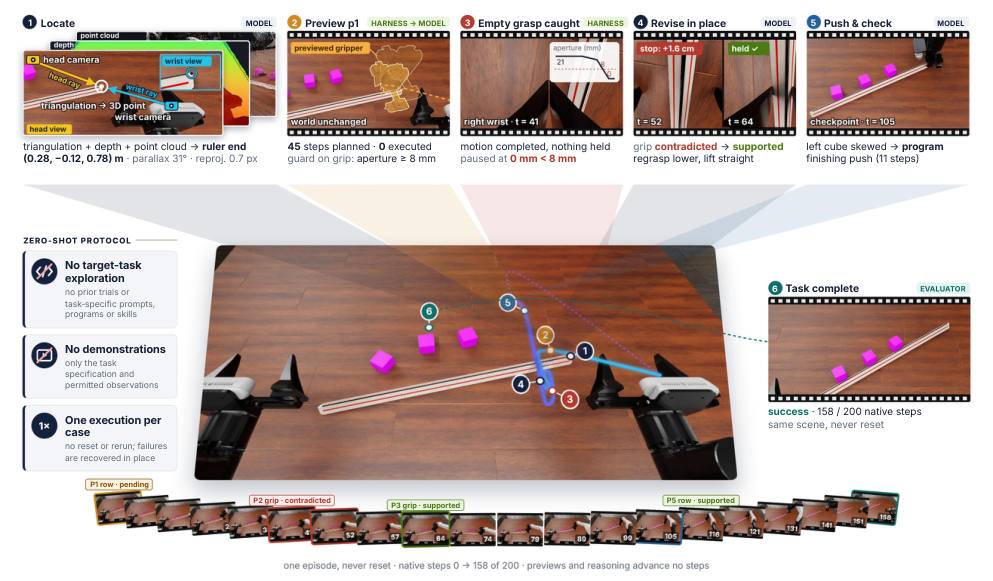
问题:通用视觉-语言大模型(VLM)能看懂指令、排出步骤,但直接当机器人策略用时成功率很低。
差距有多大:作者让 GPT-6 Astra 在 210 集上做对照。给它一个“特权动作”——不用手臂、直接把物体沿模型选的路径挪过去——成功率 76.2%;改用基准自带的末端控制接口(RoboProbe)驱动手臂,只有 22.5%(→ P.5 表 2)。模型通常选对了物体和目的地,却在抓取时差几毫米、搬运中掉落或撞到容器边沿。
现有方法卡在哪: - 逐步输出动作(含 VLA,即视觉-语言-动作模型):每次只发一小步,动之前看不到整条路线,撞了才发现(→ P.5)。 - 代码即策略(code as policy):程序看不到场景,动作失败了程序照样正常退出(→ P.6)。 - 反复试错的方法(如 HexaShell、EmbodiedEvo)在目标任务上多次重置场景来调参,换了布局就容易失效;而真机上失败会改变场景,往往只有一次机会(→ P.1、P.6)。
方法
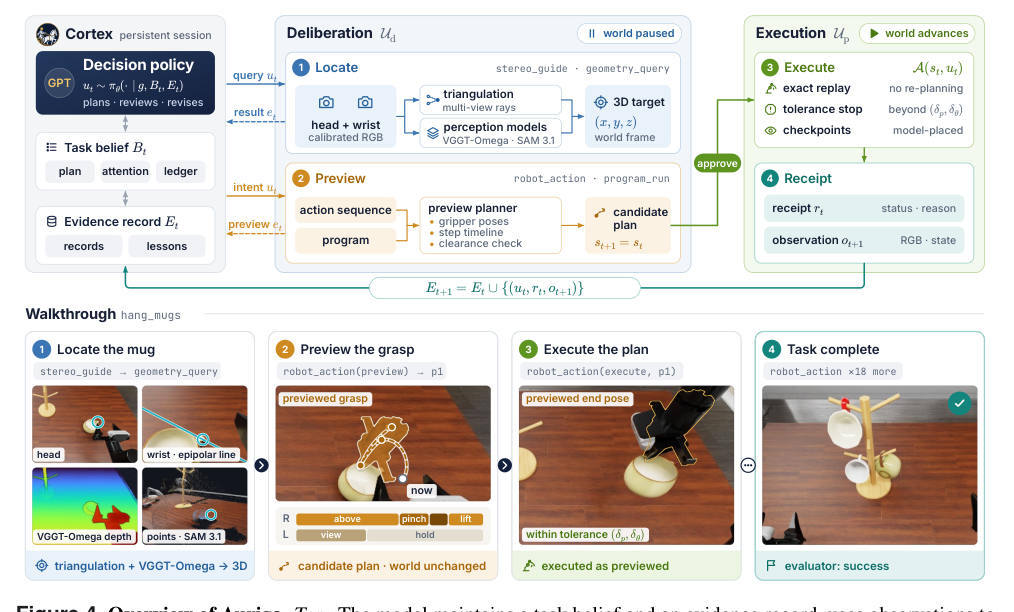
- 1定位多视角三角化+深度估计得3D坐标
- 2写信念记下计划、疑点和前提状态
- 3预演世界暂停,看完整轨迹和碰撞提示
- 4执行校验按阶段容差执行,超差立即停
- 5回执恢复返回偏差和新画面,原地改计划
比喻:像给新手司机配上倒车影像和一位安全员。司机(大模型)做所有决定;倒车影像(预演)让他在动之前看到整条路线;安全员(网关)只在车偏出允许范围时踩刹车,并告诉他偏了多少,但不替他开车。
这里的 harness(工具层)指连接模型与机器人的运行框架,本文的 harness 不含任何针对具体任务的代码或提示。
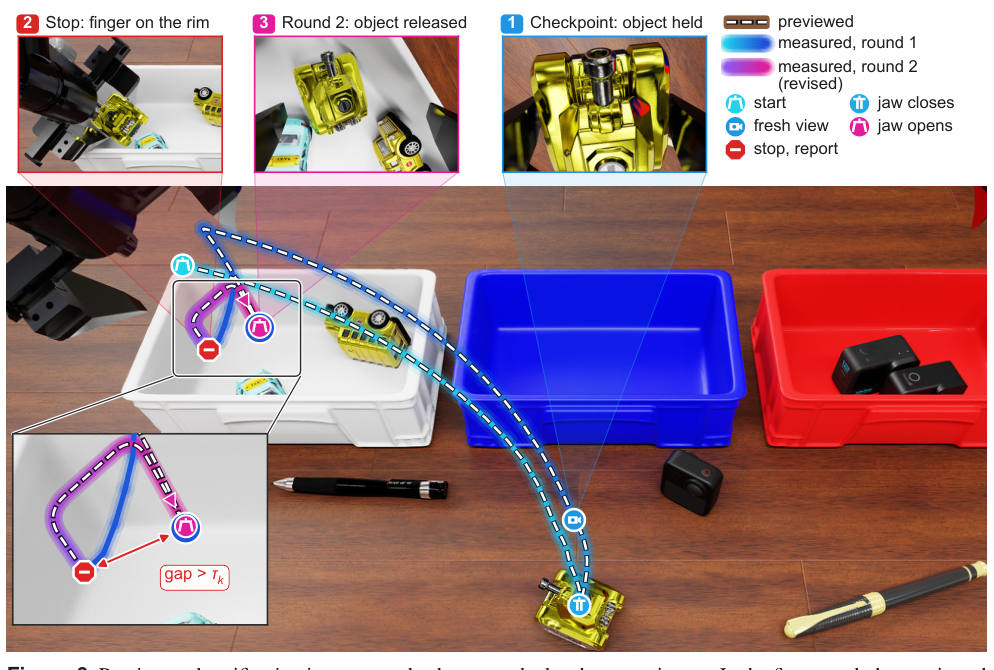
模块 1:唯一入口的执行网关(admission gateway)。所有让机器人动的请求,无论模型直接发出还是模型写的 Python 程序发出,都必须经过它(→ P.9)。流程是:先在仿真暂停时把整段多阶段动作规划成轨迹预演,画在相机图上并给出耗时和间隙警告;模型同意后原样回放,不再重新规划;每个阶段到位后比较实际位置和预演位置,超过模型设定的容差(默认位置 10 mm、姿态 0.15 rad)就停下,返回“回执”:哪一段没到位、差多少、哪些段还没执行,并附新画面(→ P.12–13)。模型还可以自己插入检查点,比如抓起后看一眼手里有没有东西。
模块 2:显式任务信念(task belief)。模型维护一份简短的工作笔记:计划、当前关心的不确定点、以及几条关键前提,每条前提标为待定、已支持、被否定或未知(→ P.10)。完整的交互记录放在上下文之外,需要时再检索。用文字说核心公式:模型每一步根据“任务描述 + 当前信念 + 证据记录”选一个工具调用;只看不动的调用不改变世界,动手的调用必须经网关并把回执写进证据记录(→ P.8–9 式 1–3)。
模块 3:可读的物理量与以手指为参照的动作。VGGT-Omega 估计深度(按已知桌面高度校准尺度),SAM 3.1 分割物体,给出每个物体的 3D 位置、朝向、尺寸和可靠度;需要更准时,模型在图上点一个点,用射线与已知高度平面求交,或在第二个视角里再点一次做三角化(→ P.14–15)。动作目标写在手指接触点上而不是手腕上,两只手臂共享一条时间线(→ P.15–16)。
实验
本文方法 对比方法 · 数据来源:Table 4, P.18
本文方法 对比方法 · 数据来源:Table 5, P.20
本文方法 对比方法 · 数据来源:Table 10, P.23
数据与指标:RoboDojo 有 42 个任务、5 个能力维度(泛化、精细、长程、记忆、开放),3 个随机种子共 6,300 集;指标为成功率 SR(%,越高越好)和过程分 Score(0–100,越高越好)(→ P.16)。RoboCasa365 在 10 个没见过的厨房里测 50 个任务、250 集,指标为 SR(越高越好)(→ P.17)。所有 agent 方法都用 GPT-6 Astra。
主结果:RoboDojo 上平均 Score 64.00、SR 57.74%,排榜首,高于结合世界动作模型(WAM)的 GO-3 Nano Preview(61.90、56.42%);同模型参考接口只有 28.97、22.48%(→ P.18 表 4)。但在精细操作维度仍明显落后:SR 38.50%,对方 76.00%。
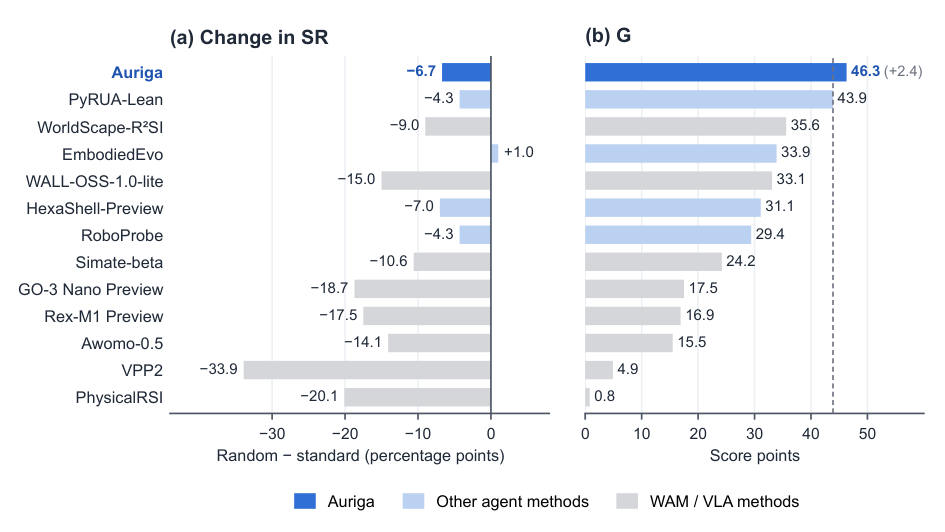
场景随机化:标准场景 52.28% → 随机场景 45.61%,综合泛化指标 G 最高(46.27);学习型策略 VPP2 下降 33.9 个百分点(→ P.19、P.20 图 9)。不过其他 agent 方法降幅也小(PyRUA-Lean −4.3),稳健性更多来自“agent + 工具”这一路线本身。
RoboCasa365:总体 73.2%,高于把接触阶段交给 RLDX-1 VLA 的 RPent(59.2%)和 PyRUA-Lean(56.4%);多步组合任务 62.5% vs 43.1%(→ P.20 表 5)。67 次失败中 23 次耗尽 100 次模型请求,44 次是模型连续几轮不再动作(→ P.21)。
消融(各在 10 个任务的 30–50 集子集上):去掉几何工具 46/50→30/50;去掉预演 42/50→36/50;去掉碰撞间隙检查 36/50→31/50;程序直接控机器人、不走预演和回执(code as policy)30/30→20/30(→ P.22–23 表 6–10)。去掉“偏差即停”只从 36/50 降到 34/50,样本小,差异不算确定。
代价:每集平均 47.5 次模型调用、5.63M 输入 token(85.4% 命中缓存)、18.8 分钟,比 PyRUA-Lean(25.7 次、12.7 分钟)更贵(→ P.24 表 11)。在 swap_T 上每集只发 3.1 次执行批次,参考接口要 33.4 次(→ P.25 表 12)。
要点 Take-home
- 瓶颈在执行:同一大模型免去手臂时成功76%,用参考接口只有22%。
- 动作先预演、按容差执行、超差即停并回报,零样本成功率翻了一倍多。
- 3D几何测量贡献最大,去掉后消融子集成功数从46降到30(共50)。
- 代价是慢:每集约47次模型调用、19分钟,且只在仿真里验证过。
Claude 读完全文后的提炼。
更多:先读哪 · 值得看的理由 · 质疑
先读哪
先看第 2 页图 1 和第 8 页图 4,再看第 18 页表 4
值得看的理由
- 同一个 GPT-6 Astra,换成本文工具层后 RoboDojo 平均成功率从 22.48% 升到 57.74%,说明瓶颈主要在执行接口 → P.18 表 4
- 消融逐项可查:去掉 3D 几何工具 46/50→30/50,去掉预演 42/50→36/50,且代码与项目页已公开 → P.22 表 s 6, 8
质疑
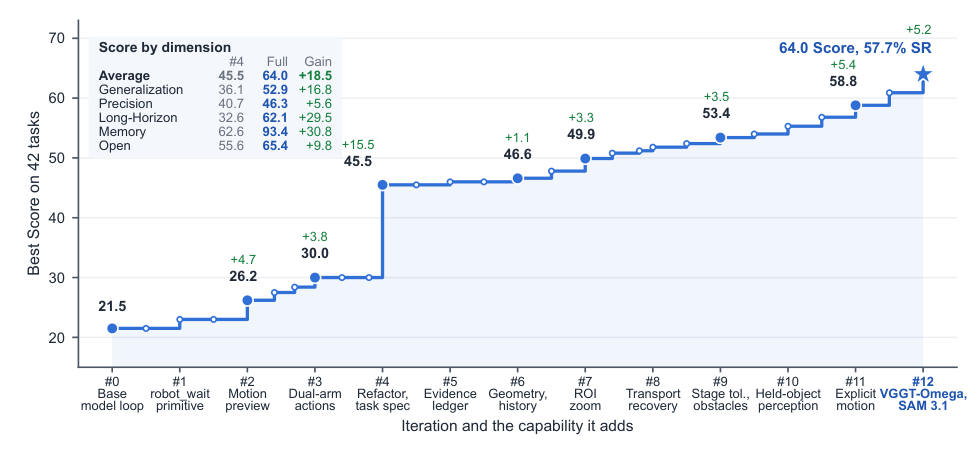
- “零样本”只指单集不试错:13 轮工具迭代都在同样 42 个 RoboDojo 任务上打分,基准本身并非留出集 → P.7 图 3
- RoboCasa365 上模型可读任务成功判定的源码和实时谓词值,未说明 VLA 基线是否同样使用 → P.17 第 6.1.2 节
审稿人笔记
所有实验都在仿真里进行,且模型思考时世界是暂停的,搬到不会暂停的真机上延迟如何还没有回答。