Type 1 · Directly applicable 证据 A 收录
MOST: Memory of Object States and Task Progress for Long-Horizon Mobile Manipulation
发布 · 收录于 2026-11-04
长程操作的记忆不在于存更多画面,而在于记住“哪些物体变了、任务做到哪一步”。把这两类标签当成训练时的辅助监督,策略就更会数数,也更能按顺序做完多步任务。
- 任务
- 长程(多分钟、多阶段)移动操作
- 数据
- RoboCasa365 的 50 个任务 + 自建 RoboCasa-Long 的 3 个任务
- 硬件
- Galbot G1 轮式机器人(真机实验固定底盘)
- 代码
- 已开源:GitHub、项目页、HuggingFace 数据集
- 主要数字
- 真机平均成功率 6.66% → 43.33%
证据等级 A · 真机 + 多基准 + 消融 (A 真机 + 多基准 + 消融 / B 仿真充分 / C 单一基准或无代码)
动机
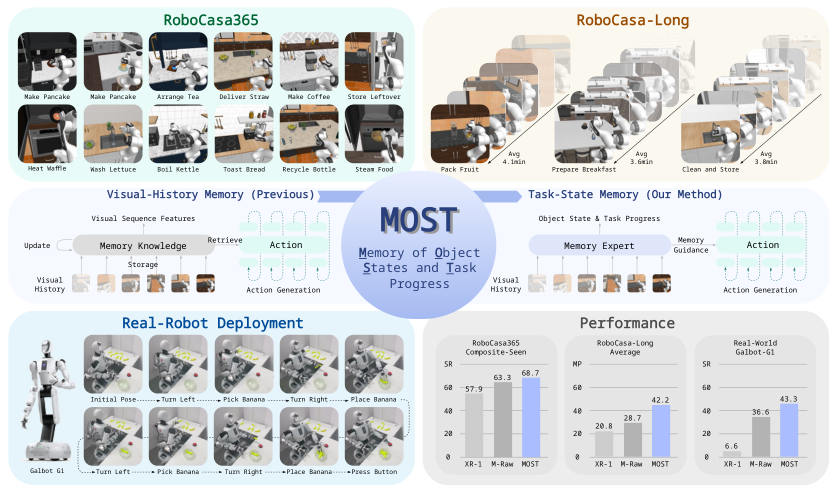
机器人做长任务时,关键信息常常已经不在画面里:香蕉已经放进碗里、柜门已经关上、第二步早在几分钟前就做完了。如果策略记不住这些,就会重复动作、跳过步骤,或者过早停下(P.2)。
已有做法主要在“多记一点”上下功夫:循环状态、测试时训练(test-time training,推理时继续更新部分参数)、存下过去的画面再检索。可是历史画面又长又重复,而且随视角变化;两个阶段可能看起来一样,下一步该做的事却不同(P.2)。
作者因此换了个问题:不问“记多少”,而问“哪些信息应该留下来”。他们的答案是两类:任务进度(做到哪一步、哪些已经完成)和物体状态(相关物体被动作改成了什么样)。标准的 RoboCasa365 片段太短,对记忆考验不够,所以作者还另建了平均 3.8 分钟的 RoboCasa-Long 基准(P.3、P.14)。
方法
- 1压缩历史每 0.8 秒把三个视角压成 1 个 token
- 2加未来查询追加 16 个查询来预测之后的状态
- 3辅助监督每个 token 预测子任务和各物体状态
- 4注入动作逐层门控交叉注意力送给动作专家
- 5推理去掉监督头,缓存已完成的块
比喻:做一顿饭,与其回放刚才的整段录像,不如手边放一张勾选清单:“面包已烤、牛奶已放、第 2 根香蕉已进碗”。MOST 训练策略自己在脑子里维护这张清单。
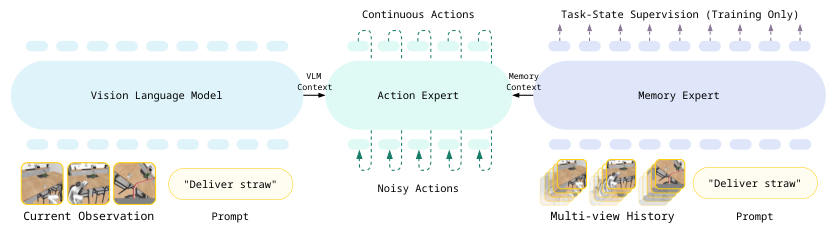
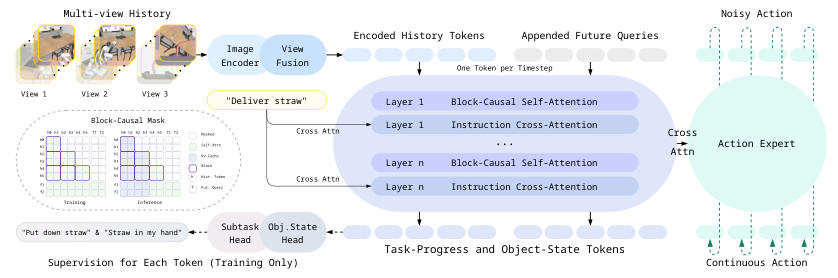
1. Memory Expert(记忆专家):把过去的多视角画面用 DINOv2(一种自监督图像编码器)提取全局特征,再用一个可学习的查询把三个视角合成 1 个 token(模型处理的一个向量单位)。这样记忆长度只随时间增长,和视角数、图像块数无关。这些 token 之间用块因果注意力(block-causal attention):每 8 个 token 组成一块,块内互相可见,块与块之间只能看过去。每层还会和指令做交叉注意力(cross-attention,让一组向量去“查询”另一组向量)。推理时已完成的块被缓存,旧的 RGB 帧编码后直接丢掉(P.5、P.13)。
2. 未来查询 + 任务状态监督:在历史 token 后面再接 16 个“未来查询”。训练时,每个 token 都要预测当时的子任务(如“把吸管放下”)和每个相关物体的状态(如“在手上”“在托盘上”“柜门已关”);第 k 个未来查询预测 t+kΔ 时刻的标签。总损失 = 动作损失 + λ×子任务分类损失 + λ×物体状态分类损失。仿真标签由模拟器特权信息自动生成,真机标签靠人工标注;标签词表是闭集。推理时监督头全部去掉(P.6、P.14-16)。
3. 记忆注入动作:动作专家的每一层都去读对应层的记忆输出,用一个初始化为 0 的可学习门控系数加权。训练开始时记忆不干扰原模型,之后再逐渐打开(P.5)。
实验
本文方法 对比方法 · 数据来源:Table 3, P.7
本文方法 对比方法 · 数据来源:Table 5, P.9
本文方法 对比方法 · 数据来源:Table 4, P.8
设置:RoboCasa365 的 50 个任务(18 个原子任务、16 个见过的组合任务、16 个没见过的组合任务),每任务 50 或 500 条示范(Target-10% / Target-100%);RoboCasa-Long 的 3 个任务,每个 200 条示范;每个任务评测 30 次 rollout。对比对象:无记忆的 XR-1(之前的最强模型),以及 MOST-Raw(同样保留历史画面 token 和记忆通路,但去掉任务状态监督和未来查询)(P.6-7)。
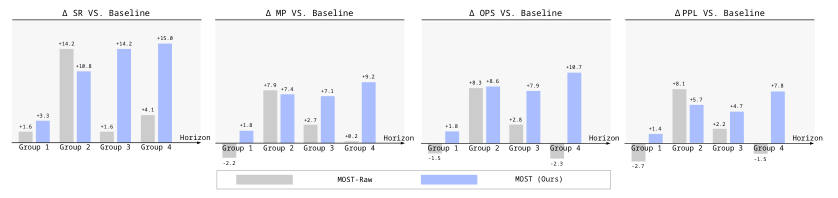
指标:SR 是成功率;MP 是一次执行中达到的最大进度;PPL 是兼顾进度和路径效率的分数;OPS 是按规定顺序完成的子任务比例。以上都是越高越好(P.7、P.16-17)。
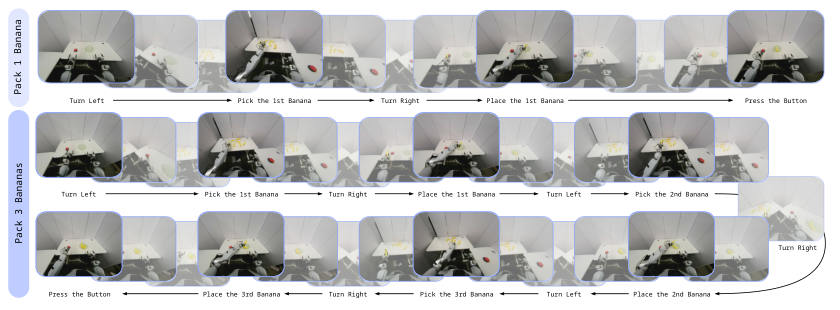
结果: - RoboCasa365 平均 SR:Target-100% 下 XR-1 为 65.9%,MOST-Raw 为 68.0%,MOST 为 72.1%;Target-10% 下依次为 49.6%、51.9%、54.6%,MOST 在每个子集都最好(P.6 表 1)。 - 按示范长度把任务分成四组,在最长的两组,MOST 的 SR 比 XR-1 高 14.2 和 15.0 个点,MOST-Raw 只高 1.6 和 4.1 个点(P.7 图 4)。 - RoboCasa-Long:XR-1 和 MOST-Raw 的完整成功率都是 0,MOST 平均只有 6.66%;但平均 MP 从 20.83% 提到 42.22%(P.7 表 3)。 - 记忆内容消融:只预测当前任务状态(56.45)反而不如没有记忆(57.91);同时监督子任务和物体状态的完整轨迹最好(68.75)(P.8 表 4)。 - 真机:同一个策略学会拿 1、2、3 根香蕉后按按钮,每个任务 10 次(P.9 表 5)。
站得住的结论:同结构对比(MOST 对 MOST-Raw)和表 4 的消融,支持“记忆内容比记忆长度更关键”。要打折扣的地方:只有一个随机种子;长任务的完整成功率很低;真机实验没有移动底盘。
代价:论文没有报告推理速度。训练用 8 张 A800;记忆专家为 384 维、36 层(P.13)。
要点 Take-home
- 记忆关键在记对内容:物体状态加任务进度,比单纯存历史画面更有效。
- 任务越长收益越大:最长两组任务的成功率比无记忆基线高约 15 点。
- 多分钟厨房任务的最大进度从 20.8% 升到 42.2%,但完整成功率仍不到 10%。
- 需要闭集的子任务和物体状态标签,仿真里可自动生成,真机要人工标。
Claude 读完全文后的提炼。
更多:先读哪 · 值得看的理由 · 质疑
先读哪
先看第 1 页图 1 和第 8 页表 4,再看第 9 页表 5
值得看的理由
- 把“记什么”和“记多少”分开做了受控对比:结构相同,只加任务状态监督和未来查询,SR 就从 63.33 升到 68.75 → P.8 表 4
- 真机数香蕉任务的平均成功率从 6.66% 升到 43.33%,代码、项目页和数据都已公开 → P.9 表 5
质疑
- 所有训练只用一个随机种子(42),没有报告方差;部分设置下 MOST 只比 MOST-Raw 高 2-3 个点(如 Com-U-100% 的 SR 是 64.79 对 62.29) → P.13 App. A.2;P.6 Table 2
- 标题写的是移动操作,但真机实验固定底盘、只靠转腰切换桌子,每个任务只跑 10 次 → P.9 第 4.5 节
审稿人笔记
它的物体状态标签(在柜里、在手上、柜门开关)相当于把场景图的边更新隐式地压进了策略,适合拿来和显式记忆方案做对照。