Type 1 · Directly applicable Must-read 证据 C 收录
WorldSketch: Sketching World Models for Zero-Shot Mobile Manipulation
发布 · 收录于 2026-11-03
与其让 VLM 直接写动作,不如让它画一个只含任务相关部件的运动学“世界草图”,再交给几何规划器算抓取和全身运动。
- 任务
- 零样本移动操作(开门、拉抽屉、拧旋钮、按按钮、抓放)+ 指令导航
- 数据
- RoboCasa365 30 个任务 90 回合、LIBERO-PRO 150 回合、R2R-CE
- 硬件
- 仿真 PandaOmron:Panda 臂 + 全向底盘 + 升降躯干,RGB-D 相机
- 代码
- 论文中未给出代码或项目页
- 主要结果
- 厨房 91%,次优零样本基线 33%,两个训练过的 VLA 为 44% 和 39%
证据等级 C · 单一基准或无代码 (A 真机 + 多基准 + 消融 / B 仿真充分 / C 单一基准或无代码)
动机
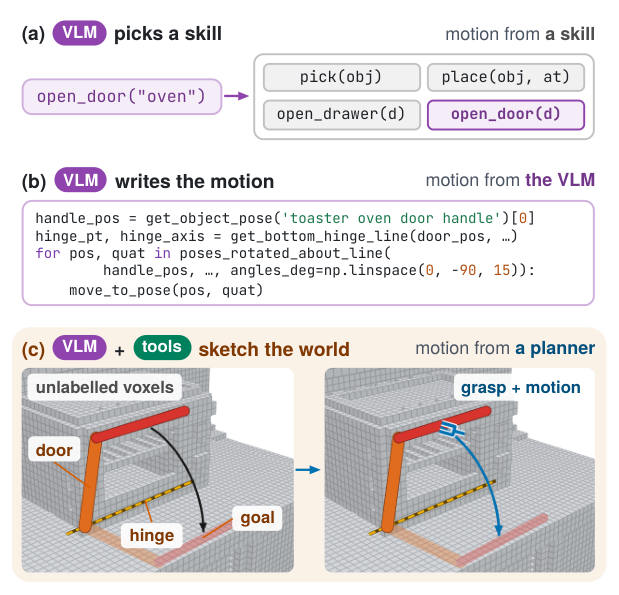
现在的“智能体机器人”里,视觉语言模型(VLM,能看图又能读写文字的大模型)通常只干两种活:
- 挑技能:从现成技能库里选下一步调用哪个。问题是技能库没有的动作就做不了。
- 写动作:直接写关键点约束、路径点或控制代码。问题是 VLM 要自己算精确的几何和接触,比如门绕铰链转出的圆弧,它很容易算错(→ P.1-2)。
另一条路是视觉-语言-动作模型(VLA,用大量机器人示范数据训练、直接输出动作的模型),但它换个布局或换个任务就容易失效(→ P.1)。
这篇论文问:能不能让 VLM 只回答“机器人需要知道世界的什么”,而把“怎么动”交给擅长几何的规划器?
方法
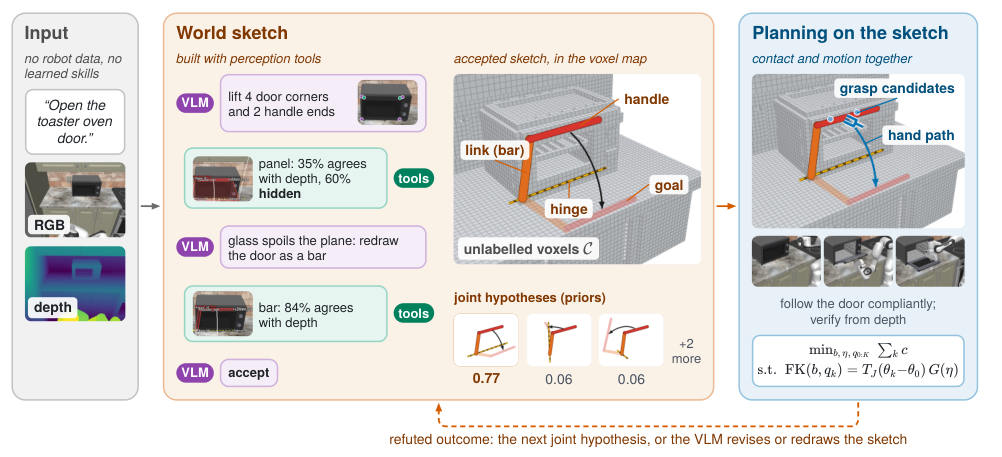
- 1读指令拿到指令和头部、手腕相机 RGB-D 图
- 2要测量VLM 在图上点出角点、把手、旋钮等
- 3画草图写出连杆、部件、关节轴和目标角度
- 4自检草图画回图像、和深度比对后修改
- 5规划联合优化抓取点、底盘位置和手臂轨迹
- 6执行验证柔顺跟随,看深度变化确认,失败换假设
比喻:像木匠接活前在纸上画草图,只画要动的那扇门、它的把手和铰链,厨房其他东西一律当成“别碰到”的障碍物。
1. 世界草图(world sketch)(→ P.5 定义 1)由三部分组成:没有标签的碰撞体素 C(体素就是三维小方块)、任务实体 E、目标 g。每个铰接实体是“一个关节 + 一个连杆 + 一个受力部件”:关节分转动或平移,有轴方向、轴上一点和当前状态;连杆是门板、抽屉面板或拉杆;部件是机器人下手的地方,比如把手、旋钮、按钮。厨房里有上千个几何体,但草图中位数只有 1 个实体、2 个基本形状(→ P.13)。
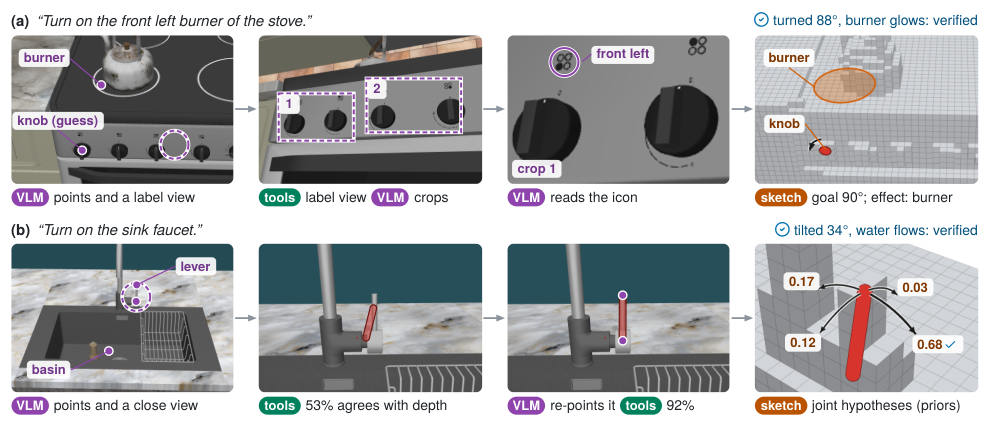
2. 靠“要测量”而不是“全场分割”来搭草图(→ P.6-7)。VLM 在图片上点像素,后端用深度把点抬到三维,并按点的类型拟合(平面、凸起的小部件等)。VLM 只写名字和结构,不写数字,轴、原点、尺寸都由测量算出。每次搭完,系统把草图画回所有图像并做深度检验,标出哪部分与深度吻合、悬空或被挡,VLM 看了再改。图片看不出的机制(比如水龙头拉杆是往上抬还是往旁边扳)就保留成多个关节假设,各带一个先验概率。
3. 执行中修正(→ P.7 式 1)。每做一次动作,验证器对比前后的深度和外观;结果(成功、动了但没效果、被顶住等)按贝叶斯规则更新各假设的概率,比如“被顶住”会让“方向反了”的假设变得更可能。所有假设都被否定时 VLM 改草图;整次尝试失败就回到起点,开一个新会话重画。
规划器(→ P.7-8 式 2)把抓取位置、底盘摆放和沿关节弧线的手臂轨迹放在一起优化:约束是在每个关节角度采样点上,手的位姿都等于“抓取位姿跟着连杆一起转过去”的位置,同时满足与门、框和障碍物的间隙。执行时用柔顺控制小步跟着真实的门走,并边走边重新拟合铰链,所以草图偏几厘米也能成功(→ P.13)。
实验
本文方法 对比方法 · 数据来源:Table 1, P.9
本文方法 对比方法 · 数据来源:Table 3, P.12
本文方法 对比方法 · 数据来源:Table 6, P.16
厨房(RoboCasa365,90 回合,成功率越高越好)(→ P.9 表 1):本文 82/90(91%),换另一个 GPT-6 模型也是 82。零样本基线 CaP-Agent0 33%、Code as Policies 9%、ReKep 6%;用示范数据训练过的 GR00T N1.5 为 44%、π0.5 为 39%。本文每回合 5.4 次 VLM 调用、88k 输入 token、7.1 分钟;CaP-Agent0 要 81 次、872k token、17 分钟。两次运行有 12 个回合结果不同,差两三回合属于正常波动(→ P.10)。
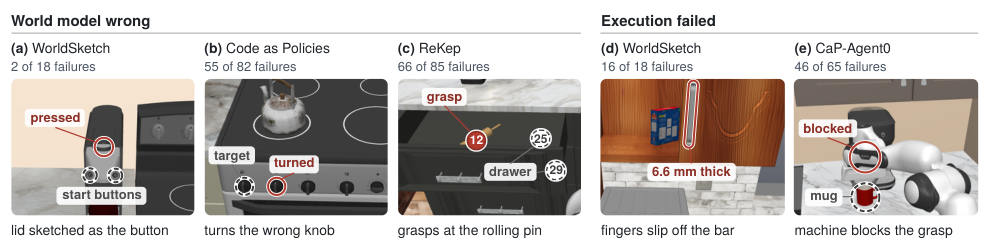
失败在哪里(→ P.14 表 5):本文 18 次失败中只有 2 次是草图错,其余多是手指从细把手上滑脱、物体太宽等执行问题;Code as Policies 和 ReKep 的失败多数是认错了部件或位置。
桌面(LIBERO-PRO,150 回合)(→ P.11 表 2):本文 146 次,CaP-X 自带的智能体 23 次。但作者自己的编程智能体用同一规划器拿到 147 次,说明在物体已被深度聚类分开的桌面上,草图本身优势不大。
消融(→ P.12 表 3、P.13):用点而不是分割掩码定位,首个草图正确率 71% 对 46%;不做“画回图像自检”时,回放实验中正确率从 80% 降到 58%。VLM 本身是上限:Claude Sonnet 5.5 只有 38% 的草图正确。注意多数消融用的是较早版本、不同回合,只能和各自的参照比。
导航(R2R-CE 未见环境,SR 成功率越高越好,SPL 路径效率越高越好)(→ P.16 表 6):100 个 Open-Nav 回合 SR 75.7%,376 个未用于开发的回合 76.9%,与逐步问 VLM 的方法持平,但 VLM 调用只要约 1/5;SPL 57.5%,比 Dai et al. 的 65.6% 低,路线更绕。
代价:一次 VLM 调用中位 15 秒;厨房回合中规划占最多时间(约 157 秒)(→ P.31 表 10)。
要点 Take-home
- 让 VLM 描述世界而非直接出动作,厨房成功率 91%,写代码智能体仅 33%。
- 用点而不是掩码去定位小部件,并把草图画回图像自检,是草图准确的关键。
- 草图不必精确:执行时柔顺跟随真实的门并重新拟合铰链,能补上几厘米误差。
- 目前只在仿真中验证,1 厘米深度噪声就让成功率明显下降。
Claude 读完全文后的提炼。
更多:先读哪 · 值得看的理由 · 质疑
先读哪
先看第 3 页图 2,再看第 9 页表 1 和第 14 页表 5
值得看的理由
- 同一个 VLM 下,RoboCasa 90 回合成功 82 次(91%),CaP-Agent0 只有 30 次,而 VLM 调用 5.4 对 81 次、输入 token 88k 对 872k → P.9 表 1
- 关节机制看不清时保留多个假设并带先验,执行结果按贝叶斯规则更新,失败再重画草图,是“动作纠正记忆”的一个具体可用做法 → P.7 第 4.1, Eq. 1 节
质疑
- 标题里领先 58 个百分点是对比只拿到 CaP-X 接口的已发表基线;作者自己用同一套工具写的多轮编程智能体在厨房拿到 61/90,LIBERO-PRO 上 147/150 还略高于本文 → P.35 第 H; Table 2 (P.11) 节
- 全部在仿真里、用无噪声深度;回放实验中 1 cm 深度噪声就让成功从 16 次降到 9/23,离真机还有距离 → P.39 表 22
审稿人笔记
仿真实验很扎实,但没有公开代码也没有真机实验,按规则证据评为 C。