Type 1 · Directly applicable 证据 C 收录
Knowing Where to Look: Interactive Object Search via Spatial-Semantic Fusion
发布 · 收录于 2026-11-03
把 VLM 给出的「这里可能有目标」语义证据和占据栅格的「这里还没看过」几何证据融合成一张 3D 体素信念图,再按预计揭示的信念量选动作,交互式找物比只用几何或只靠 LLM 规划更成功。
- 任务
- 按自然语言描述找到并拿起物体,可开抽屉和柜子
- 硬件
- RB-Y1 双臂轮式人形,ZED 2i 头部相机 + Livox 激光雷达
- 模型
- Gemini 3.1 Pro 打分,SAM3 分割,CLIP 特征
- 代码
- 有项目主页,正文未说明是否开源代码
- 主要结果
- 成功 14/16,几何基线 8/16,LLM 规划器 7/16
证据等级 C · 单一基准或无代码 (A 真机 + 多基准 + 消融 / B 仿真充分 / C 单一基准或无代码)
动机
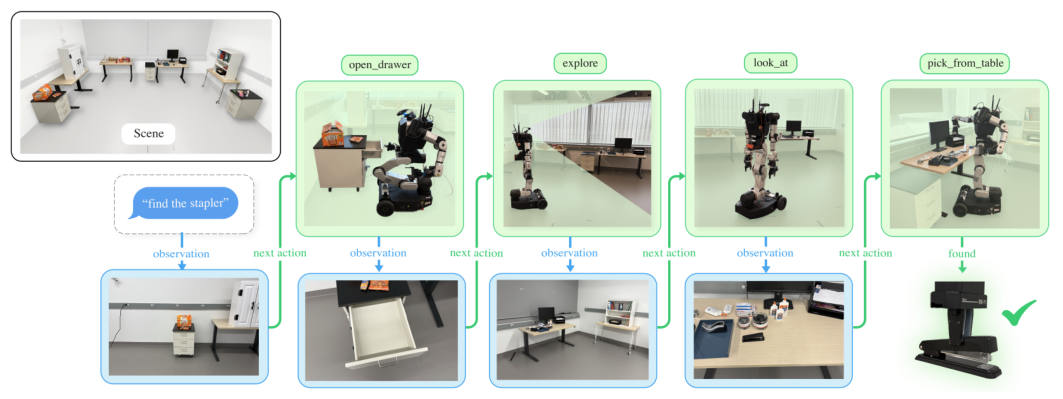
机器人找东西时,目标可能在桌上、在杂物堆后面,或者在关着的抽屉里。现有方法分成两派:
- 几何派(如 GenMOS):维护一张三维概率地图,知道哪里看过、哪里被挡住,但不懂「订书机多半放在办公桌附近」这种常识。
- 大模型派(如 CuriousBot):把场景写成文字或场景图交给 LLM,会用常识,但不清楚哪些空间还没看过、哪里够得着。
人找东西时两种判断同时用。难点在于:VLM 打分本身不稳定,而封闭容器内部从任何视角都看不到,普通的可见性地图会把它们的概率直接设为 0,机器人也就不会去开柜。
方法
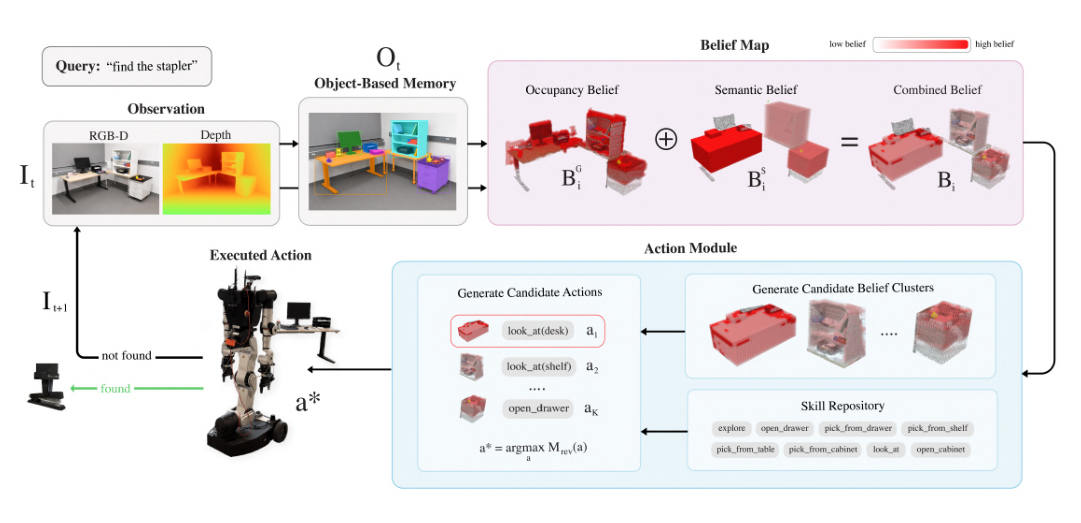
- 1看RGB-D 分割物体,存进物体记忆
- 2问VLM 给每个物体打「藏有目标」分
- 3融语义与几何对数几率逐格相加
- 4选挑预计揭示信念最多的动作
- 5做换视角、去未知区、开柜或抓取
比喻:像在家里找钥匙。你心里有一张「可能性地图」:常识告诉你钥匙多半在玄关抽屉(语义),记忆告诉你哪些抽屉还没翻过(几何)。两者叠在一起,你就先去翻「最可能、又还没看过」的地方。
1. 物体记忆(OBM,object-based memory):每次看到画面,先用 Gemini 给候选框、SAM3 出掩码,再用 CLIP 特征相似度加 3D 框重叠度,把新检测和已有物体对上号。每个物体保存点云、3D 框、特征、图像和文字描述。
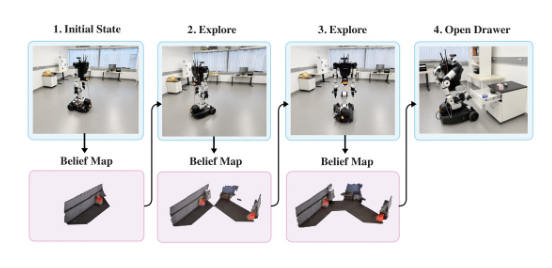
2. 信念图(belief map):三维体素网格,每格存「这里有目标」的对数几率(log-odds,即 log(p/(1−p)),便于把多条证据相加)。 - 几何部分按观测状态取固定值:看过且空 −6.91,被其他物体占据 −4.00,未探索 −2.20,被遮挡未看清 −0.85。 - 语义部分:每看到一个物体,问 VLM「它是不是目标、或里面藏着目标」,得到概率 p,再把 log(p/(1−p)) 累加到该物体的分数上。p 被截断在 [0.001, 0.999],避免一次回答就定死结论。为减少相邻视角的重复证据,只采用与之前相差至少 0.15 m、偏航 15° 或俯仰 10° 的观测。每个格子取所有覆盖它的物体中的最高分。 - 两部分相加得到最终信念。关键在于柜子内部也能分到正的信念,这样信念图才能推动「开柜」动作。
3. 选动作:把高信念的格子聚成若干簇,每簇生成一个候选动作(换个视角看,或打开包住它的容器)。对每个动作,把它会揭开的、尚未观测的格子的概率加起来,得到「预计揭示信念质量」M_rev,贪心地选最大的那个执行。一旦记忆里有物体被 VLM 确认是目标,就去抓取。
实验
本文方法 对比方法 · 数据来源:Table I, P.7
本文方法 对比方法 · 数据来源:Table I, P.7
本文方法 对比方法 · 数据来源:Table I, P.7
场地:约 87 m³ 的真实办公室,分为厨房零食区和办公用品区(第 6 页)。
设置:两类物体(办公用品、零食)× 四种摆放(明处 visible、杂物中 clutter、容器内 container、掉在地上 floor)× 两种初始视角(易/难),每种方法 16 次,共 48 次真机试验,每次限时 15 分钟。
指标:成功率 SR(越高越好);平均动作数 NA(越低越好,只统计成功的试次)。
基线:两者都和本文共用感知、导航和技能库。① 几何基线:改造自 GenMOS,乘法更新体素信念,没有语义先验;② LLM 规划器:仿 CuriousBot 维护语义场景图,由 LLM 选要查看的物体,并用 VLFM 方式挑探索前沿。
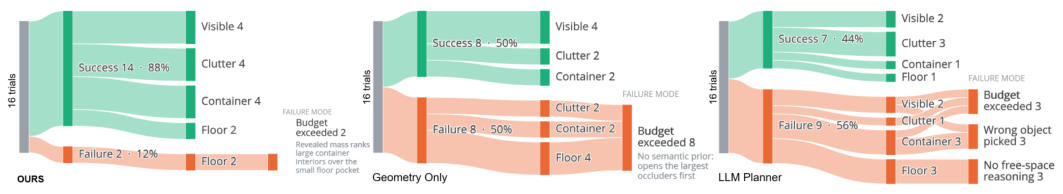
结果(第 7 页表 I):本文成功 14/16,几何基线 8/16,LLM 规划器 7/16。本文在明处、杂物、容器三种设置全部成功,掉地上的 4 次成功 2 次。配对 McNemar 检验 p 分别为 0.031 和 0.016。平均动作数 3.6,几何基线 3.9,LLM 规划器 3.1,所以本文成功更多,但动作并没有更少。
失败分析(第 7 页图 6):几何基线总是先打开最大的遮挡体;LLM 规划器偏爱已见过的物体、不去探索未知空间,还会把橙色课本误认成零食盒。本文的 2 次失败都是地上的胶水瓶:它藏在一个小角落,没有物体覆盖,因此没有语义证据,而 M_rev 按总量求和,偏向揭开大区域的动作。
代价:Gemini 每次打分的中位延迟约 10 s。同一画面重复询问时,54% 的物体分数完全相同,91% 的波动不超过 0.1(第 5 页)。
要点 Take-home
- 把 VLM 打分当作可累加的观测,和占据栅格合成一张 3D 信念图来找物。
- 真机 16 次试验成功 14 次,几何基线 8 次,LLM 规划器 7 次。
- 给关着的柜子内部留正信念,机器人才会主动开柜去找。
- 按揭示信念总量选动作会偏向大区域,小角落里的目标容易漏掉。
Claude 读完全文后的提炼。
更多:先读哪 · 值得看的理由 · 质疑
先读哪
先看第 3 页图 2,再看第 7 页表 I 和图 6
值得看的理由
- 把 VLM 的不可靠打分当作观测做贝叶斯累加,再与占据栅格逐格相加,并给封闭容器内部留正信念,从而能驱动开柜动作 → P.4 第 III-A 节
- 真机上与共享感知和技能库的两个基线比较,成功 14/16 对 8/16 和 7/16,并做了配对 McNemar 检验(p=0.031、0.016) → P.6 第 V-C 节
质疑
- 没有同一框架下的「仅语义」消融,「优于任一单模态」只靠实现差异较大的两个基线支撑;且每种配置只跑一次、只在一个房间 → P.6 第 V-B, Table I 节
审稿人笔记
结论说「更高效」,但成功试次的平均动作数 3.6 多于 LLM 规划器的 3.1。