Type 2 · Promising method Key group 证据 A 收录
Behavior Graphs: Unsupervised Graph Structures for Interpreting Robot Deployment Data
发布 · 收录于 2026-11-03
把策略在部署中产生的大量回放,无监督地压成一张“行为—转移—结果”的有向图,既能让人更省力地找到失败模式、决定补什么数据,又能不训练网络就做出很准的任务进度估计。
- 任务
- 策略回放的失败分析、补数据决策、进度估计
- 数据
- LIBERO、Robomimic、MimicGen、DROID 真机,共 43 个数据集
- 硬件
- DROID 真机平台,3 个真实操作任务
- 代码
- 有交互项目页 try.behavior-graphs.com,论文未写明代码
- 主结果
- 进度估计平均 VOC 0.945(同特征 MLP 0.769)
证据等级 A · 真机 + 多基准 + 消融 (A 真机 + 多基准 + 消融 / B 仿真充分 / C 单一基准或无代码)
动机
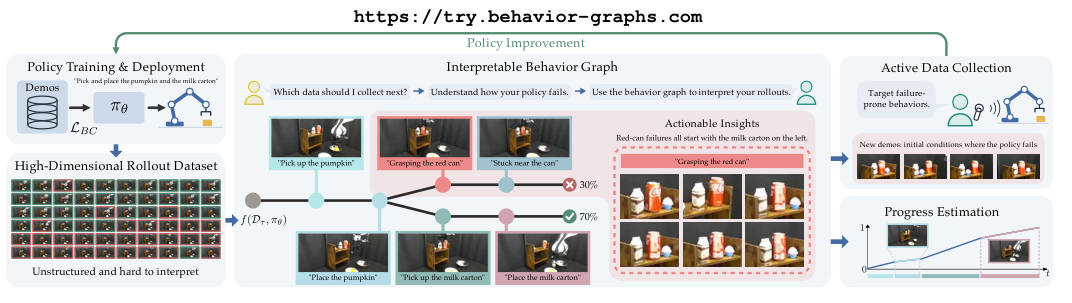
问题:模仿学习策略上线后,要靠“数据飞轮”(data flywheel,即部署→看回放→补采示教→重训的循环)继续变好。可是回放(rollout,机器人一次完整执行的记录)是大量高维视频和动作,人很难看出策略怎么失败、该补哪类数据。
现有方法卡在哪: - 数据筛选(curation)方法只告诉你删掉哪些旧示教,不告诉你下一步该采什么; - 红队测试(red-teaming)主动把输入引向失败,比日常部署更悲观; - DAgger 类方法要专家一直盯着、随时接管,难以规模化。
这些方法都不能帮操作员读懂自主运行留下的回放(→ P.1-2)。
方法
- 1取特征用策略自己的观测编码器嵌入每一步
- 2滑窗平均按时间窗求均值,压掉逐帧噪声
- 3降维聚类UMAP 降维后 K-means 分出 K 种行为
- 4连成图按先后连边,边权是经验转移概率
- 5起名字VLM 看每类的拼图给行为写说明
- 6用起来看失败分支选数据;分段线性估进度
比喻:像把成千上万名乘客的出行记录画成一张地铁线路图。车站是“行为”,线路是行为之间的转换,线有多粗表示多少人走过,车站颜色表示从这里出发最后有多少人顺利到站。
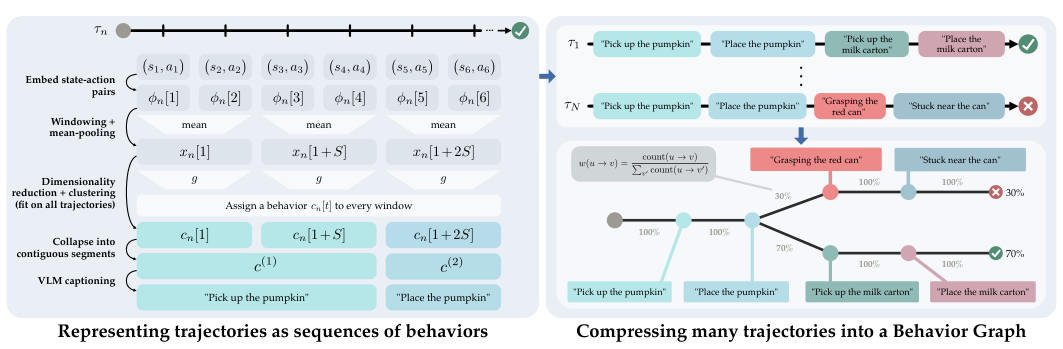
1. 从回放到行为序列(→ P.2-3)。每个时刻的状态-动作对先用嵌入函数变成向量,默认用策略嵌入(policy embedding,即策略网络自己的观测编码器输出)。再用滑动窗口取平均以去噪,用 UMAP(一种非线性降维方法)降维,最后用 K-means 聚成 K 类,每一类就是一种“行为”。相邻窗口同类就合并成一段,于是每条回放变成一串互不重复的行为。
2. 压成一张图(→ P.3 式 3)。所有序列共用一个“开始”节点,终点是“成功”或“失败”。边权就是“从行为 u 出发,下一步去 v 的次数 ÷ 从 u 出发的总次数”。作者也给了前缀树(prefix tree)版本:同样的行为按不同顺序出现会分成不同分支,不需要马尔可夫假设,代价是节点数会变多。之后由 VLM 看每种行为的若干片段拼图(contact sheet)写说明,再自检一遍让全图说明一致(→ P.4)。
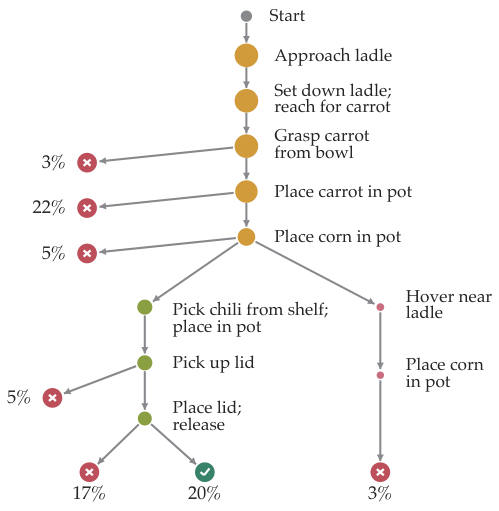
3. 两个读数(→ P.4 式 4-6)。 - 成功可能性:经过某行为的回放里最后成功的比例。又常出现、又常失败的行为,就是最该补数据的地方;把整条路径的边权相乘,还能找出最常见的失败路线。 - 进度估计:借用 SARM 的分段公式,但子任务换成图里自动发现的行为。每个行为分到的进度份额等于它在成功回放里平均占的时间比例,段内进度线性增长。整个估计器只靠统计,不训练任何网络。
实验
本文方法 对比方法 · 数据来源:Table II, P.7
本文方法 对比方法 · 数据来源:Table II, P.7
本文方法 对比方法 · 数据来源:Table I, P.6
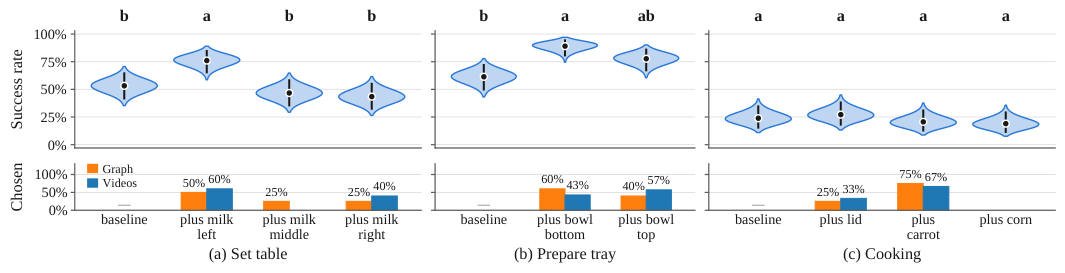
Q1 用户研究(真机)(→ P.4-6)。DROID 平台上 3 个任务:摆桌(训练数据故意缺“牛奶盒在最左”)、备餐盘(考验精确抓取)、做饭(长时程)。18 名参与者每个任务看 60 条回放,分别用行为图或视频浏览器分析,然后选一种补数据策略。作者事先为每种策略各采 30 条示教并重训,用 60 次回放估成功率,因此能算出每个选择的遗憾值(regret,与最佳选项的成功率差,越低越好)。 - 混合效应模型校正后,自评时间压力(越低越好)行为图 38.7 vs 视频 64.8,费力程度(越低越好)38.1 vs 61.0,分别下降 40.3% 和 37.6%。 - 信心(越高越好)61.3 vs 58.8、遗憾值 7.9 vs 7.0,差异的 95% 可信区间都跨过 0:决策质量没有变好,只是更省力(→ P.6 表 I)。 - 第三个任务可自选工具时,16/18 人选了行为图。 - 重训结果显示:只有对准最常见失败模式的数据才有效(摆桌只有“牛奶盒在左”有显著提升;做饭任务任何单一子任务补数据都没有显著差别)(→ P.5 图 5)。
Q2 进度估计(→ P.6-7)。43 个数据集,3 折交叉验证。对比两个 VLM 进度估计器 Robometer、TOPReward,以及在同一策略嵌入上训练的 MLP。指标:VOC 和 Kendall τ(预测进度与真实时间顺序的排序相关,越高越好)、MAE(与线性真值的平均绝对误差,越低越好)、AUC(用最终进度判断成败,越高越好)。 - 平均 VOC 0.945、Kendall 0.923、MAE 0.072,三项都最好;最强基线(MLP)为 0.769、0.629、0.155。 - LIBERO 上 MLP 在 VOC 和 MAE 上略好;AUC 平均是 Robometer 最好(0.824 vs 0.802)。 - 胜过同特征的 MLP,说明“行为结构”本身是有用的先验。
Q3 消融(→ P.7 表 III)。以子任务分割为代理任务(真值用夹爪开合启发式近似),在 3 个真机数据集上比较特征与降维方式。按三种降维取平均,策略嵌入 F1 0.226,好于本体感觉 0.132 和 DINOv3 0.113;降维方式没有一致结论。
代价:不训练神经网络,只做聚类和计数;论文未报告运行时间。
要点 Take-home
- 行为图把上百条回放压成一张图,18 人里有 16 人更愿意用它而不是看视频
- 用行为图分析回放,自评时间压力降约 40%,但选出的补数据策略并不更好
- 不训练网络,只用行为统计估进度,排序相关从 0.769 提到 0.945
- 补数据只有对准最常见的失败模式才有效,否则成功率基本不变
Claude 读完全文后的提炼。
更多:先读哪 · 值得看的理由 · 质疑
先读哪
先看第 1 页图 1 和第 3 页图 2,再看第 7 页表 II
值得看的理由
- 43 个数据集上不训练网络的进度估计,平均 VOC 0.945,高于 Robometer、TOPReward 和同特征 MLP → P.7 表 II
- 真机用户研究为每种补数据策略都重训并实测成功率,能直接验证“补哪类数据才有用” → P.5 图 5
质疑
- 进度真值是成功回放上的线性斜坡,而本法正是分段线性读出,指标对它天然有利;按 AUC 看它并不领先(0.802 vs Robometer 0.824) → P.7 表 II; Sec. IV-B(P.6)
- 消融中策略特征 + UMAP 的 F1 只有 0.160,低于不降维的 0.264,但其余实验都用 UMAP,仅凭定性理由 → P.7 表 III
审稿人笔记
价值主要在“省力和可读”,作者自己也承认在此规模下看视频也能得出同样结论。