Type 1 · Directly applicable Key group 证据 C 收录
SPARK: Self-Correcting Embodied Memory via Physical Re-Observation
发布 · 收录于 2026-11-03
机器人可以不靠真值、只凭自己的记忆和照片找出可疑区域,再飞回去重看,从而修正已经建好的语言可查询记忆。
- 任务
- 具身问答(EQA)记忆的多回合纠错
- 数据
- AirSim 4 张户外地图,固定 158 道问答题
- 平台
- 仿真无人机 RGB-D,位姿取真值
- 代码
- 文中未提及开源
- 主结果
- 平均 EQA 0.306 → 0.531(一次纠正)
证据等级 C · 单一基准或无代码 (A 真机 + 多基准 + 消融 / B 仿真充分 / C 单一基准或无代码)
动机
问题:机器人常把看到的东西存进一个可以用语言查询的知识库(KB),再用 RAG(检索增强生成:先从资料库查资料再回答)回答问题。但知识库来自有噪声的感知,会漏掉物体、贴错标签、放错位置。
现有方法卡在哪:多数系统把第一次建好的知识库当成可靠的,或者后面只往里追加新观测,从不改旧错误。有的方法只在已有点云或关键帧里“重新解读”,无法补上当初根本没看清的地方;有的只在某个问题答不上时才去探索,不会主动体检整个记忆(P.2–3)。
为什么难:机器人看不到真值,只能凭自己的记忆和照片判断哪里可能错了,还要决定去哪里重看、怎样改写才不把对的内容也删掉。
方法
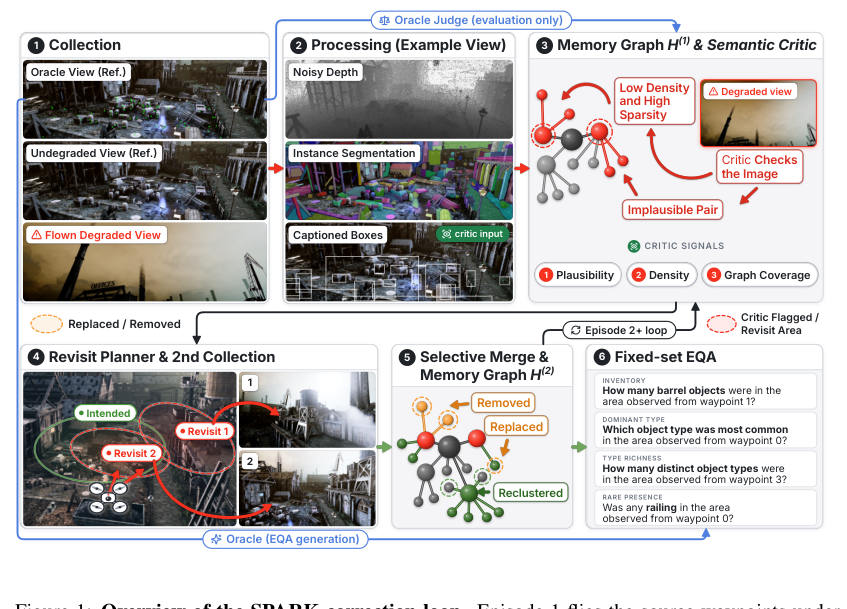
- 1首次采集退化视角拍 RGB-D,建层级记忆
- 2批评诊断合理性、密度、覆盖三信号标问题区
- 3规划重访在原航点转向问题区,前进或后退
- 4选择合并替换重见物体、补漏,双证据才删
- 5问答评估同一套题比较纠正前后得分
比喻:像学生课后检查笔记:先圈出看着不对劲的页,再回到黑板前重看那几块,最后擦掉错的、改写模糊的、补上漏记的。
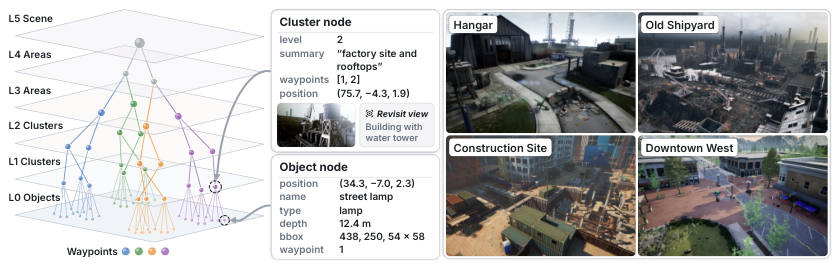
1. 记忆怎么建:沿用 Embodied-RAG 的层级记忆(物体 → 簇 → 区域 → 场景)。不同的是,记忆只来自机器人自己的传感器:SAM2(一个不分类别的图像分割模型)切出候选物体,VLM(视觉语言模型,这里是 gpt-5-mini)给每块起名字,再用深度反投影到世界坐标(P.4–5)。为模拟真实传感器,深度加了随距离平方增大的噪声(P.17)。
2. 语义批评器(critic):不看任何问题,也不看真值,用三个信号找可疑区域(P.5、P.15): - 合理性:VLM 对着照片给每个标签打 0–1 分,低于 0.6 标记; - 密度:VLM 估计照片里能看到多少物体,记忆里存的不到估计数的 0.4 倍就标记该航点; - 图覆盖:不调用模型的规则,观测次数少于 2 且成员很少或距离很远(≥40 m)的簇被标记。
3. 重访与选择性合并:规划器让机器人在原航点转向问题区中心,视距离前进 2.5 m / 4 m 或后退 2.5 m,用任务原定的高度和俯仰拍照(P.5)。新检测与同类、2 m 内、来自不同视角的旧物体视为同一个,就替换旧的;找不到匹配就作为漏掉的物体加入;旧物体只有在“被标为不合理”且“重访照片中该位置可见、深度上没被挡住却没检出”两个条件都满足时才删除(P.5、P.14)。
实验
本文方法 对比方法 · 数据来源:Table 1, P.8
本文方法 对比方法 · 数据来源:Table 3, P.9
本文方法 对比方法 · 数据来源:Table 2, P.8
设置:AirSim 中 4 张户外地图(机库、旧船厂、工地、市中心西区),每张 4 个人工挑选的航点。第一回合故意用两种退化视角飞:相机上抬(丢掉近处物体)和低位侧偏(相机压低并偏转 45°)(P.7、P.22)。真值“预言机”(oracle)只用于评分,从不进入批评器、规划器或合并。
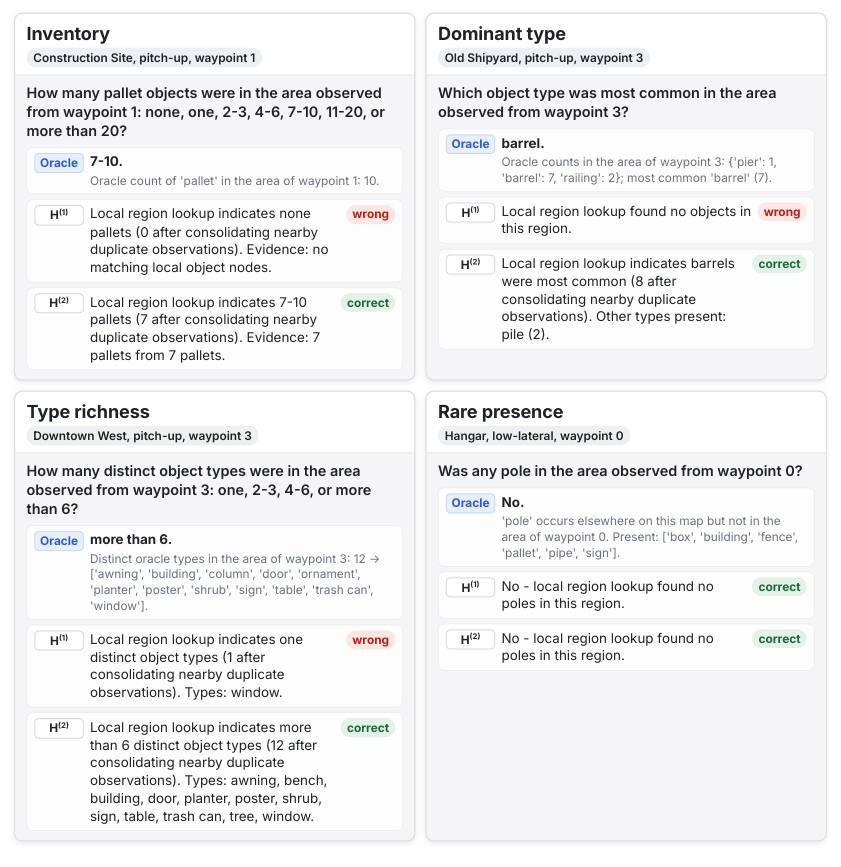
指标:固定的 158 道 EQA 题,分四类(数量、主导类别、类别丰富度、罕见存在),由 gpt-5-mini 按“对 1 / 部分对 0.5 / 错 0”打分,越高越好;每个条件评三次,重复间标准差平均 0.0028(P.7、P.22)。
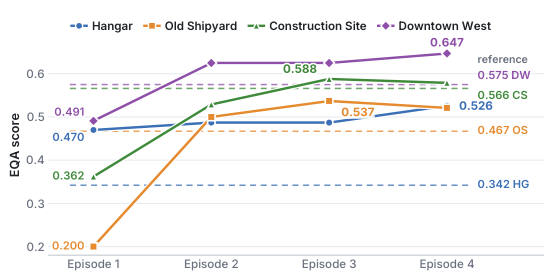
结果: - 一次纠正后,上抬条件从 0.231 到 0.526,低位侧偏从 0.381 到 0.535,平均高于未退化参考的 0.488(P.8 表 1)。注意参考只有一个位姿,纠正后的记忆多了重访视角。 - 合并规则消融:只追加、替换簇、选择性合并的增益几乎一样(+0.294 到 +0.296),但选择性合并平均只存 283 个物体,只追加 391 个(P.8 表 2)。 - 批评器消融:三信号合用召回率 0.800,单用覆盖 0.667、合理性 0.267、密度 0.117(P.9 表 3)。因退化后几乎所有区域都受损,精确率无法定义。 - 重访消融:定向重访平均 +0.154,同预算无目标重访 +0.147,四张图里赢三张(P.9 表 4)。 - 连续四回合:到第三回合四张图都超过各自参考,之后增益变平;但记忆持续膨胀,旧船厂第四回合存了 958 个物体,而真值只有 152 个(P.10)。
代价:文中没有报告耗时或调用费用,只说选 gpt-5-mini 是因为便宜、延迟低(P.18);每个纠正回合最多 30 个视点(P.10)。
要点 Take-home
- 一次针对性重访让四图平均问答分从 0.306 升到 0.531。
- 三种批评信号互补,合用后能找到八成受损区域。
- 选择性合并与只追加得分相当,但少存 13–41% 物体。
- 定向重访只比随机重访略好,记忆仍随回合快速膨胀。
Claude 读完全文后的提炼。
更多:先读哪 · 值得看的理由 · 质疑
先读哪
先看第 4 页图 1,再看第 8 页表 1 和第 9 页表 3、表 4
值得看的理由
- 把记忆纠错拆成诊断、重访、选择性合并三步,删除需要两条独立证据,规则清楚可借用 → P.5 第 3.4.2 节
- 一次纠正让四图平均问答分从 0.306 升到 0.531,存储物体比只追加少 13–41% → P.8 表 1, Table 2
质疑
- 重访在去掉退化的正常位姿上拍摄,而同预算的无目标重访几乎一样好(+0.147 对 +0.154),增益主要来自“换好视角再看一次”,批评器的定位价值尚未被证实 → P.9 表 4, Sec. 6.4
审稿人笔记
只在静态仿真、位姿真值、每图 4 个航点上验证,规模小,结论需在真实机器人和带定位漂移的场景中复核。