Type 2 · Promising method Requested 证据 B 收录
Hierarchical World Models with Implicit Dynamics
发布 · 收录于 2026-11-03
让扩散模型只负责“Δ 步之内能到哪里”,把它的输入噪声当作高层动作来搜索子目标,再用低层世界模型求出具体动作,就能在不需要奖励和价值函数的情况下做长时程规划。
- 任务
- 目标条件的长时程规划:给起点和目标状态,求动作序列
- 环境
- Wall、PointMaze(4 种尺寸)、PushT(推 T 形块),另有视觉版 PushT
- 数据
- 离线、无奖励标注的随机轨迹
- 硬件
- 仅仿真,无真机实验
- 主要结果
- PushT 随机目标成功率 0.77,单层世界模型 0.21
证据等级 B · 仿真充分 (A 真机 + 多基准 + 消融 / B 仿真充分 / C 单一基准或无代码)
动机
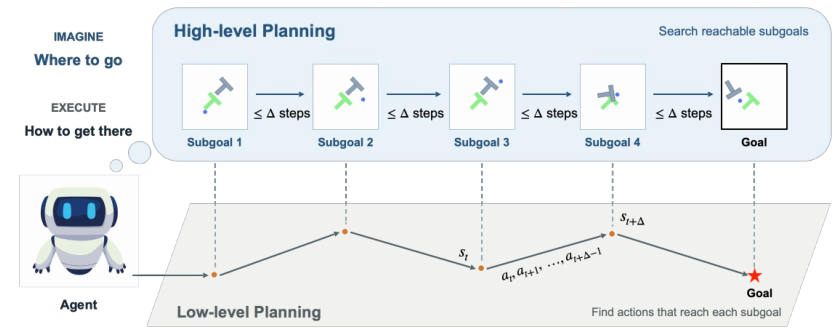
世界模型(world model) 是一个学出来的“环境模拟器”:给当前状态和动作,预测下一步状态。用它做规划,就是在脑子里试各种动作,挑最能到达目标的那串。
问题在于任务一长就不行: - 搜索空间随步数指数增长; - 每一步的预测误差会层层累积(→ P.1)。
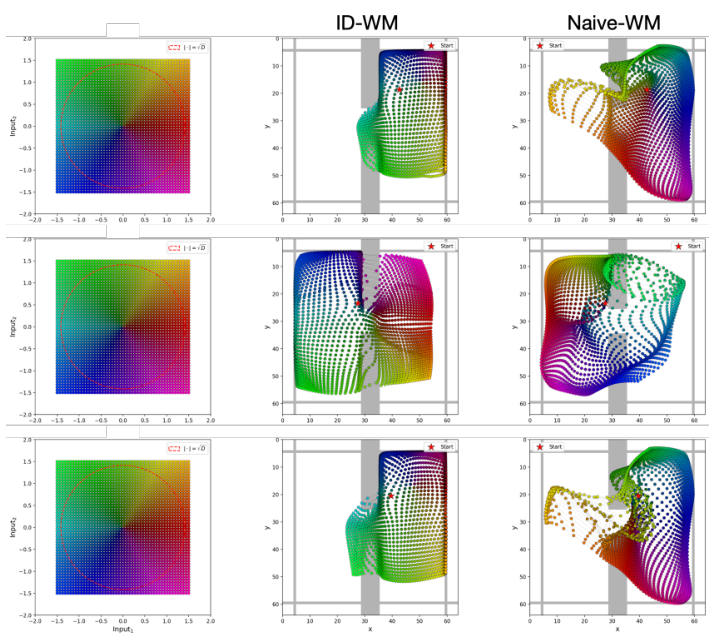
已有的分层方法要么依赖奖励、价值函数或预训练技能来判断子目标能不能到(→ P.2),要么学一套“宏动作”。作者指出,强力的优化器会钻学到的模型的空子,找到现实里不存在的“虫洞”式转移(→ P.2)。所以难点是:高层动作空间既要压缩轨迹,又要“守规矩”,不让规划器搜出假路径。
方法
- 1编码把当前观测和目标编码成潜状态
- 2撒噪声采样一串高斯噪声,当作高层动作
- 3想子目标扩散模型把噪声变成Δ步内可达的状态
- 4搜索CEM调噪声,让最后子目标靠近目标
- 5求动作低层世界模型+CEM找到达子目标的动作
- 6执行重规划执行完一轮后从新状态重新规划
比喻:像在陌生城市走路去远处。高层只问“从这里走 5 分钟能到哪些地方”,每掷一次骰子(一个噪声向量)就得到一个真实可达的落脚点;把几次骰子连起来,看最后离目的地多近。低层再回答“具体怎么走到下一个落脚点”。因为每个骰子结果都落在真实可达的地方,搜骰子比搜一套学出来的宏动作更安全。
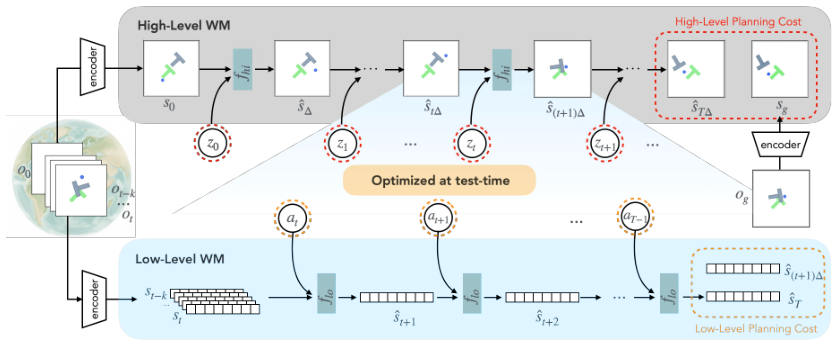
1. 高层:隐式动力学模型(implicit dynamics)(→ P.4-5)。这是一个条件扩散模型(DDPM,一种从噪声一步步去噪生成样本的模型),输入当前状态,生成 Δ 步之后的一个可能状态。推理时用 DDIM(一种确定性的去噪采样方式),于是“当前状态 + 噪声”唯一对应一个子目标。噪声空间是标准高斯分布,平滑、各向同性,作者把它当作高层动作空间。
2. 低层:确定性世界模型(→ P.5)。沿用 DINO-WM 的 transformer 预测器:给过去几步状态和动作,预测下一步。规划时把它当“逆动力学求解器”:用 CEM(交叉熵方法,一种反复采样、保留最好一批再采样的优化法)找一串动作,使预测终点最接近子目标。
3. 噪声正则(→ P.6)。规划代价 = 最后一个子目标到目标的距离 + 一项惩罚:噪声分量绝对值超过阈值 τ 就罚,防止规划器跑到高斯分布的稀有区域,生成不真实的子目标。
实验
本文方法 对比方法 · 数据来源:Table 1, P.8
本文方法 对比方法 · 数据来源:Table 3, P.10
本文方法 对比方法 · 数据来源:Table 8, P.21
指标:成功率 SR(越高越好);PushT 另报 T 块覆盖率 Cov(越高越好);附录还有到达步数(越少越好)和推理时间(越短越好)。每个设置随机采 50 组起点-目标,报 3 个种子的均值(→ P.7-8)。所有实验固定 Δ=5(含跳帧即 25 个环境步)、每次 5 个子目标,不按任务调参(→ P.7)。
对比对象:模仿学习 GCBC、离线强化学习 HIQL、扩散规划 Diffuser 和 H-Diffuser、单层世界模型 MPC(SL-WM),以及同期的分层世界模型 HWM。
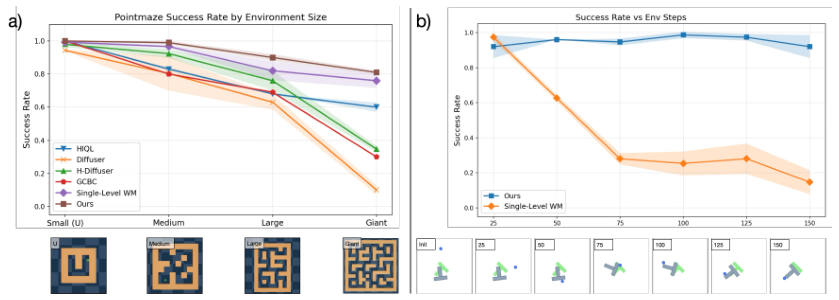
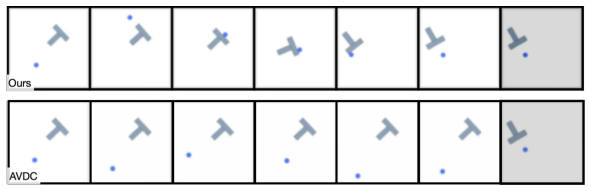
主要结果: - 表 1(→ P.8):本文在每一行都最好或并列最好。差距最大的是 PushT 随机目标,本文 SR 0.77,其余方法都不超过 0.21。GCBC 在固定目标上也能到 1.00,说明真正的难点是分布外目标。 - 和 HWM 比(→ P.9 表 2):PushT 四个设置本文都明显更高(例如随机目标 0.77 对 0.20)。 - 扩展性(→ P.9 图 7):迷宫越大,基线掉得越多,本文下降最少;PushT 目标距离从 25 步加到 150 步,本文接近满分,单层世界模型快速掉下去。 - 视觉 PushT(→ P.10 表 3):目标 25 步远时 HWM 更好(0.96 对 0.90);50、75 步和随机目标时本文最好(如 75 步 0.50 对 0.14)。
站得住的结论:附录把单层和本文的 CEM 预算设成一样,又额外给单层三倍重规划来对齐耗时,单层只从 0.21 升到 0.28(→ P.21 表 8),说明收益来自分层。消融显示 Δ=1 时成功率都不超过 0.10,Δ=5、5 个子目标时 0.96(→ P.20 表 4);噪声正则和更多 CEM 样本都有帮助(→ P.20 图 10)。
代价:到达一个目标的推理时间本文 53.08 s,单层世界模型 16.93 s,HIQL 5.61 s,Diffuser 24 min(→ P.21 表 6,单张 L40S)。路径效率上,迷宫里 HIQL 平均 34.1 步,本文 163.9 步,因为本文代价只看终点距离、不优化路径长短(→ P.20-21 表 5)。
要点 Take-home
- 把扩散模型的初始噪声当高层动作,规划器在平滑的高斯空间里搜子目标。
- 随机目标推T:成功率0.77,单层世界模型0.21,给三倍算力也仅0.28。
- 代价是推理慢:每个目标约53秒,是单层世界模型的约3倍。
- 目前只在二维仿真和64×64图像上验证,还没有真机。
Claude 读完全文后的提炼。
更多:先读哪 · 值得看的理由 · 质疑
先读哪
先看第 2 页图 1 和第 8 页表 1,再看第 21 页表 8
值得看的理由
- 把扩散模型的初始噪声当作高层动作,不靠价值函数或预训练技能就能做分层世界模型规划 → P.5 第 3.1.1 节
- 算力对齐对照说明增益来自分层:单层世界模型给三倍重规划仍只有 0.28,本文 0.77 → P.21 表 8
质疑
- 全部实验是二维仿真小环境,视觉实验仅 64×64 PushT,且 HWM 基线是作者自行复现(官方未开源该版本) → P.18 第 6.4 (g) 节
审稿人笔记
表 1 中 PushT-Aug 随机目标成功率为 1.00,而表 4 同一默认配置为 0.96,两者可能来自不同次运行,引用时注意。