Type 1 · Directly applicable 证据 C 收录
Probing Spatial State Representations in Visual Foundation Models
发布 · 收录于 2026-11-03
视觉基础模型能读出看得见的场景,并不代表它能记住看不见的物体、按运动预测未来,或者把目标用在动作上;这几项要分开测。
- 任务
- 冻结特征探针(probe)诊断四级空间能力
- 数据
- ScanNet++ 室内轨迹,69 个验证场景
- 模型
- 10 种:DINOv2、V-JEPA2、VideoMAE、Fast3R、Wan、Qwen2.5-VL 等
- 硬件
- 无真机,全部为离线评测
- 代码
- 论文首页给出项目页与代码链接
证据等级 C · 单一基准或无代码 (A 真机 + 多基准 + 消融 / B 仿真充分 / C 单一基准或无代码)
动机
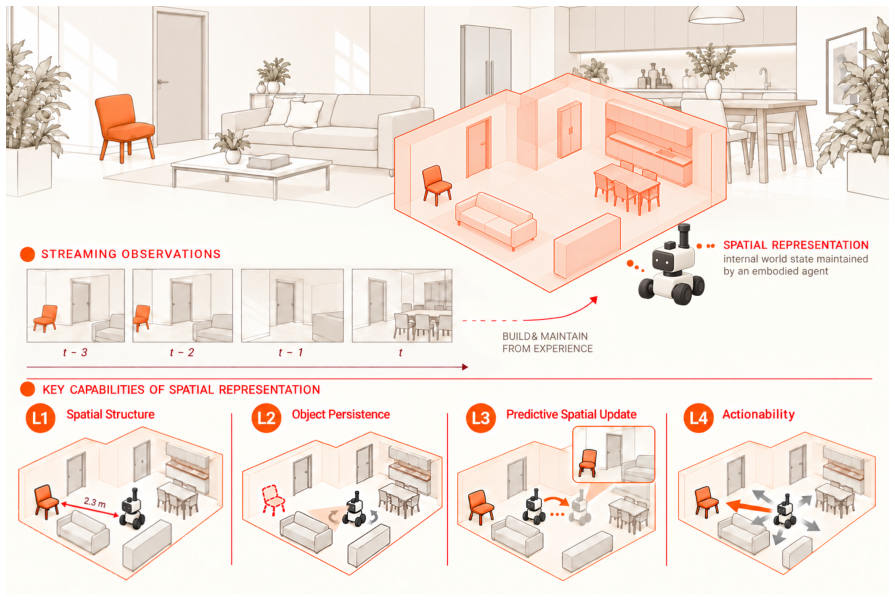
机器人一次只能看到周围的一部分,却要记住视野外的东西,并随自己的移动更新这份“空间状态”。现在评价视觉基础模型的空间能力,多半只看能否从特征里读出深度、位姿这类当前可见的几何。
问题在于:读得出当前画面,不等于能记住离开视野的物体,也不等于能用来选动作。作者想回答:图像编码器、视频编码器、3D 模型、多模态模型、视频生成模型、世界模型,它们的冻结特征里到底有没有一个可用的空间状态?(→ P.2-3)
方法
- 1截前缀取 8/12/16/24 帧的因果视频前缀
- 2冻结编码十种模型抽特征,参数全部不动
- 3训探针浅层读出器回答四级空间问题
- 4做对照换动作、删历史、换目标后再测
- 5比画像按任务、网络层、前缀长度对比
比喻:把模型当成一个刚逛完房间的学生,不许他再学习(冻结参数),只给他配一个很小的“答题器”(探针,probe:在冻结特征上训练的浅层读出网络),看他脑子里的信息能答对哪些题。
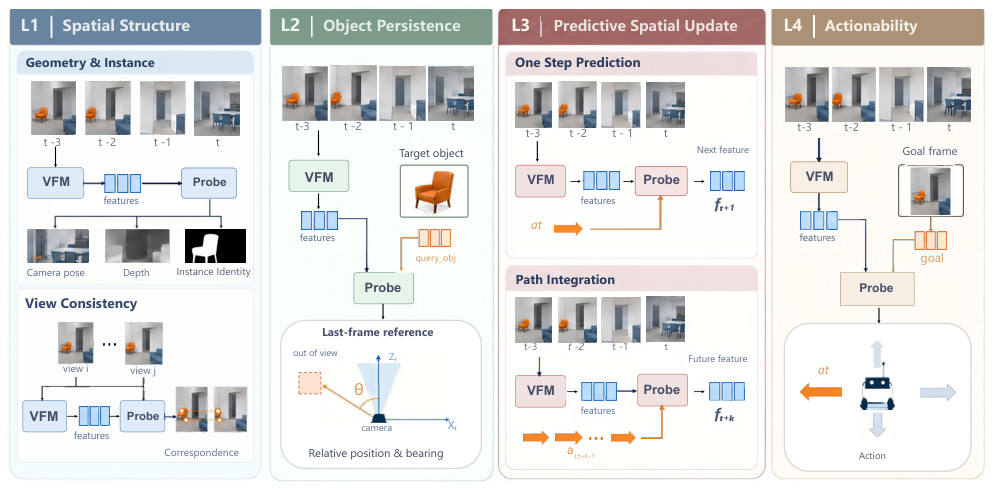
四级题目(→ P.4 图 3): - L1 空间结构:从特征读出深度、相机位姿(camera pose,相机在空间中的位置和朝向)、物体实例区分、跨视角对应。 - L2 物体持久性:一个物体早先出现过、现在已出视野,给出它的查询向量,问它相对当前相机在哪个方位(用角度误差评)。 - L3 预测更新:给出相机接下来的运动,预测未来那一帧的特征;分为一步直接预测和逐步累加运动的路径积分(path integration)。 - L4 可行动性:给当前特征和一张目标图,预测朝目标前进的动作。
关键设计是对照实验:保持探针和目标不变,只改输入,比如给错误的运动、只给当前帧、打乱历史、换成别的场景的目标。如果改了输入结果不变,说明探针并没有真正用到这部分信息。注意:每个前缀是独立编码的,测的是“看过这段历史后的表示”,不是模型在线更新的状态(→ P.3, P.5)。
实验
数据来源:Table 2, P.6
数据来源:Table 4, P.11
数据来源:Table 15, P.25
设置:ScanNet++ 室内轨迹,训练和验证场景不重叠;主表在 276 个验证窗口上平均四种前缀长度,置信区间按 69 个场景做 bootstrap(→ P.5-6)。
指标:深度损失、实例损失、物体持久性角度误差越低越好;位姿 AUC@30、视角一致性平衡准确率、未来特征检索 R@1、动作准确率与正向前进比例越高越好。
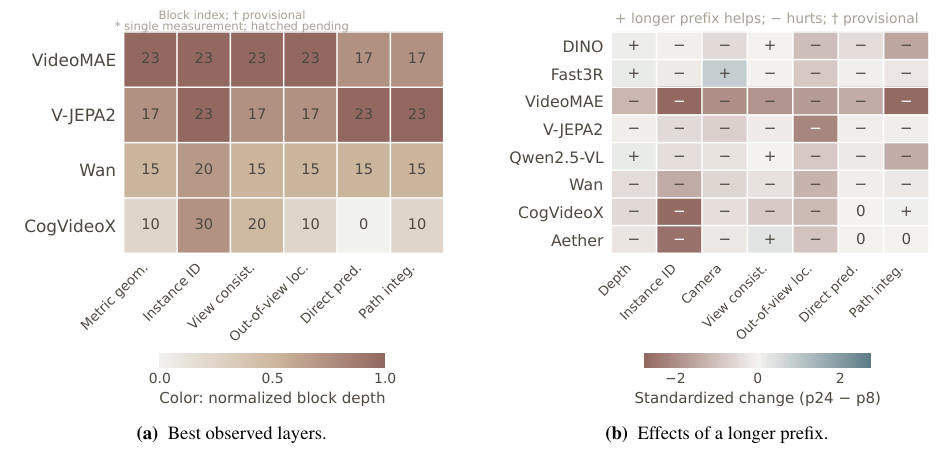
主要结果(→ P.6 表 2): - 没有模型全面领先。Fast3R 位姿 AUC@30 0.3870、持久性误差 32.79° 都是最好;DINOv2 直接预测 R@1 最高(0.2373),但位姿只有 0.0412、持久性误差 65.38°;V-JEPA2 路径积分最好(0.1588)。 - VideoMAE 的深度、实例、视角读出都弱于 DINOv2 和 Qwen2.5-VL,持久性误差却低得多(36.45°)。 - 前缀从 8 帧加到 24 帧,8 个模型的持久性全部变差,例如 VideoMAE 从 29.55° 升到 54.80°(→ P.8)。
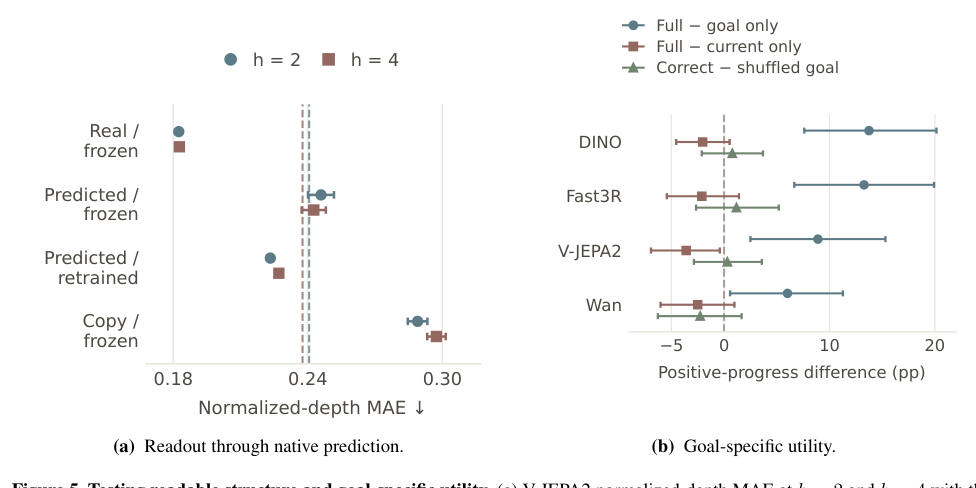
对照实验(→ P.9 表 3, P.10-11): - 对 V-JEPA2,直接复制上一帧特征(19.93%)比学到的预测(13.04%)还好。 - 历史帧让 V-JEPA2 和 Wan 的定位误差下降约 10°,但 VideoMAE 这个最准的定位者看不出受益,说明分数高不等于用了历史。 - 视频模型自己预测的未来特征,用在真实特征上训好的深度读出器上,误差从 0.182 升到 0.246,比只用训练集布局先验(0.241)还差一点。 - 动作:二选一时,有目标的打分器达 75.9–79.9%,高于只看动作的 67.8%;但直接输出连续动作时,加上目标并没有比只看当前状态更好,换目标会让动作方向转 29.8–45.6°,前进比例却没有可靠变化。
站得住的结论:任务之间排名差异大,单一指标代表不了空间能力。较弱的部分:只有一个室内静态数据集,L4 只测了 4 个模型,相关性基于 10 个或更少的样本。论文没有报告计算开销。
要点 Take-home
- 没有一个模型全面领先:Fast3R 记物体最准,DINOv2 预测未来特征最好。
- 能否记住视野外物体,主要看相机位姿读得准不准(ρ=0.76)。
- 前缀从 8 帧加到 24 帧,八个模型的物体记忆全部变差。
- 换目标会改变预测动作,但给对目标并不能稳定带来更多前进。
Claude 读完全文后的提炼。
更多:先读哪 · 值得看的理由 · 质疑
先读哪
先看第 2 页图 1 和第 6 页表 2,再看第 10 页图 5(预测与目标的对照)
值得看的理由
- 把空间表示拆成结构、持久性、预测更新、可行动四级,并用换动作、删历史、换目标的对照区分“能解码”与“真被用到” → P.3 第 1, Fig. 2; Sec. 4.3 节
- 给出选骨干的可检验线索:视野外物体定位误差与相机位姿读出最相关(ρ=0.76),与深度、实例、视角一致性的相关不超过 0.43 → P.7 第 4.1 节
质疑
- Fast3R 的训练数据包含部分验证场景,而它恰好在位姿、持久性和动作三项都领先;“位姿→持久性→动作”这条链在 L4 也只靠 4 个模型的排序支撑 → P.5 第 3.1; Sec. 4.6 (P.11) 节
审稿人笔记
这是诊断类论文,不提出新方法,结论都来自单一室内静态数据集上的离线探针。