Type 1 · Directly applicable 证据 B 收录
MoLRSI: A Recursive Self-Improving AI agent for Molecular Discovery
发布 · 收录于 2026-11-05
把过去项目里的工作流、改动结果和报错修复存成持久记忆,让 AI agent 在新的分子发现任务上搜得更快更准,并用真实湿实验验证。
- 任务
- 抗生素虚拟筛选 + pMHC 微型结合蛋白设计
- 方法
- 经验引导的 MCTS 工作流搜索 + 三类持久记忆
- 资源库
- 小分子侧 110 个可执行 skill,蛋白侧 65 个
- 湿实验
- 107 个化合物测出 17 个抗菌命中;8 个特异 pMHC 结合体
- 底座与代码
- Claude Sonnet 5;有项目主页,正文未声明开源
证据等级 B · 仿真充分 (A 真机 + 多基准 + 消融 / B 仿真充分 / C 单一基准或无代码)
动机
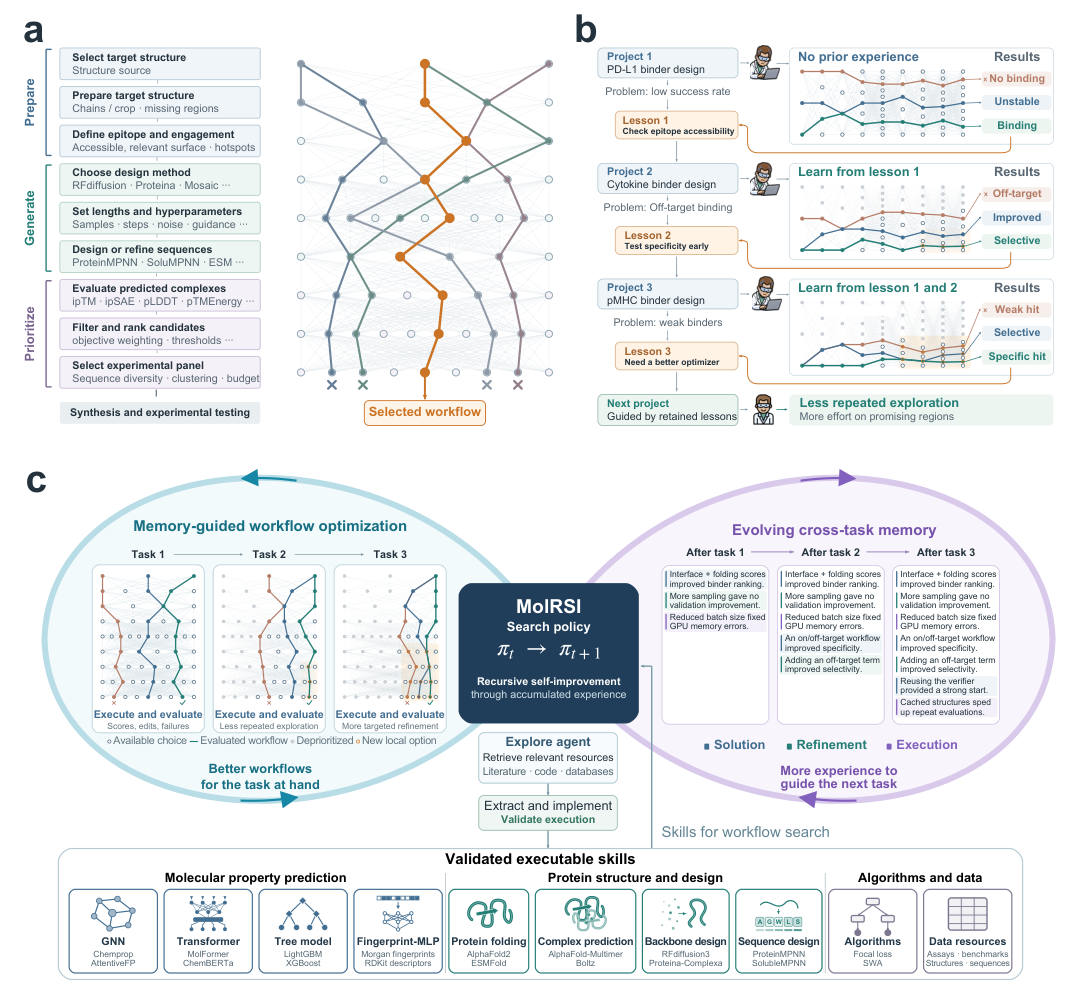
做新药或设计蛋白,难的往往不是某一个模型,而是整条工作流怎么搭:用什么分子表示、哪种模型、怎么训练、用什么指标筛、最后挑哪些去做实验。这些选择互相牵连,组合起来是一个巨大的空间(→ P.4 图 1a)。
人类研究员靠经验缩小这个空间:上个项目踩过的坑,下个项目就不再踩。而现有的科研 agent(如 Biomni、Claude Science)虽然能自动搭流程,但每个项目都是孤立的——这次搜出来的教训,下次用不上(→ P.2)。作者要补的就是这块:让 agent 把跨任务的经验攒下来,并且证明这些经验确实改变了它的搜索行为。
方法
- 1找资料把论文和代码转成能跑的 skill 库
- 2挑方案按历史成绩加探索奖励选一类工作流
- 3改方案翻出过去改动的成败,提新改动
- 4跑评测执行打分,报错就查修复记忆
- 5存经验分数、改动、报错写回三类记忆
- 6换任务新任务带着旧经验开始搜索
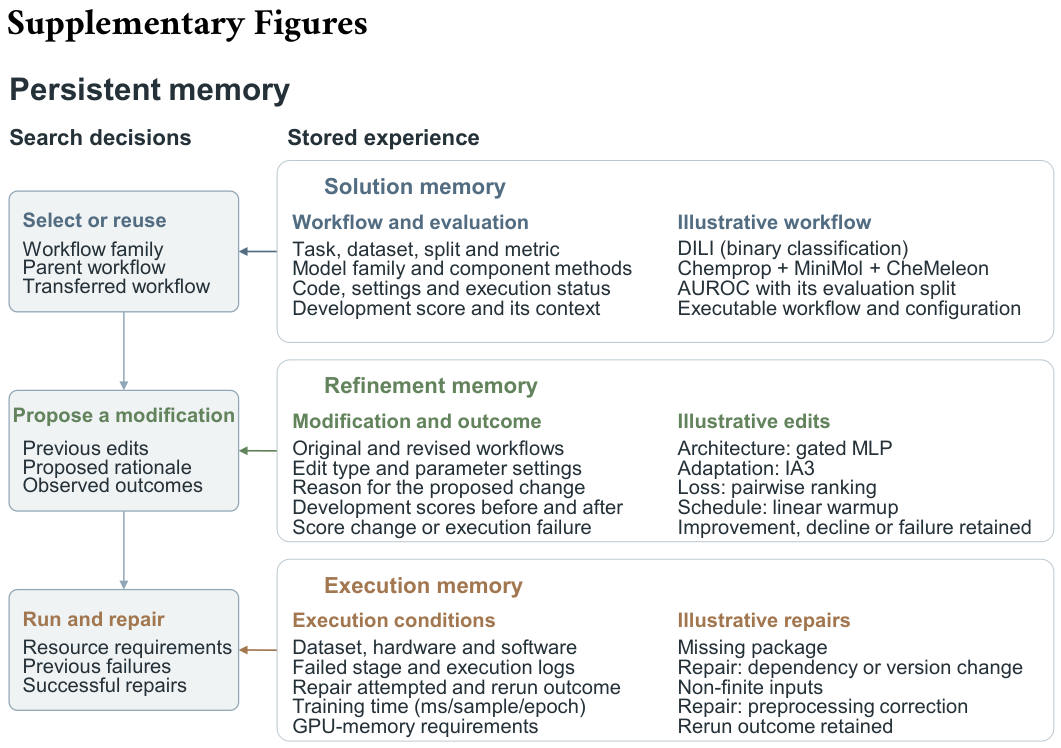
可以把 MolRSI 想成一个带实验笔记本的老研究员。笔记本分三栏(→ P.30 图 S1):
- 方案记忆(solution):每条工作流的代码、配置、在哪个任务哪个评测标准下拿了多少分。换新任务时,先翻笔记找“和这次最像的任务上,哪条流程最好”。
- 改动记忆(refinement):每次改了什么、为什么改、改完分数涨了还是跌了。涨跌都记,所以下次不会重复踩同一个坑。
- 执行记忆(execution):跑一次要多少 GPU、哪一步报过什么错、哪个修法管用。遇到同类报错直接照旧方子修。
搜索本身是蒙特卡洛树搜索(MCTS,一种“先按历史成绩选方向、再给冷门方向留点机会”的搜索)。每一轮分五步:先选工作流家族(打分 = 本任务当前成绩 + 探索奖励 + 历史迁移分)、再在已评估的流程里抽一个当父节点、然后参考改动记忆提出修改、执行评估、最后把结果写回三类记忆(→ P.14)。
论文把“自改进”写成一个式子:策略 π 是以记忆 M 为条件的,记忆更新一次,策略就变一次(式 1,P.14)。也就是说,这里没有改模型参数,改的是 agent 手里的“经验库”。此外还有一个零搜索迁移(zero-search transfer)模式:新任务上干脆不搜索,直接把最相似旧任务的最佳流程拿来,只用新数据重新拟合模型参数。
实验
本文方法 对比方法 · 数据来源:Figure 2a, P.5
本文方法 对比方法 · 数据来源:Figure 3e, P.8
本文方法 对比方法 · 数据来源:Figure 4c, P.9
两个领域,两套验证。
抗生素侧:六个细菌的活性预测任务,指标是测试集 AUPRC(越高越好,五个相似度划分取均值)。经验来自另外 25 个任务(22 个 TDC 药代毒理任务 + 3 个细胞毒性任务),六个细菌任务被排除在经验池外。即使不带跨任务经验,MolRSI 的平均 AUPRC 已是第一(0.361,→ P.5 图 2a);带上经验后,六个任务全部进一步提高,其中三个任务上“零搜索直接迁移”甚至超过从零搜索(→ P.6 图 2e)。经验池从 2 个任务加到 25 个,迁移效果从约 0.32 升到约 0.37(→ P.6 图 2f)。
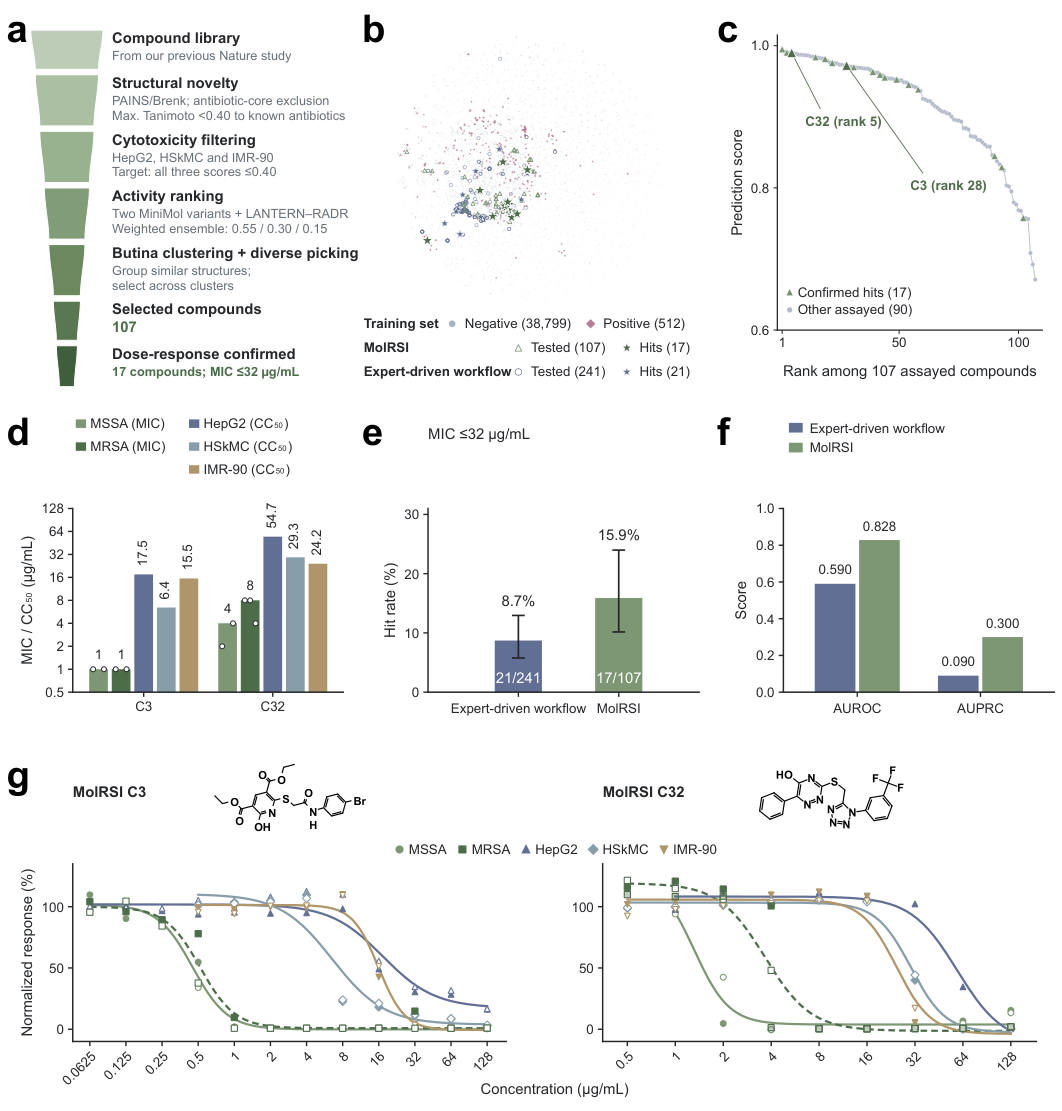
随后用它搭出的筛选流程扫 1210 万化合物,挑 107 个去做实验:17 个对金黄色葡萄球菌 MIC ≤ 32 µg/mL(MIC 越低越好),命中率 15.9%,旧的专家流程是 8.7%;在同一批 271 个化合物的公共测试集上 AUROC 0.828 对 0.590(→ P.7、P.8 图 3f)。其中 C3 对耐药菌 MRSA 的 MIC 为 1 µg/mL,且在不引起人细胞毒性的浓度下起效。
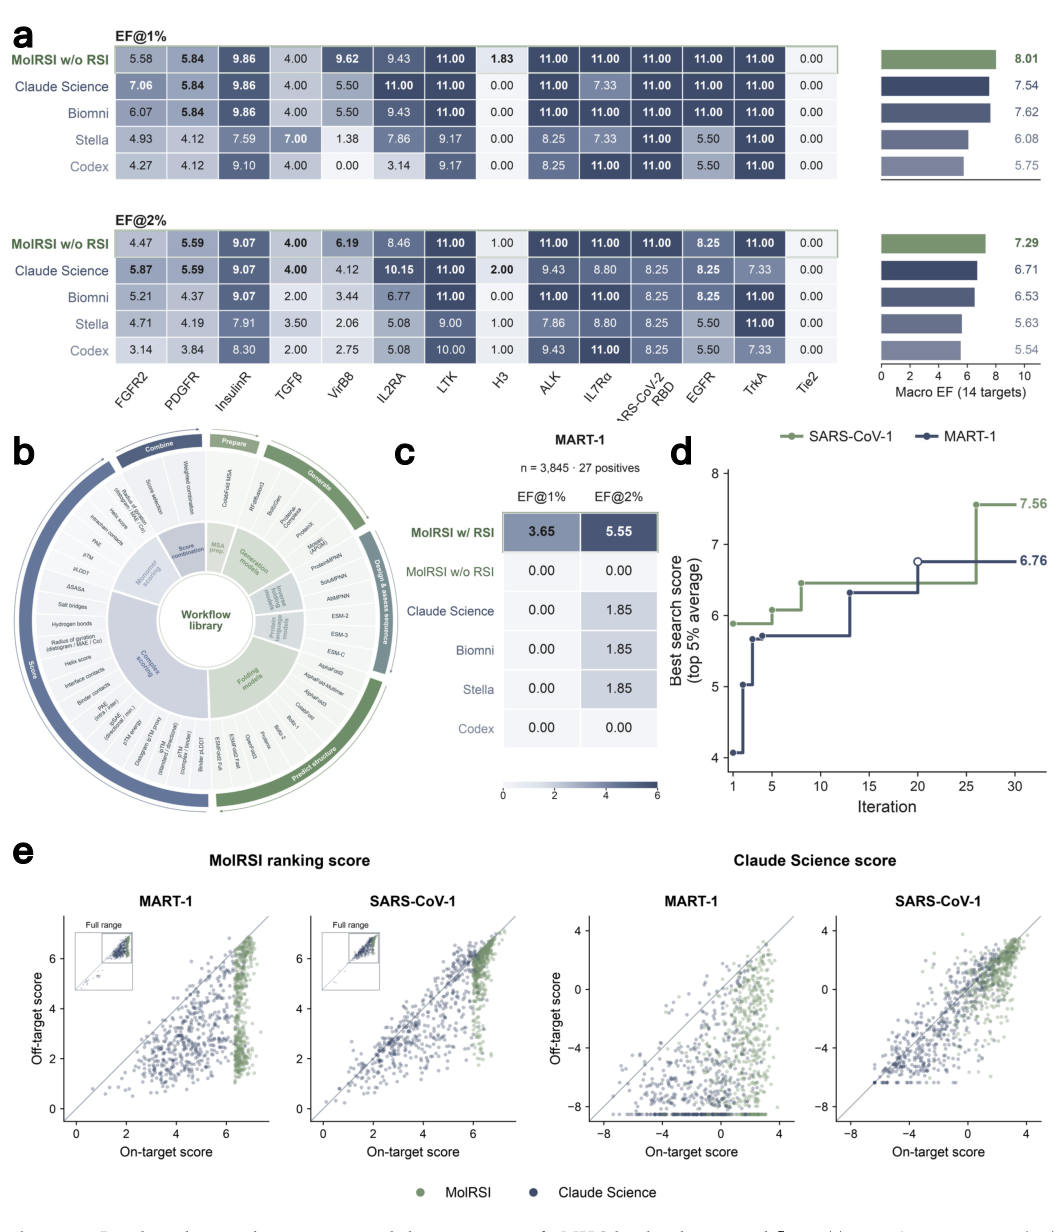
蛋白侧:14 个微型结合蛋白靶点上用富集因子 EF(越高越好,随机排序期望为 1)评排序能力,MolRSI 宏平均 EF@1% 为 8.01,次优 7.62(→ P.9 图 4a)。换到没见过的 MART-1 pMHC 靶点,带经验的版本 EF@1%/2% 为 3.65/5.55,而去掉跨任务经验的同一系统是 0.00,四个对照 agent 在前 1% 里一个真实结合体都没捞到(→ P.9 图 4c)。最后做噬菌体展示实验:MART-1 上 251 个可评估设计中有 5 个命中,SARS-CoV-1 上 266 个中有 3 个,且都对非目标肽有选择性;Claude Science 的设计在 288 和 267 个里一个都没有(→ P.11 图 5a)。
代价:蛋白侧每个任务给 300 A100 GPU 小时、20 次工作流评估;生成流程优化每个靶点 30 轮、1000 A100 GPU 小时(→ P.19)。这不是便宜的循环。
要点 Take-home
- 跨任务经验让 agent 在同样预算下搜到更好的工作流。
- 抗生素湿实验命中率 15.9%,同数据下专家流程是 8.7%。
- 新靶点上去掉旧经验,富集因子直接掉到零。
- 经验池从 2 个任务涨到 25 个,迁移效果一直在变好。
Claude 读完全文后的提炼。
更多:先读哪 · 值得看的理由 · 质疑
先读哪
先看第 4 页图 1c,再看第 9 页图 4c 和第 8 页图 3e
值得看的理由
- 用同一套资源库、同一个底座模型和同样的搜索预算,对照“有跨任务经验 / 没有 / 不搜索只迁移”,把经验的收益和搜索的收益分开计量 → P.6 图 2e → P.6 第 2.2, Figure 2e 节
- 有真实湿实验兜底:同样的训练数据和 1210 万化合物筛选库下,命中率 15.9%(17/107) 对比旧的专家流程 8.7%(21/241) → P.7 → P.7 第 2.2 节
质疑
- 命中率 15.9% 与 8.7% 的 95% 置信区间在图里明显重叠,论文没做显著性检验,两组测试的化合物数量也不同(107 对 241) → P.8 图 3e → P.8 图 3e
- “递归”只体现在记忆改变搜索策略:式 (1) 中更新记忆的规则本身是固定的,系统并没有改进“如何改进”的机制 → P.14 → P.14 第 4.1.3, Eq. (1) 节
审稿人笔记
不是机器人论文,但它是目前少见的把“记忆驱动的自改进”一路做到真实实验验证、并且把经验收益单独计量的例子。