Type 2 · Promising method Key group 证据 B 收录
ScheduleGen: Demonstration Generation via Skill Scheduling for Multi-Arm Imitation Learning
发布 · 收录于 2026-11-02
把多臂示教生成拆成“单臂规划 + 全局排时刻”两步,用 MILP 保证不相撞、守顺序,从少量示教生成的多臂数据比 DexMimicGen 更安全、训练出的策略更好。
- 任务
- 多臂(双臂、四臂、人形)操作示教的自动生成
- 数据
- Isaac Lab、RoboDojo、robosuite 共 28 个仿真变体
- 硬件
- YAM 双臂真机;仿真另含 DROID 四臂、GR1T2 人形
- 代码
- 文中未提代码发布,有项目主页
- 主要数字
- 仿真平均生成成功率 79.6%,真机 8 个变体 50-80%
证据等级 B · 仿真充分 (A 真机 + 多基准 + 消融 / B 仿真充分 / C 单一基准或无代码)
动机
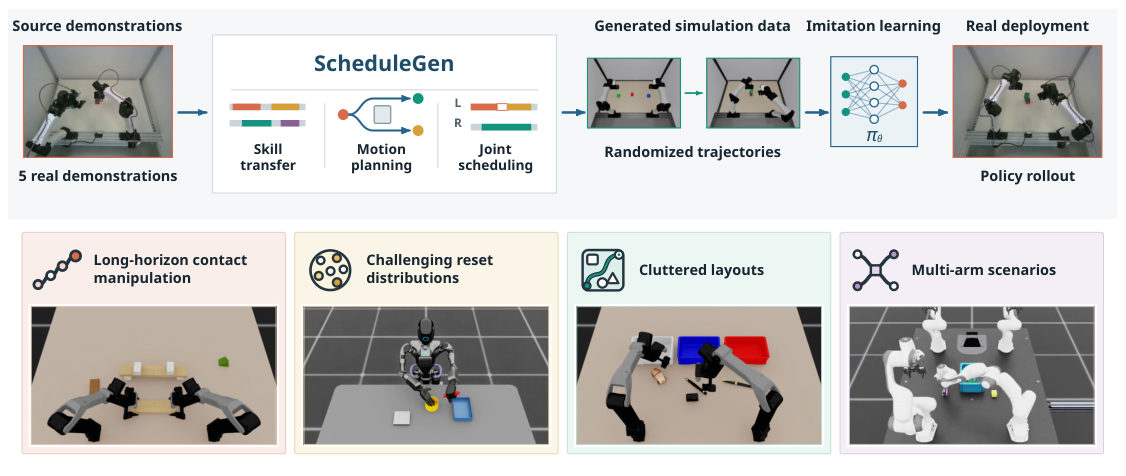
训练通用机器人策略要大量示教,多臂机器人的遥操作(teleoperation,人远程操控机器人录数据)更难更贵。
示教生成(demonstration generation)是从几条人类示教自动“变”出很多新示教。已有方法 DexMimicGen 把每只手臂的示教片段各自平移到新物体位置,但不做运动规划,也不考虑两臂会不会撞在一起。结果是:当两臂工作区交叉、场景杂乱或物体分布很广时,生成的数据要么撞,要么失败(→ P.2–3)。
难点在于:多臂既要并行以节省时间,又必须守住先后顺序(例如先倒水再拿碗)和同步动作(两臂一起抬),还要彼此避让。
方法
- 1切技能把示教切成每只手臂的技能段
- 2贴物体按新物体位姿平移技能轨迹
- 3补连线运动规划连起相邻技能
- 4排时刻MILP 决定每臂何时动、何时等
- 5仿真筛并行仿真回放,只留成功的
- 6训策略用千条数据训练模仿策略
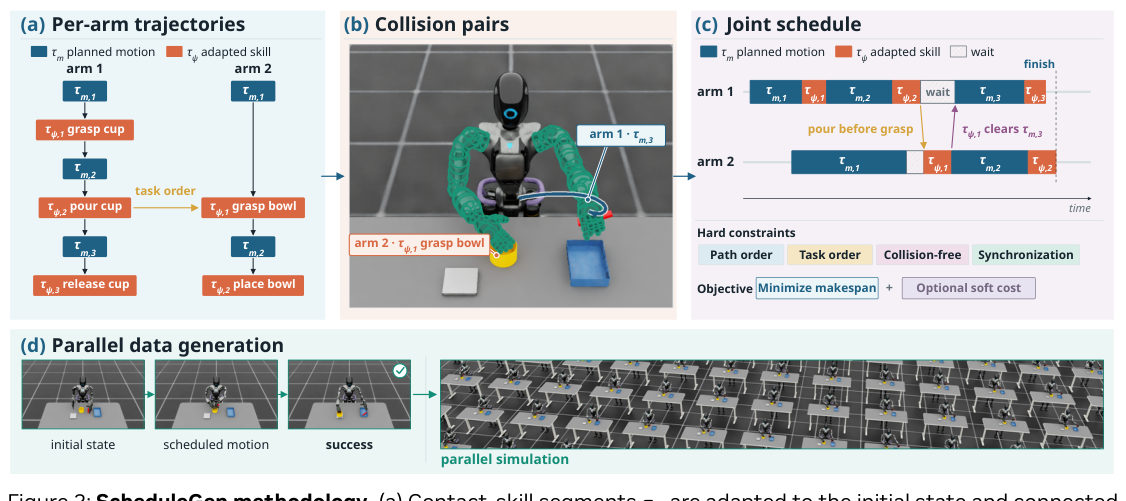
比喻:像铁路调度。每列火车(每只手臂)的轨道先单独铺好,调度员不改轨道,只决定每列车几点出发、在哪等,保证不在同一道岔同时出现,又让全部列车最早到站。
1. 技能适配与单臂规划(→ P.4、P.6):每个技能是“相对某个物体”的末端轨迹。物体换了位置,就把轨迹跟着物体平移(沿用 MimicGen 的做法),再用逆运动学(IK,由末端位置反求关节角)变成关节轨迹。相邻技能之间用运动规划补上无碰撞的连接段。这一步先不管其他手臂。
2. 时间约束(→ P.5):用“技能 A 的第 i 步不晚于技能 B 的第 j 步”这一种不等式,就能表达先后、并行和同步三种关系。
3. MILP 排程(→ P.6–7):给每只手臂每个路径点一个时刻变量。目标是让最后一只手臂完成的时间(makespan,总完成时长)最短。约束包括:相邻路径点之间至少隔一个控制周期;守住时间约束;如果两臂的某两个姿态会相撞,就必须一只先离开、另一只再进入。“谁先过”是离散选择,所以是混合整数规划。碰撞对用 cuRobo 的 GPU 球体碰撞检测批量算(→ P.7)。
实验
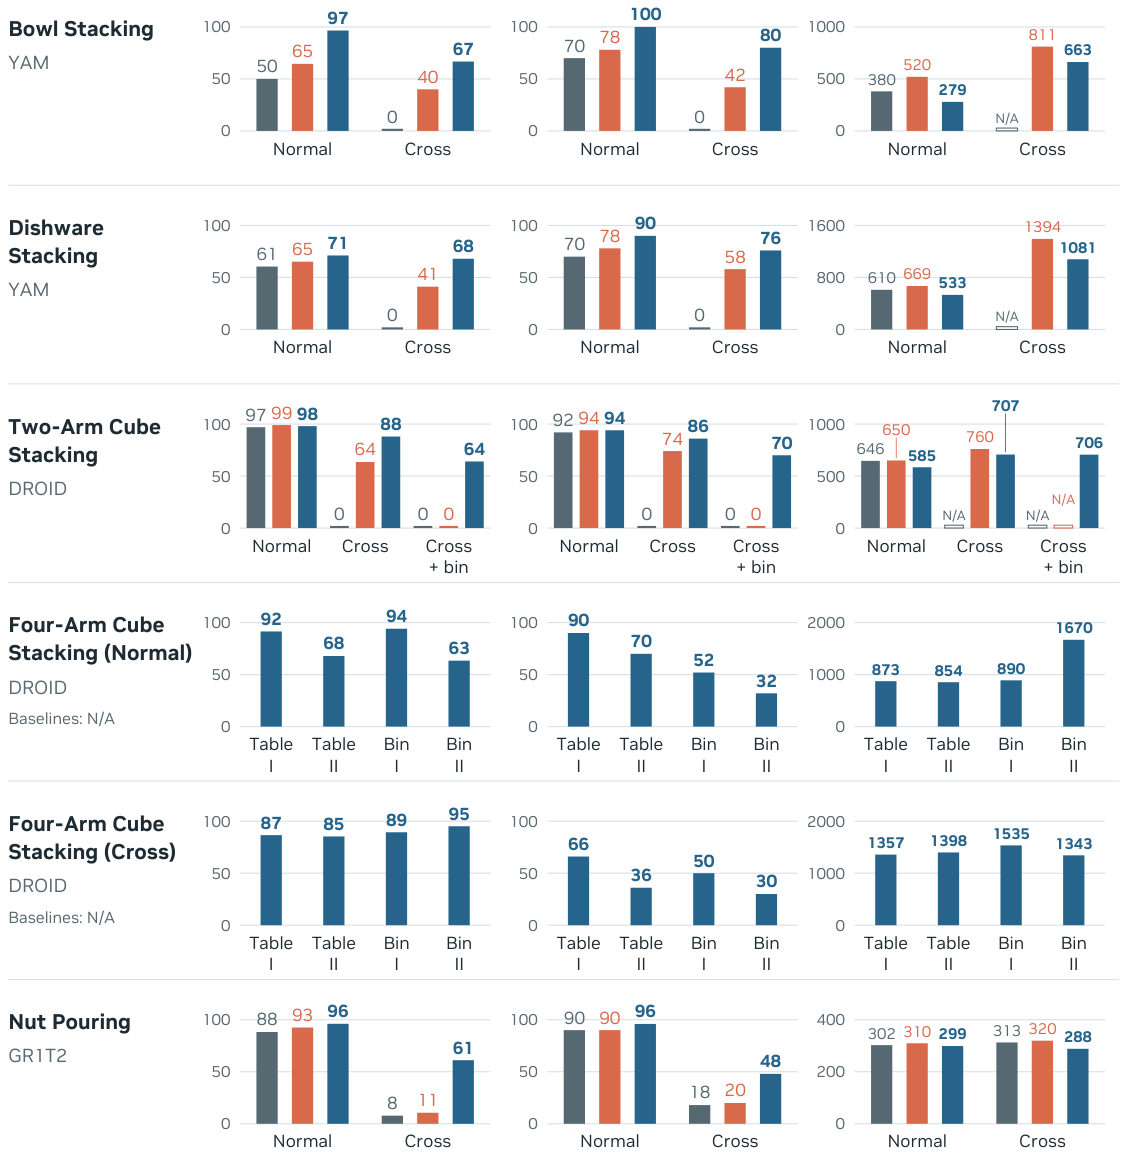
本文方法 对比方法 · 数据来源:Table 3, P.13
本文方法 对比方法 · 数据来源:Table 1, P.11
本文方法 对比方法 · 数据来源:Table 2, P.11
指标:数据生成成功率(DGR,越高越好)、策略成功率(SR,越高越好)、成功回合的平均步数(越低越好)。
仿真(→ P.8–12):17 个 Isaac Lab 变体的生成成功率 61.1-98.0%;在 DexMimicGen 能跑的 9 个变体上,本文训练的策略 8 个更好、1 个持平(双臂方块常规布局都是 94%)。两臂工作区交叉时,DexMimicGen 生成不出有效数据,本文达到 64-88%。四臂任务 DexMimicGen 不支持,本文生成率 63.4-95.1%、策略 30-90%。robosuite 上结果有好有坏:CubeClose D0 生成率略低于 DexMimicGen(84.0 vs 87.6),Threading 策略持平(60 vs 60)(→ P.11 表 1)。
RoboDojo 外部任务(→ P.11–12):7 个他人编写的任务,生成率 75.5-100%,策略在常规/加倍扰动下平均 47.9%/25.0%(每种 20 次)。只调度、不改路径时,执行步数平均缩短 16.44%(→ P.21 表 4),但这部分没有做物理回放验证。
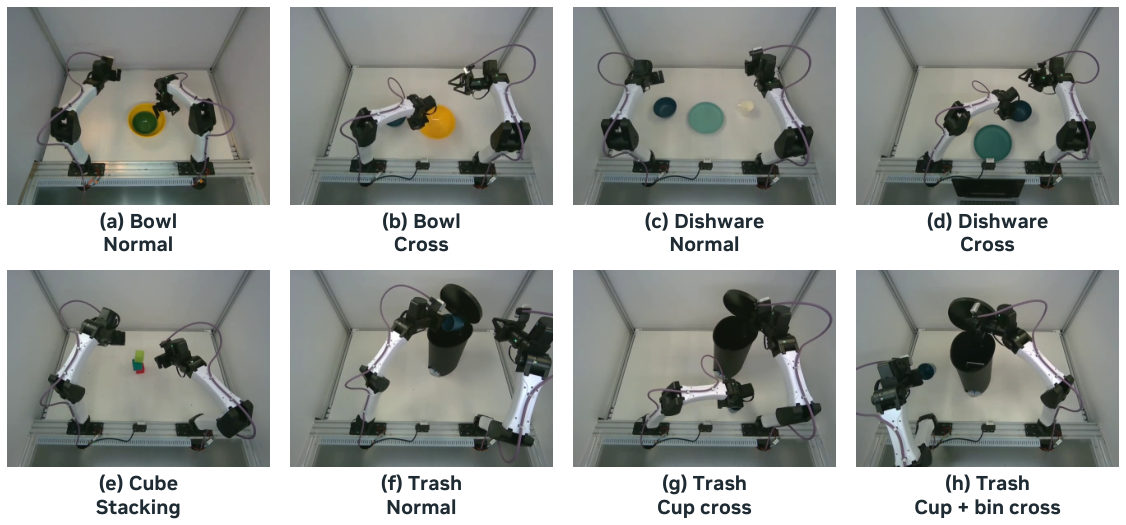
真机(→ P.13):YAM 双臂,sim-to-real 4 个变体 75-80%,real-to-sim-to-real 4 个变体 50-75%,每个 20 次。
代价:论文没有报告 MILP 求解时间或数据生成耗时。
审稿人视角
这一部分是 Claude 读完全文后的看法和判断,不是论文自己的说法。
先读哪
先看第 3 页图 2(方法),再看第 9 页图 3 和第 13 页表 3
值得看的理由
- 把多臂协调写成带“二选一碰撞约束”的混合整数线性规划(MILP),每对会相撞的路径点由一个 0/1 变量决定谁先过,形式清楚,可复用到其他多臂数据生成。 → P.7 第 4.2, Eq. 1;Appendix A.2 Eq. 2(P.17) 节
- 手臂工作区交叉的布局里,不做规划的 DexMimicGen 生成成功率为 0,本文为 64-88%;即便给 DexMimicGen 重新采集交叉布局示教,碗/餐具任务也只有 32.1%/11.2%,本文复用常规示教达到 66.7%/68.0%。 → P.9 图 3;Sec. 5.3(P.11)与 Fig. 7(P.19)
- 只用仿真生成数据训练的策略不经真机微调,在 YAM 双臂真机 8 个变体上取得 50-80% 成功率(每个 20 次)。 → P.13 表 3
审稿人式质疑
- 没有多次训练的方差,策略只用一个随机种子(42)。调度代价消融里策略成功率在 40.0-50.0% 之间、每种只测 60 次,这种差距在单种子下分不出好坏,文中却未讨论显著性。 → P.11 表 2;种子见 Table 5(P.22)
- MILP 需要 O(|R|²n²) 次碰撞检查,但全文没有报告 MILP 求解时间、每条示教的生成耗时或 GPU 开销;真机实验也只有本文方法,没有基线对照。 → P.7 第 4.3;真机见 Table 3(P.13) 节
审稿人笔记
- 文中汇总数字能对上:28 个变体 = 17 个 Isaac Lab + 7 个 RoboDojo + 4 个 robosuite(→ P.8、P.11);RoboDojo 策略平均 47.9%/25.0% 与图 5(b) 七个任务的数值平均一致(→ P.12)。
- 不同任务用的策略类型不同:YAM 任务是视觉 flow-matching 策略,双臂方块用状态输入的 BC-RNN,四臂方块用状态输入的 flow-matching(→ P.8、P.22)。跨任务比较策略成功率要谨慎。
- 真机交叉布局的碗任务成功率(80%)高于常规布局(75%),而仿真策略正好相反(80% vs 100%,→ P.9 图 3、P.13 表 3);每项只有 20 次,差异可能是样本噪声。
- RoboDojo 的 7 个任务和真机实验都没有 DexMimicGen 对照(→ P.12 图 5、P.13 表 3),与基线的比较只在 Isaac Lab 和 robosuite 上。
- “只调度不重规划”的 98.3% 可行率和 16.44% 步数缩短只检查了 Eq. 1 的约束,没有做物理回放(→ P.21 C.5)。