Type 1 · Project-related Key group 证据 B 收录
EgoContact: Evaluating Physical Intelligence with Egocentric Video
发布 · 收录于 2026-11-02
人类第一视角视频里“手最终碰在哪”可以作为考题,检验模型是否真的知道为了某个动作该接触物体的哪个位置;现有模型普遍答不好,而这些标注本身能直接帮机器人抓得更好。
- 任务
- 未来接触点预测:接触前一帧 + 动作意图 → 接触像素点
- 数据
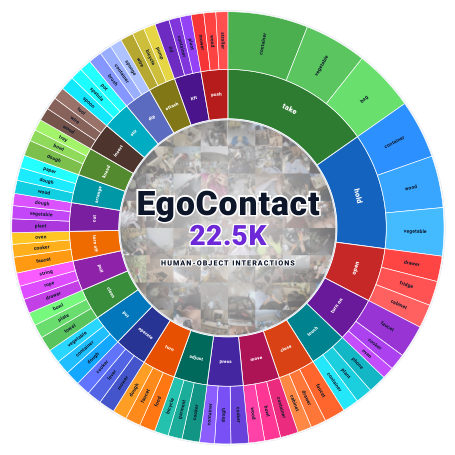
- Ego4D 片段,22,523 条人工核验事件,381 类物体 / 85 类动作
- 硬件
- Franka Panda + RGB-D;仿真为 Isaac Sim(346 个 GSO/YCB 物体)
- 开源
- 有项目主页 egocontact.github.io
- 主结果
- 真机抓取 8/50 → 29/50;仿真 14.2% → 31.2%
证据等级 B · 仿真充分 (A 真机 + 多基准 + 消融 / B 仿真充分 / C 单一基准或无代码)
动机
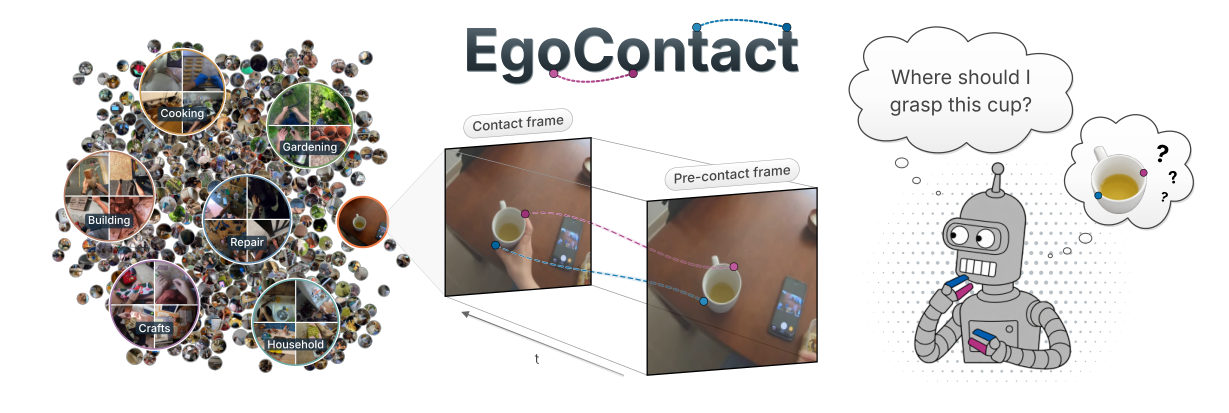
第一视角视频(egocentric video,戴在头上的相机拍下的日常操作)已被大量用来预训练机器人策略,但很少被用来考核模型。
要考的是“物理智能”中的一小块:为了完成某个动作(比如“拿起杯子”),应该接触物体的哪个位置。现有考法各有短板:
- 真机测试贵、难复现,还把感知、规划、控制混在一起;
- 仿真可重复,但物体和场景种类有限;
- 已有 affordance(可供性,即物体“能被怎样使用”)数据集要么是静态图片,要么只有粗糙热力图或边界框,要么规模很小(P.3 表 1)。
作者的想法:人在视频里真的碰到了哪里,就是这个物体“支持这个动作”的证据。把这个接触点标回到“还没碰之前”的画面上,就得到一道有标准答案的题。
方法
- 1选片段Ego4D 中 37 类操作场景
- 2找接触VISOR-HOS 检出候选,人工核验
- 3标两点接触帧标拇指与对侧手指
- 4回投影把点标到接触前 0.5–2.5 秒画面
- 5出考题动作描述 + 前帧,让模型给点
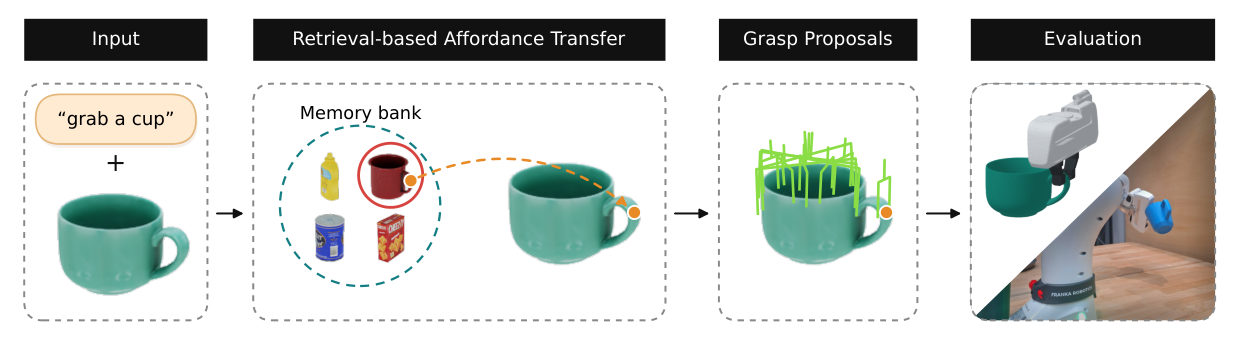
- 6用起来作记忆库引导机器人选抓取
比喻:像看回放判越位——先看清球员最后碰球的位置,再回到他碰球前的画面,问“你能提前猜到他会碰哪儿吗?”
关键模块一:时间锚点。 每个事件以“首次接触帧”为准;往前退至少 0.5 秒取观察窗口的最后一帧,再最多往前 2.5 秒取第一帧,保证物体可见、手还没把接触面挡住(P.3 Sec. III-B)。
关键模块二:两点接触。 不标整只手,只标两个点:拇指接触点和一个“对侧虚拟手指”(virtual finger,把几根手指看成一个与拇指对夹的整体)。这样的表示不依赖人手形态,可迁移到平行夹爪(P.3)。点被转到接触前帧上,并标注是否在物体背面不可见。
关键模块三:语义意图。 用 Qwen3-VL 把自然语言描述归一成“动词-名词”对,并对齐 Ego4D 的类别表,于是同一物体在不同动作下有不同的正确接触点(P.3)。
评估指标(P.4 Sec. IV-A3):PiB(预测点是否落在目标框内,越高越好,反映粗定位);mDST(预测点到真值的距离除以图像对角线,越低越好);PCK@1%/5%(误差在对角线 1% 或 5% 以内的比例,越高越好)。比较时只用“对侧手指”这一个真值点。
实验
数据来源:Table II, P.4
数据来源:Table II, P.4
本文方法 对比方法 · 数据来源:Fig. 5, P.5
问题一:现有模型能精确预测接触点吗?(P.4 表 2)
被测方法分三类:affordance grounding(GLOVER++、3DOI)、affordance transfer(RAM、Robo-ABC)、VLM(RoboPoint、MolmoPoint、Qwen 3.8 27B、Gemma 4 31B、Muse Spark 1.3)。注意 3DOI 额外拿到了目标框中心作提示,属于“开卷”。
- 最好的 Muse Spark 1.3:Top-5 PiB 79.91%、Top-5 PCK@5% 71.82%,但 Top-5 PCK@1% 只有 11.05%。
- 所有方法都没超过“直接输出目标框中心”这个基线(Top-1 PCK@5% 73.78%)。作者据此认为,宽松阈值下的分数主要来自找到物体,而不是理解接触。
- 通用开源 VLM(Qwen、Gemma)的 Top-1 PiB 只有约 14%,经常连目标物体都没指中。
问题二:这对机器人抓取有用吗?(P.5)
做法:保持 RAM(基于检索的 affordance 迁移策略)不变,只把它的记忆库换成 EgoContact。预测的接触点用来在抓取候选(仿真用 GraspGenX,真机用 AnyGrasp)中挑中点最近的一个。
- 仿真(Isaac Sim,346 个物体,每个物体抓 1 次,成功率越高越好):总体 14.2% → 31.2%,GSO 14.0% → 31.6%,YCB 17.6% → 23.5%。
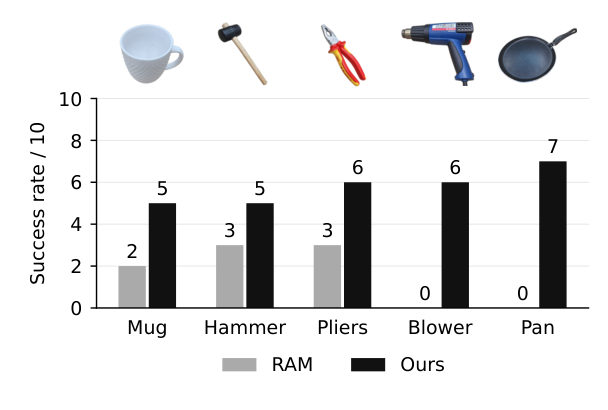
- 真机(Franka,5 个物体各 10 次):8/50 → 29/50,五个物体都有提升。
站得住的结论:现有模型在精确接触上普遍很弱,这一点在 22.5K 样本上很清楚。需谨慎的结论:抓取提升来自“整个记忆库”,规模和覆盖面的作用没有被分离。论文未报告运行时间或推理开销。
审稿人视角
这一部分是 Claude 读完全文后的看法和判断,不是论文自己的说法。
先读哪
先看第 4 页表 2(各方法离精确接触有多远),再看第 5 页图 3–5(换记忆库后的抓取结果)
值得看的理由
- 任务定义清楚:给接触前一帧和一句动作意图,预测人随后真实接触的像素点;标注是人工核验的两点接触(拇指+对侧虚拟手指),共 22,523 条、381 类物体、85 类动作,比 AGD20K、3DOI 等更精确、规模更大。 → P.3 第 III-B/C, Table I 节
- 结论有用:所有被测方法(affordance grounding、affordance transfer、点预测 VLM、通用 VLM)在 Top-1 PCK@1% 上都不到 4%,且无一超过“目标框中心”这个朴素基线(73.78% PCK@5%),说明现有模型的“接触点理解”主要来自物体定位。 → P.4 表 II, Sec. IV-A4
- 只把 RAM 的记忆库换成 EgoContact、其余不变,仿真 346 个物体抓取成功率 14.2%→31.2%,真机 5 个物体各 10 次 8/50→29/50,原记忆库在吹风机和平底锅上为 0。 → P.5 图 4, Fig. 5, Sec. IV-B3
审稿人式质疑
- 抓取提升混入了记忆库规模与覆盖面的差异:论文自己写明比较的是“整个记忆库”,未报告 RAM 原记忆库大小,也没有等规模子集或去掉精确接触标注的对照,因此“接触标注精度带来提升”这一说法尚未被单独验证。 → P.5 第 IV-B3 末段 节
- 未报告标注者间一致性(同一事件两人标注的点距离);真机每物体仅 10 次、仿真每物体只抓 1 次,均无方差或多次重复;VLM 的“minimal harness”提示词未给出。 → P.4 第 III-B, Sec. IV-A2, Sec. IV-B1/2 节
审稿人笔记
- “目标框中心”基线用的是人工标注的框,本身带有真值信息;“没有方法超过朴素基线”更准确的说法是“没有方法超过一个已知物体位置的基线”(P.4 Sec. IV-A2、表 2)。
- 每个事件标了两个接触点,但评估只用“对侧虚拟手指”一个点,拇指点未参与打分(P.4 Sec. IV-A1)。
- 表 2 中 Robo-ABC 只有 Top-1 数字,因为它只输出一个检索迁移的接触点(P.4 Sec. IV-A2)。
- YCB 子集只有 17 个物体,提升(17.6%→23.5%)约等于多抓成 1 个物体,远小于 GSO 子集(P.5 图 5 说明)。
- 正文只有 6 页、无附录:数据划分、标注流程耗时、许可协议和标注一致性均未给出(P.2–3 Sec. III)。