Type 2 · Promising method Key group 证据 C 收录
Learning Multi-Phase Robot Loco-Manipulation via Phase-Conditioned Policy Optimization
发布 · 收录于 2026-11-02
把长任务按“阶段”切开,只在训练时用阶段信息来给奖励、算价值、辅助学习和重置环境,就能用一个 PPO 策略学会多阶段的全身移动操作,部署时不再需要阶段信息。
- 任务
- 多阶段 loco-manipulation:搬箱、推箱、翻滚轮胎
- 硬件
- Unitree G1 人形;Boston Dynamics Spot + 机械臂
- 仿真
- mjlab(基于 MuJoCo Warp 的 GPU 并行仿真)
- 代码
- 论文未给出代码链接
- 主要数字
- 去掉阶段预测头:G1 推两箱成功率 92%→14%
证据等级 C · 单一基准或无代码 (A 真机 + 多基准 + 消融 / B 仿真充分 / C 单一基准或无代码)
动机
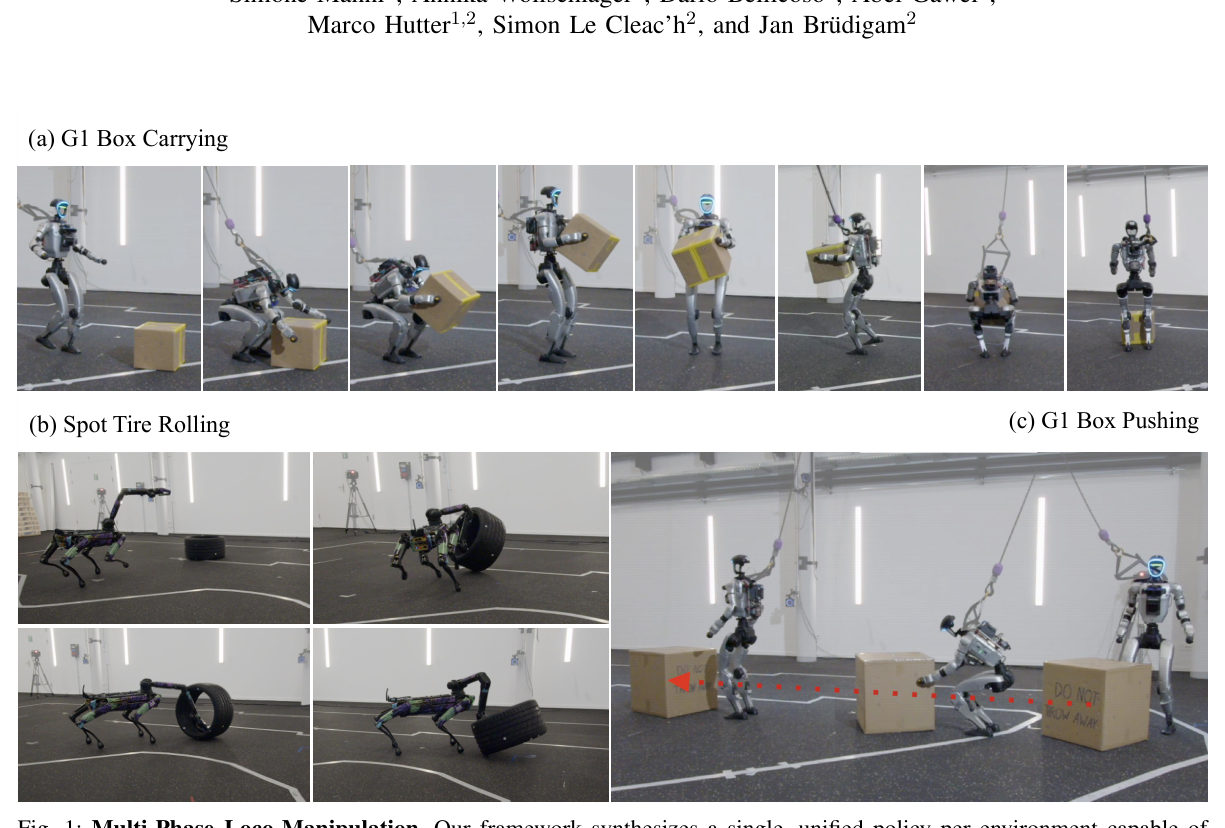
问题:像“走过去→蹲下→抱住箱子→抬起→走→放下→站起”这样的长任务,需要一个策略在几种完全不同的身体姿态间切换。
现有做法的卡点: - 用强化学习(RL,靠试错拿奖励来学)直接训,探索空间太大,常掉进“局部最优”,比如学会踢箱子、拖箱子,而不是抱起来(→ P.2)。 - 用人类动作捕捉数据做示范效果好,但数据处理成本高,而且绑定人形身体,换成四足就用不上(→ P.2)。 - 用状态机(FSM,按规则在几个子策略之间切换)串联分别训练的子策略,在动态任务里切换点不好定义,衔接容易失败(→ P.3)。
本文想法:长任务天然由几个阶段组成,把这个结构直接用进一个策略的训练里。
方法
- 1底层全身控制跟踪速度、身高、俯仰指令
- 2切分阶段状态机按局部条件划分阶段
- 3分阶段奖励按当前阶段开关奖励项
- 4猜阶段策略辅助头预测当前阶段
- 5分阶段价值基础价值头加阶段残差头
- 6多阶段重置先从中间阶段开局,再逐步回起点
比喻:像教学生做一道多步骤的菜。练习时,老师知道学生正在第几步,按这一步的要求打分,偶尔直接让学生从“锅已经热了”那一步开始练;学生还要学会自己判断“我现在在第几步”。考试时老师不在场,学生独立做完全程。
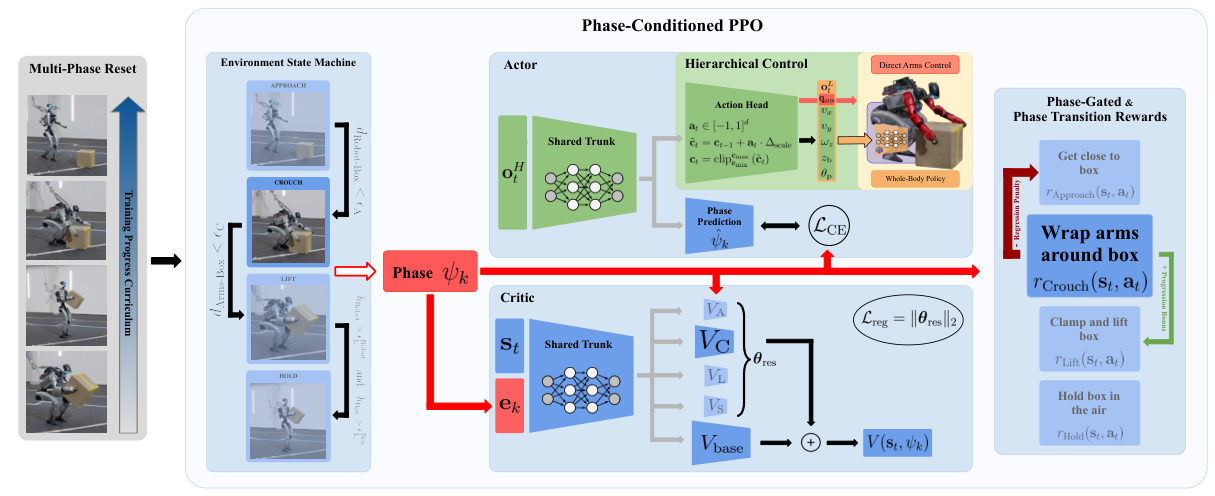
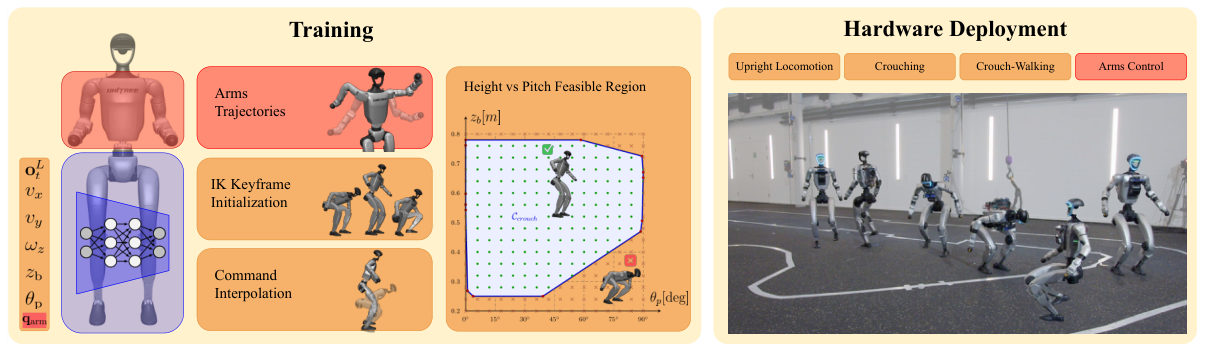
两层结构(沿用 ReLiC 框架):底层是全身控制器,只负责跟踪 5 维指令(平面速度、转向、骨盆高度、躯干俯仰),G1 上用 IK 关键帧初始化和“可行指令区域”帮它学会深蹲(→ P.4)。上层策略输出指令的增量,并直接控制双臂(→ P.4 式 2)。
上层的四个关键改动(→ P.4-5): 1. 阶段门控奖励:每个阶段只打开自己的奖励项;向前进入下一阶段给小奖励,退回上一阶段重罚,防止来回刷分。阶段边界加了迟滞(hysteresis,退回条件放宽),避免在边界抖动。 2. 辅助阶段预测头:策略本身看不到阶段编号,但多了一个分类头,用交叉熵去猜当前阶段,逼共享特征去编码“任务进行到哪了”。 3. 阶段残差价值网络:评论家(critic,估计“这个状态还能拿多少奖励”的网络)由一个全局基础头加每阶段一个残差头组成,残差头权重加 L2 惩罚,让主要工作留在基础头。 4. 多阶段重置:参考 DeepMimic,训练初期把环境直接放到后面的阶段(如箱子已在半空),课程推进后逐步回到第一阶段。
部署时阶段信息完全不用,策略自己按顺序完成全程(→ P.5)。
实验
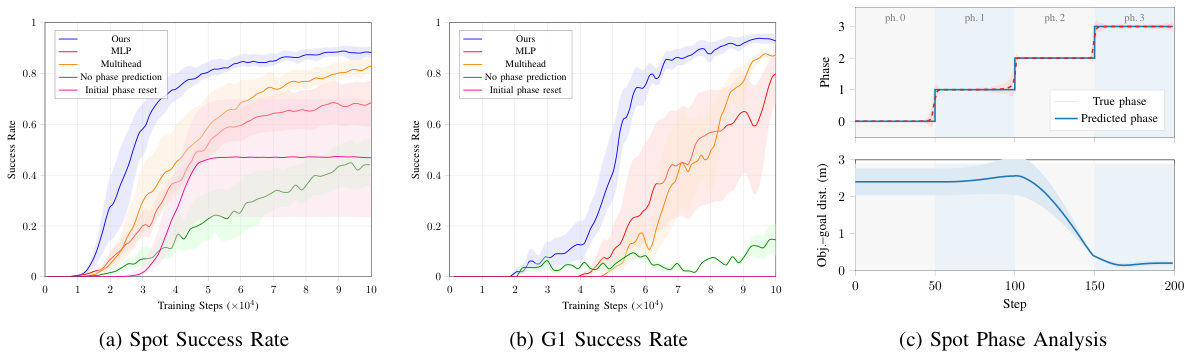
本文方法 对比方法 · 数据来源:Sec. IV-B1 正文, P.6(对应 Fig. 5a/5b)
任务:Spot 推轮胎(4 阶段),G1 推一个箱子(3 阶段)、推两个箱子(5 阶段)、抬箱(5 阶段)、搬箱(7 阶段)(→ P.5 Table II)。都在 mjlab 中训练,真机部署;主要实验用外部动捕获取机器人和物体状态,G1 推箱和抬箱还用板载状态估计 + ArUco 标记做了无动捕演示(→ P.6)。
指标:任务成功率,越高越好。消融只在仿真里做,用 3 个随机种子(→ P.7 Fig. 5)。
比较对象:只和自家变体比:普通 MLP 价值网络、完全分开的多头价值网络、去掉阶段预测、只从初始阶段重置。
结果: - 去掉阶段预测头掉得最多:Spot 89%→44%,G1 92%→14%(→ P.6)。 - 只从初始阶段重置:Spot 任务还能学会但方差大,G1 推两箱完全学不会(→ P.7)。 - 价值网络结构的差别作者自己承认“相对细微”(→ P.7)。
真机:只有照片和定性描述,没有成功率统计。sim-to-real 上加了执行器延迟随机化、摩擦课程和关节偏差限幅(→ P.6)。
代价:论文没有报告训练时长或算力。
审稿人视角
这一部分是 Claude 读完全文后的看法和判断,不是论文自己的说法。
先读哪
先看第 4 页图 3(整体框架),再看第 7 页图 5(消融曲线)
值得看的理由
- 不用人类动作数据,也不用状态机串联多个子策略,一套 PPO 改法在人形 G1 和带臂 Spot 两种平台上真机完成了多阶段搬箱、推箱、翻滚轮胎。 → P.1 图 1;任务与阶段划分见 P.5 Table II
- 消融显示辅助阶段预测头作用很大:去掉后 Spot 推轮胎成功率从 89% 降到 44%,G1 推两箱从 92% 降到 14%。 → P.6 第 IV-B1,Fig. 5a/5b 节
- 给出几条可直接照搬的 sim-to-real 细节:执行器延迟随机化(最多 25 ms)、摩擦课程、把关节指令偏差限制在 7 N·m 作为隐式力矩上限,实现最长 5 分钟稳定夹持。 → P.6 第 IV-A2 节
审稿人式质疑
- 没有任何外部基线:消融只比较自家变体(MLP、Multihead、无阶段预测、只从初始阶段重置),没有和相关工作里讨论的状态机串联子策略或 ULC 等方法比较,所以“单一策略优于串联”这一动机没有被实验直接检验。 → P.7 图 5,Sec. IV-B
- 真机部分只有定性展示,没有报告真机试验次数和成功率;仿真消融只做了 2 个任务、3 个随机种子,而且阶段划分阈值、各阶段奖励权重、迟滞参数都没有给出,也没有论文代码链接,难以复现。 → P.6 第 IV-A,Fig. 4;Fig. 5 图注 节
审稿人笔记
- 全部定量结果都是仿真消融(P.7 Fig. 5),真机只有定性展示(P.1 Fig. 1,P.6 Fig. 4),没有真机试验次数、成功率或失败案例。
- 文中写成 89% ± 2% 的形式(P.6),而 Fig. 5 图注说阴影表示 3 个种子的“mean and variance”(P.7),± 后面是方差还是标准差没有说清。
- Fig. 5b 中 Multihead 曲线在训练末期接近本文方法,与作者“价值网络结构差别相对细微”的说法一致(P.7);最关键的增益来自阶段预测头和多阶段重置,而非价值网络结构。
- 摩擦课程最终仍停在 1.5–2.0 的偏高滑动摩擦(P.6),这是为了补 MuJoCo 软接触的缺陷,可能掩盖真实抓持难度;搬箱时换箱子形状还要手工更新重置关键帧(P.7 局限)。
- 方法需要人工切分阶段、定义阶段条件和每阶段奖励(P.7 局限),这些阈值和权重在文中没有列出。