Type 1 · Project-related Key group 证据 B 收录
Learning Force-Reactive Humanoid Loco-Manipulation
发布 · 收录于 2026-11-02
让示教同时记录手的动作和接触力,并让全身控制器直接执行'用多大力',人形机器人才能稳定完成推、夹、擦这类接触任务。
- 任务
- 人形移动操作中的力控:推龙门架、双手转箱、擦白板
- 硬件
- Unitree G1 + 腕部六轴力/力矩传感器 + 腕部相机
- 数据
- 无机器人手持示教(两把测力夹爪 + 胸/脚踝追踪器)
- 代码
- 有项目页,论文未提代码发布
- 主结果
- 真机平均成功率 80%,纯位置策略 26.7%
证据等级 B · 仿真充分 (A 真机 + 多基准 + 消融 / B 仿真充分 / C 单一基准或无代码)
动机
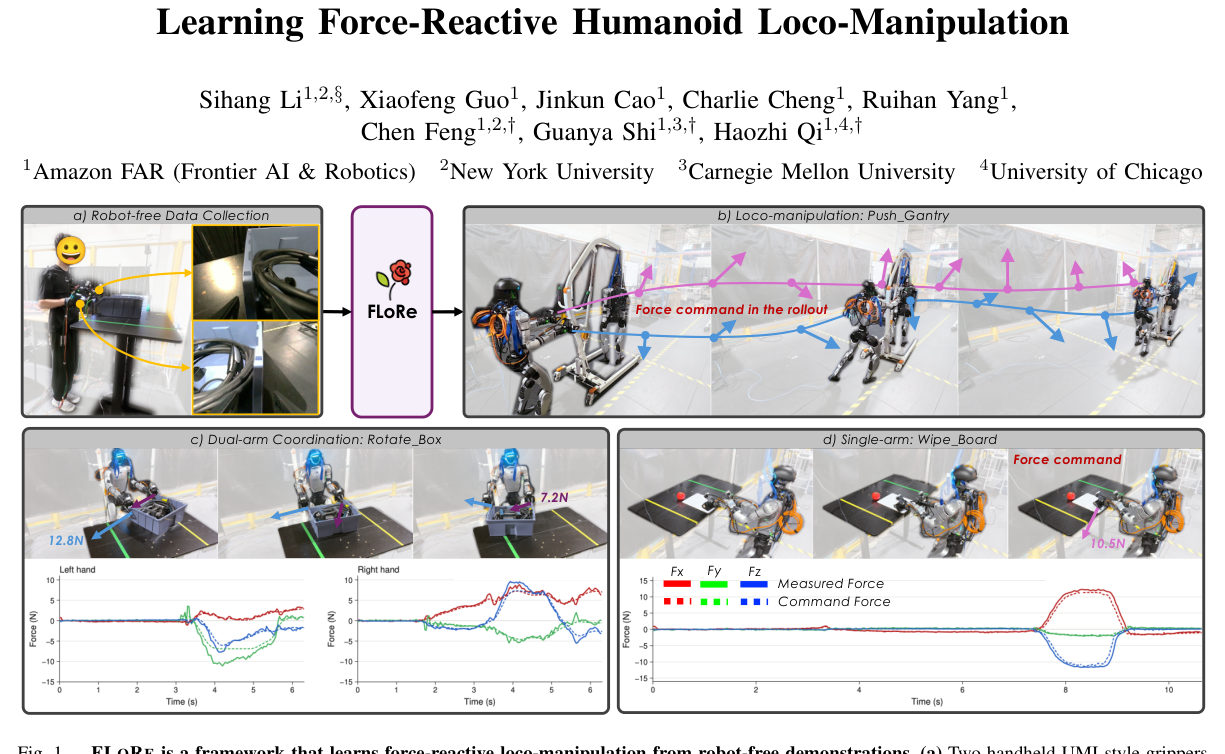
推车、搬重箱、擦桌子这类任务,光有手的轨迹不够,还要知道推多重、压多紧。
现有人形机器人做法有两个缺口(→ P.1–2):
- 数据:无机器人的全身示教系统只录动作,不录接触力。
- 执行:学到的全身控制器(whole-body controller,统一控制腿、躯干和手臂的策略)只跟踪位置,或把外力当干扰去抵抗、当刚度去降低,没法指定'按多大力压'。
难点在于人形机器人要两只手一起出力,同时还得保持平衡、边走边推。
方法
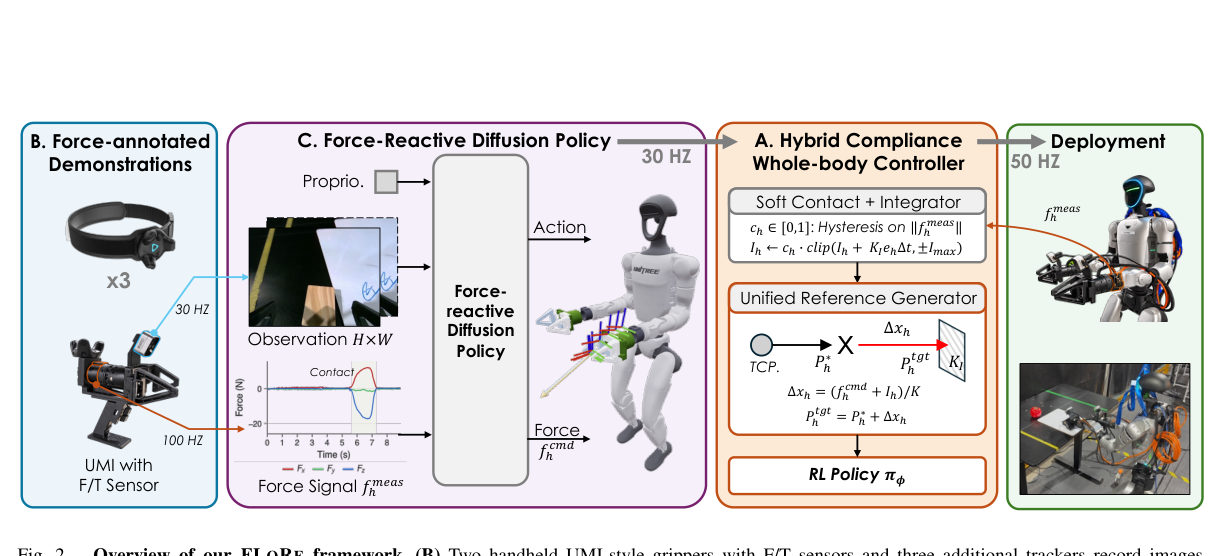
- 1手持采集两把测力夹爪录图像、动作和力
- 2学预测力扩散策略输出手部动作和每只手目标力
- 3力变位移把目标力换算成手目标点的偏移
- 4积分纠偏按实测力误差继续推进直到力对上
- 5全身执行一个RL策略管走路、平衡和双手
比喻:像用手按门铃,你不知道按钮有多硬,就一边按一边感觉,力不够就再往里一点,够了就停。
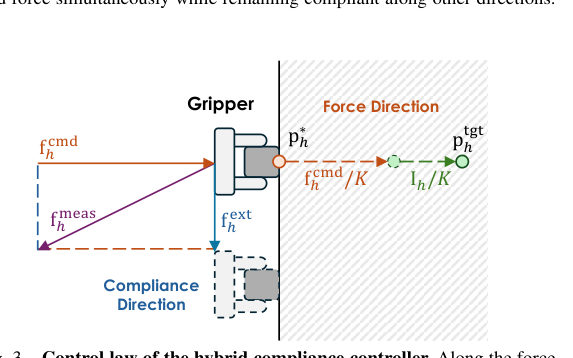
1. 力变成位置目标(混合柔顺控制,hybrid compliance)。控制器只输出关节位置,所以把力指令换成手目标点的偏移:目标点 = 动作参考 + 力指令/K + 积分项/K(K=200 N/m)。积分项累积'指令力与实测力之差',于是不管表面多硬,目标点都会一直往里推,直到腕部传感器读到的力等于指令(→ P.3 式 1、图 3)。没下指令的方向上,被人推时积分项随推力增长,手就顺着让开,不需要切换模式(→ P.4)。
2. 仿真训练。在 Isaac Lab 里让每只手去压随机放置、随机刚度的虚拟平面,模拟传感器带偏置和噪声,用强化学习训练一个策略同时跟踪全身动作和手部力(→ P.4 式 2–4)。
3. 力感知扩散策略(diffusion policy,用去噪方式生成一段动作序列的模仿学习模型)。输入双手腕部图像、低维状态和每只手的力历史,输出一段 50 步的手/躯干/脚位姿、夹爪开度和每只手的力指令;力指令直接送给上面的控制器执行(→ P.4–5)。
实验
本文方法 对比方法 · 数据来源:Table II, P.7
本文方法 对比方法 · 数据来源:Table I, P.6
本文方法 对比方法 · 数据来源:Table I, P.6
仿真(sim-to-sim,Isaac Lab 训练、MuJoCo 测试),两个动作集 ROOT-90 和 VLK-Pick-100(→ P.6 表 I):
- 动作跟踪指标(根位置误差、腕位置/姿态误差)越低越好。加了力通道后,根误差比不带力版本多 1.3–3.2 cm,腕位置误差最多多 8 mm,腕姿态误差约减半。
- 力跟踪:增益 a₁ 越接近 1 越好,本文 1.03–1.06;接触力误差越低越好,本文约 1 N,SONIC+导纳约 7.9 N。
- 真机上对着测力计验证:x 方向稳态力约达指令的 91%,误差约 1.1 N,平均 1.8 s 进入 ±1 N 范围(→ P.6)。
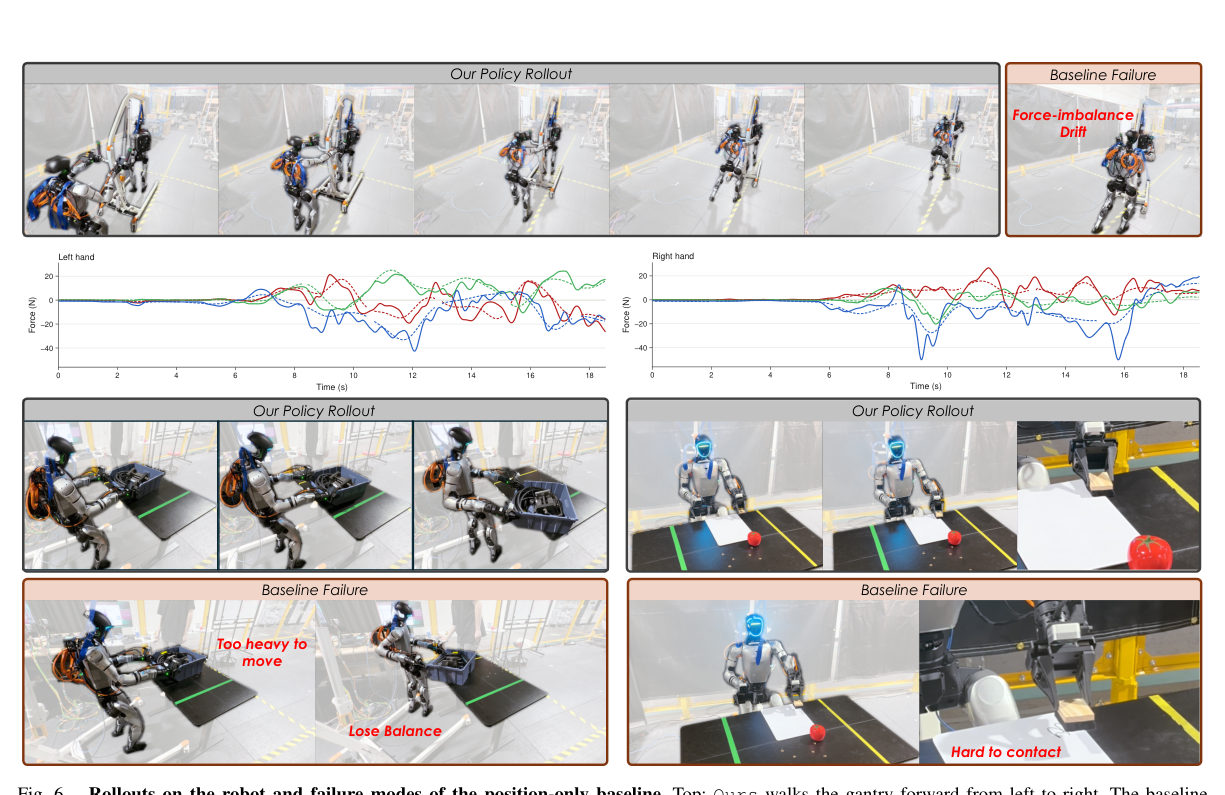
真机三任务,成功率越高越好,每任务每策略 10 次(→ P.7 表 II):本文 7/10、9/10、8/10;纯位置 DP 2/10、3/10、3/10。DP 和本文用同样的数据和控制器,只是不输入也不输出力。
站得住的结论:力指令是主要增益来源(36.7% → 80%,p=0.001);力观测的作用只是趋势(66.7% → 80%)。
代价:论文未报告训练时长或推理延迟,只给出策略 30 Hz、控制器 50 Hz(→ P.3 图 2)。
审稿人视角
这一部分是 Claude 读完全文后的看法和判断,不是论文自己的说法。
先读哪
先看第 1 页图 1 和第 3 页图 2、图 3,再看第 7 页表 II
值得看的理由
- 消融干净:同一批示教、同一个控制器,只把预测的力指令关掉,真机三任务成功率从 80%(24/30)降到 36.7%(11/30),Fisher 检验 p=0.001。 → P.7 表 II;P.8 F3
- 一个 RL 全身控制器同时管走路、平衡和双手力跟踪:仿真中力增益 1.03–1.06、接触力误差约 1 N,而 SONIC 外加导纳力控只做到 0.67–0.70 增益、约 7.9 N 误差。 → P.6 表 I
- 采集端和机器人端用同一套夹爪+六轴力/力矩传感器,示教不需要机器人,力既是策略输入也是输出指令,这套数据接口可迁移到其他接触任务。 → P.4 第 III-B, Fig. 4 节
审稿人式质疑
- 每个任务只有 10 次真机试验(2 种负载/偏移 × 5 个初始位姿,各跑一次),没有重复;去掉力观测后 20/30 对 24/30 的差距不显著,论文自己也只称其为'趋势'。 → P.7 表 II;P.8 F3
- 侧向和向下的力指令增益偏低且会漏到其他轴;切向力在训练中从未出现;正文说 Spring-Law 基线检测不到接触,但 Table I 没有它的数字;我在正文中没有找到每个任务的示教数量。 → P.6 第 IV-B、Table I;P.4 Sec. III-A 节
审稿人笔记
- 表 II 的百分比可由分数复算:24/30=80%、20/30=66.7%、11/30=36.7%、8/30=26.7%,数字自洽(→ P.7 表 II)。
- 力通道并非免费:ROOT-90 上根误差 0.342→0.374 m、腕位置误差 36.75→44.70 mm;VLK-Pick-100 上腕位置误差反而 23.54→23.16 mm(→ P.6 表 I)。
- 真机力跟踪只给出 x 方向的数字(约 91% 幅值、1.1 N 误差);仿真中侧向和向下指令增益偏低(→ P.6)。
- 训练用的接触刚度为 100–800 N/m,且平面无摩擦、没有切向力(→ P.4–5),真机白板和箱子的接触条件超出这一范围,作者靠积分项来弥补。
- 真机对比只有同数据同控制器下关闭力的 DP 与两项消融,没有与其他力感知方法(如 WT-UMI、UniFP)在真机上对比(→ P.2 相关工作、P.5 基线)。