Type 2 · Promising method Key group 证据 B 收录
FLORA: An Open Model Suite for Scaling Robotics Data Engines
发布 · 收录于 2026-11-02
把开源视觉语言模型专门微调成“机器人视频标注员”,一套模型就能给出带时间戳的动作字幕和三种奖励标签,质量接近最强闭源模型,成本低约两个数量级。
- 任务
- 给机器人/人类操作视频自动打标签:分段字幕 + 结果/过程/rubric 奖励
- 模型
- Qwen3.5-9B 分段器 + Qwen3.5-27B 字幕器和奖励模型
- 数据
- WGO-Bench、DenseCaptionBench、RoboRewardBench、RobometerBench 及两个内部奖励基准
- 开源
- 代码(GitHub NVIDIA/Flora)与模型权重(Hugging Face)
- 主要数字
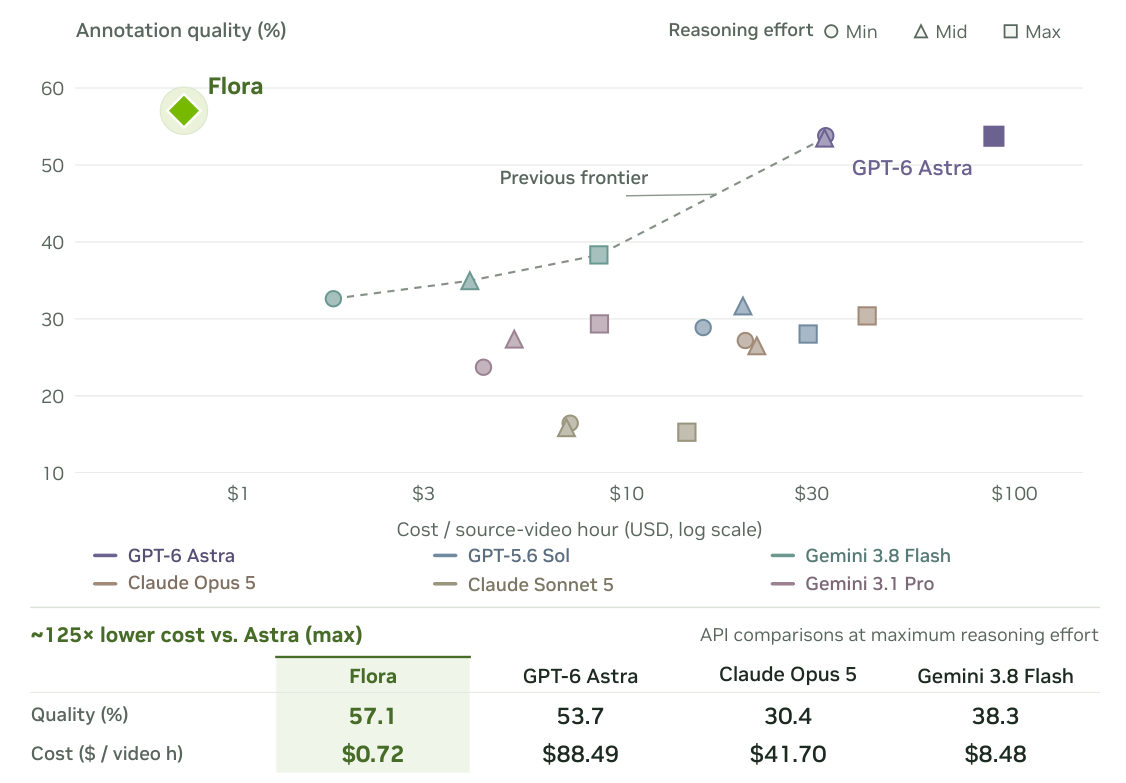
- 质量 57.1% 对 GPT-6 Astra 53.7%,每小时视频 0.72 美元对 88.49 美元
证据等级 B · 仿真充分 (A 真机 + 多基准 + 消融 / B 仿真充分 / C 单一基准或无代码)
动机
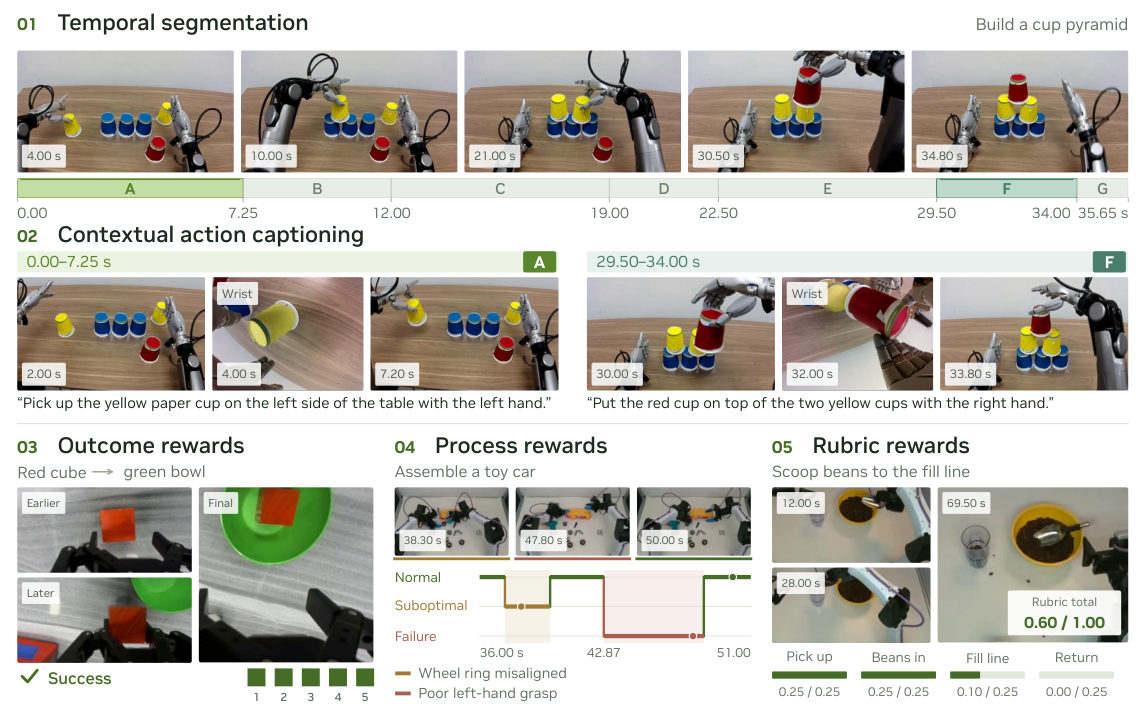
机器人基础模型从训练到部署,处处要标签:
- 预训练需要带时间戳的动作字幕(timestamped captions,即“第 3-8 秒:左手拿起杯子”),用来做语言条件和数据配比。
- RL 后训练需要过程奖励(process reward,即每一小步做得好不好)。
- 部署需要结果奖励(outcome reward,即整段任务成没成功),用来监控和评估策略。
现有工具大多只做其中一种;通用闭源大模型什么都能做,但按 API 计费,面对几十万小时的机器人数据太贵。作者想要一套又准又便宜、能本地大规模跑的标注模型(→ P.2 第 1 节)。
方法
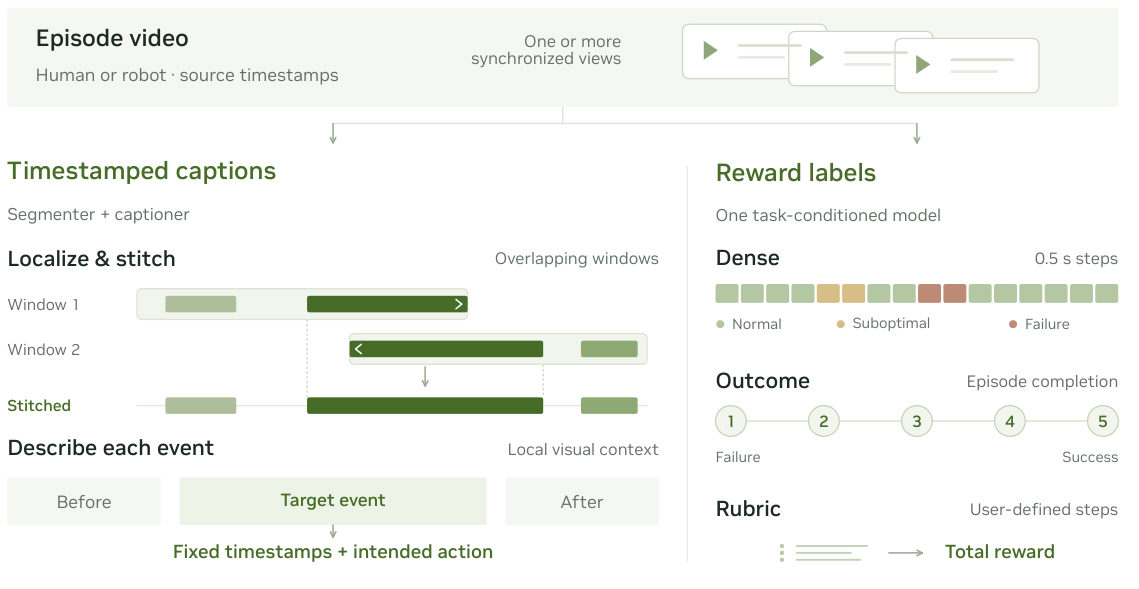
- 1切窗口长视频切成重叠的短窗口
- 2分段9B 模型找动作起止并拼接
- 3写字幕27B 模型看前后片段写指令
- 4打分同一奖励模型给三种奖励
- 5训练先 SFT,分段/字幕再 GRPO
比喻:像一个剪辑师加一个裁判。剪辑师先把长视频剪成一个个“镜头”(动作片段),再给每个镜头配一句字幕;裁判看同一段视频,按需要给出“整体成没成”“每半秒做得好不好”或“按评分表逐项打分”。
1. 分段与拼接(→ P.7 第 4.1 节,P.16):分段器在 16 秒的重叠窗口里预测动作起止时间,并标出动作是否延续到窗口外;只保留窗口中心区域的片段,再按时间重叠和延续标记拼成整段视频上的区间,同时保留并行发生的动作。
2. 带上下文的字幕(→ P.8 式 2):每个区间配上它前后相邻事件的画面作为参考,字幕器只描述中间这一段的“意图动作”(失败的尝试也写原本想做什么)。多相机录像会拼成一张马赛克图。
3. 一个奖励模型三种用法(→ P.8-9 第 4.2 节): - 结果奖励:给 1-5 分,再用 5 个分数 token 的概率算期望,换算成 0-1 的连续值。 - 稠密奖励:每 0.5 秒标 失败(1)/次优(2)/正常(3),并给非正常片段写理由;窗口 16 秒、每次前移 10 秒,丢掉每个窗口最后 4 秒,保证判断时能看到后续画面。 - Rubric 奖励:用户给出步骤和每步可选分值(满分合计 1),模型逐步打分后求和。
训练(→ P.9 第 4.3 节):三个模型都先做监督微调(SFT);分段器和字幕器再用 GRPO(一种按组内平均分算优势的强化学习)优化,分段奖励由时间 F1、精度和边界误差加权组成,字幕奖励按“覆盖了多少参考要点、犯了多少事实错误”计算。发布的奖励模型只做了 SFT。
实验
本文方法 对比方法 · 数据来源:Table 4, P.14
本文方法 对比方法 · 数据来源:Table 5, P.14
本文方法 对比方法 · 数据来源:Table 9, P.20
字幕(→ P.13 表 2、表 3) - WGO-Bench(100 段公开视频):分段 F1@0.75(越高越好)Flora 50.3,最好;但联合 F1(时间和字幕都对才算)GPT-6 Astra 39.0 高于 Flora 34.5,字幕准确率 Astra 77.4 对 64.7。 - 作者自建的 DenseCaptionBench(300 段,人类/平行夹爪/灵巧手各 100):人类视频上 Flora 三项全胜(联合 F1 37.4 对 Astra 29.7);机器人视频上 Astra 三项都更好(联合 F1 57.9 对 51.0)。
奖励(→ P.14 表 4、表 5) - RoboRewardBench:MAE(平均绝对误差,越低越好)Flora 40.0,Astra 55.4,专用模型 RoboReward 66.5。 - RobometerBench:OOD 排序 Kendall(越高越好)Flora 72.0,低于 Astra 82.3。 - DenseRewardBench(内部 40 段):四项指标都最好,失败召回 53.3%,其他模型不超过 11.7%;代价是约 11% 的正常步被标成失败(→ P.6)。 - RubricBench(内部 40 段):L1 误差(越低越好)6.5,Astra 3.6 更好。
和其他标注流程比(→ P.20 表 9):换成 Gemini 3.8 Flash 做底座后,开源流程 Refiner 的联合 F1 达到 36.4,略高于 Flora 的 34.5;把 Flora 的流程直接套在 API 模型上只有 16.4,说明收益主要来自微调后的模型,而不是流程本身。
成本(→ P.2 图 2,P.22 附录 D):每小时视频约 0.72 美元(假设 8 张 GB300、每 GPU 小时 10 美元),GPT-6 Astra 最高推理档 88.49 美元。这是按吞吐模型估算的,不是实测账单。
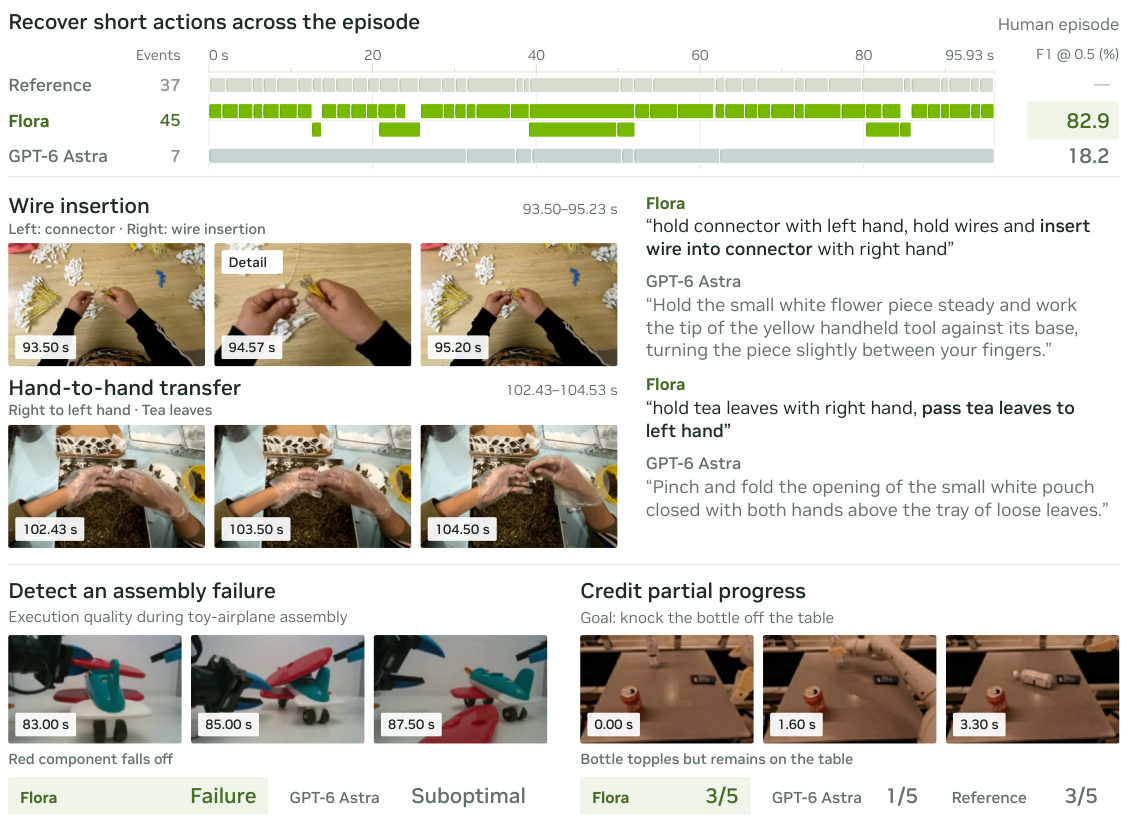
站得住的结论:微调后的开源模型在“找失败时刻”和“给部分完成打分”上明显强于通用大模型;在机器人视频字幕上仍落后于最强闭源模型。
审稿人视角
这一部分是 Claude 读完全文后的看法和判断,不是论文自己的说法。
先读哪
先看第 1 页图 1 了解五种输出,再看第 3 页表 1 的总成绩,最后看第 14 页表 4、表 5 的奖励结果
值得看的理由
- 一个开源的奖励模型同时给出结果分、稠密过程分和 rubric 分;在公开的 RoboRewardBench 上 MAE 为 40.0,低于 GPT-6 Astra 的 55.4 和专用模型 RoboReward 的 66.5。 → P.14 表 4
- 在找“哪一刻出错”的 DenseRewardBench 上,失败召回率 53.3%,所有通用大模型都不超过 11.7%(GPT-6 Astra 为 0.0),而它的底座 Qwen3.5-27B 只有 5.7%,说明微调数据确实教会了它识别失败。 → P.14 表 5
- 50 段视频的标注成本估计为每小时视频 0.72 美元,GPT-6 Astra 最高推理档为 88.49 美元,质量 57.1% 对 53.7%;模型和代码都已开源,可以自己部署复核。 → P.2 图 2
审稿人式质疑
- 摘要说在 WGO-Bench 和 Robometer 上达到 SOTA,但表格显示:WGO-Bench 联合 F1 GPT-6 Astra 39.0 高于 Flora 34.5,字幕准确率 77.4 对 64.7,Flora 只在分段 F1 上领先;Robometer OOD Kendall Astra 82.3 高于 Flora 72.0,Flora 只胜过专用奖励模型。 → P.13 表 2;Table 4 (P.14);摘要 P.1
- 全文只评“标签与人工参考是否一致”,没有任何实验证明 Flora 标签能让策略预训练或 RL 后训练变好;“已用于训练 GR00T”没有给出数字。DenseCaptionBench 的字幕评分由 GPT-6 Astra 担任裁判,而它同时是被比较的对手,作者自己承认存在自我偏好风险。 → P.17 第 B.3 Judging;Sec. 1 (P.2) 节
审稿人笔记
- 成本和吞吐是模型估算:附录写明 Flora 的工作量是假设值,“生产 GPU 小时分母未经核实”,96 GPU 线性扩展也未实测(→ P.22 D.2,P.23-24 图 7)。
- 奖励评测里通用模型只用中等推理档,推理算力没有对齐;专用奖励模型的分数直接抄自原论文,协议不同,例如 RynnValue 排的是 976 条轨迹而不是 567 条(→ P.21 附录 C)。
- DenseRewardBench、RubricBench 是内部基准,DenseCaptionBench 由作者构建,均未说明是否公开;机器人字幕轨道有 98 个裁判任务缺失、5 个数据源未重新生成字幕(→ P.18 B.4)。
- 成绩只报告单次均值,主表没有方差;只有图 7 给了 50 段子集上的自助法置信区间(→ P.24)。
- 没有组件级消融(例如去掉 GRPO、去掉前后文);与此最接近的是把 Flora 流程换成 API 模型的诊断实验(→ P.19-20 表 9)。