Type 2 · Promising method Requested 证据 A 收录
Ropedia W0: Scaling Loco-Manipulation World Models across Embodiments with Human Experience
发布 · 收录于 2026-11-05
把人和各种机器人的动作都画成“相机轨迹+图像上的骨架”,一个视频世界模型就能同时学 1 万小时人类视频和 3 千小时机器人视频,并随人类数据增多而变强。
- 任务
- 第一人称移动操作(loco-manipulation)视频预测,即世界模型
- 数据
- Xp-Data:约 1 万小时人类 + 3 千小时机器人视频
- 硬件
- 8 种本体,真机用 Unitree G1 + 灵巧手
- 代码
- 已公开(GitHub + 项目页)
- 主要数字
- Xp-Teleop 零样本 PSNR 16.42 dB,最佳基线 13.85
证据等级 A · 真机 + 多基准 + 消融 (A 真机 + 多基准 + 消融 / B 仿真充分 / C 单一基准或无代码)
动机
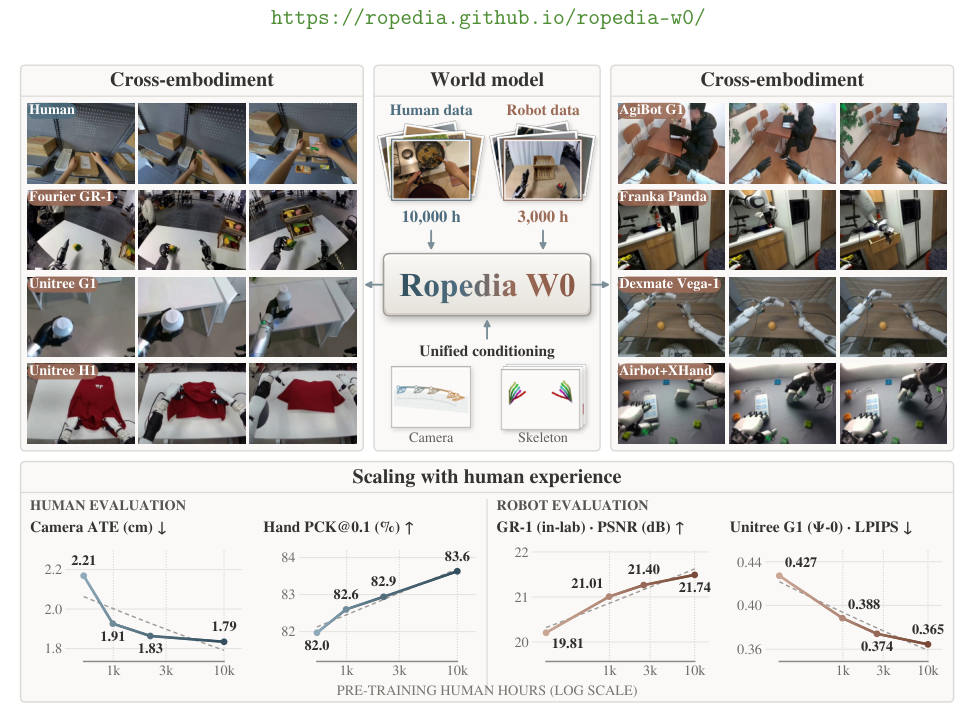
世界模型(world model) 是一个“想象器”:给它当前画面和接下来的动作,它预测未来画面,机器人就能先在脑子里试一试再动手。
现有机器人世界模型大多只管固定底座的夹爪操作,很少处理“边走边做”(行走带来的视角变化 + 灵巧手操作)。更麻烦的是跨本体:不同机器人的关节数量和含义都不一样,DreamDojo、Cosmos3 等方法要给每种新机器人单独设计动作接口或额外适配(P.2)。
人类第一人称视频很多、很便宜,但公开数据集常缺少米制相机轨迹、手部标注噪声大、格式不统一,难以直接拿来训练(P.2)。
方法
- 1收数据1万小时人类+3千小时机器人视频
- 2统一标注相机轨迹+投影骨架,人工校正
- 3编码动作相机→射线图,手→骨架图
- 4视频扩散首帧+文字+控制图预测未来画面
- 5两段训练先人类预训练,再人机1:1混合
- 6蒸馏提速4步因果学生,约21帧/秒
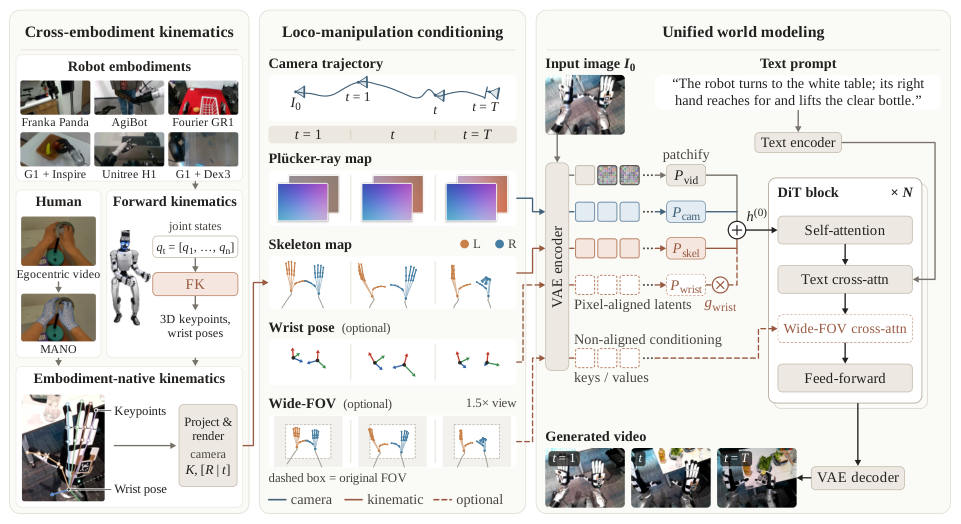
比喻:不管是人手、夹爪还是五指灵巧手,都先画成一张贴在画面上的“火柴人”骨架图;模型只需学会“骨架这样动、镜头这样走,画面会怎么变”,于是人类视频学到的规律可以直接搬给机器人。
1. 统一的运动表示(P.7-8) - 行走:相机相对首帧的位姿编码成 Plücker 射线图(每个像素记录一条视线的方向和位置,共 6 个通道),平移用米制单位,不同本体尺度一致。 - 操作:人手用 WiLoR/MANO 估计的手部关键点;机器人用 URDF 正运动学(FK,由关节角算出各关节位置)投影到图像上,再大量人工标注和纠正对不齐的关键点(P.6)。 - 可选:手腕位姿图、1.5 倍视野的“宽视野骨架”,补上画面外的手臂信息。
2. 条件注入(P.9):基于 Wan2.2 视频扩散模型,有 5B 稠密版和 A14B 混合专家版(约 27B 总参数、14B 激活)。射线图和骨架图编码后与视频 token 逐位置相加(投影层零初始化,开始时不破坏原模型);宽视野骨架因为和画面不逐像素对齐,走单独的交叉注意力。
3. 训练与蒸馏(P.9-10):先只用人类视频预训练,再用人类和机器人数据各占一半继续训练(mid-training)。之后蒸馏成 4 步自回归学生模型,并用 LongLive 做流式长视频生成,实现分钟级实时生成。
实验
本文方法 对比方法 · 数据来源:Table 4, P.14
本文方法 对比方法 · 数据来源:Table S6, P.42
本文方法 对比方法 · 数据来源:Table S7, P.42
评测:五个跨本体基准(DreamDojo 的 GR-1 三个测试集、Ψ0、ω-HOME、自建 Xp-Teleop、AgiBot)加 200 段没见过的人类第一人称视频(P.11)。指标:PSNR、SSIM 越高越好,LPIPS 越低越好;相机轨迹误差 ATE/RPE/RRE 越低越好,手部 PCK 越高越好。对比 DreamDojo(2B/14B)、Cosmos3(16B/64B)、OSCAR、RynnWorld-Teleop(P.12)。
主要结果 - 人类视频零样本:A14B 预训练版 PSNR 19.77,Cosmos3-Nano 18.66;相机 ATE 1.542 cm vs 1.931 cm(表 2,P.13)。 - DreamDojo 基准只用 1% 后训练数据:A14B 在 In-lab 上 PSNR 23.028,DreamDojo 14B 为 18.983(表 3,P.14)。 - Xp-Teleop 不做后训练:A14B 已超过所有基线用全量数据后训练的结果(表 4,P.14)。注意“零样本”指评测数据集没训练过,但同一种机器人可能在混合训练里出现过(P.12)。 - 消融:去掉骨架条件,A14B PSNR 掉 3.8 dB;去掉相机条件平均只掉 0.3 dB,但在视角移动的本体上掉 1.3 dB(P.13)。 - 规模:随人类预训练小时数增加(对数坐标到 10k 小时),人类和机器人评测都单调变好(图 6-8,P.15-16);模型从 5B 换到 A14B,PSNR 再涨 1.4-2.3 dB(P.15)。
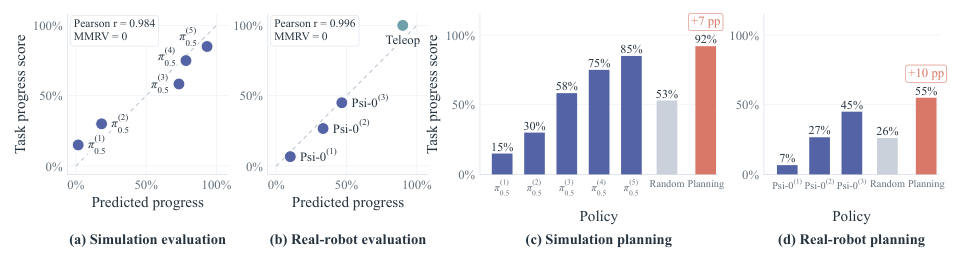
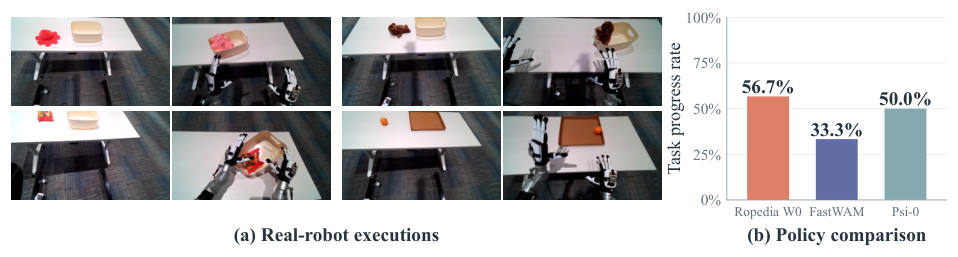
下游应用(P.16-18):当策略评估器,与真实成绩相关系数 0.984(仿真)/0.996(真机);做候选规划,仿真任务进度 92%(随机 53%)、真机 G1 55%(随机 26%);初始化世界-动作模型,LIBERO-Plus 成功率 50.06%→56.82%,真机 G1 任务进度 56.7%(FastWAM 33.3%)。
速度:蒸馏后的 4 步 5B 学生在单卡上 640×480 达 21.3 帧/秒,比 50 步教师快 7 倍,质量不降(表 S1,P.36)。
站得住的:多基准、多规模、带消融,预训练与官方底座的对照很干净。要打折的:真机实验规模小;主要指标是像素相似度,不直接衡量接触和物体物理是否正确(作者也承认,P.54)。
要点 Take-home
- 把动作画成相机轨迹加图上骨架,人和不同机器人能共用一个世界模型
- 人类视频越多,人和机器人的预测都持续变好
- 有人类预训练后,1% 机器人数据就胜过从头用 100% 数据
- 它只学画面后果,不建模接触和物体物理,真机验证仍较少
Claude 读完全文后的提炼。
更多:先读哪 · 值得看的理由 · 质疑
先读哪
先看第 1 页图 1 和第 8 页图 4,再看第 14 页表 4 和第 17 页图 9
值得看的理由
- 统一的相机+骨架接口让人类视频直接帮到机器人:只用 1% 机器人数据,就超过官方底座用 100% 数据的效果 → P.14 第 6.3 / Table S7 节
- 不只比画面:真机 G1 上做了策略评估、候选规划和世界-动作模型初始化,且代码和项目页已公开 → P.17 第 6.4, Fig. 9, Table 6 节
质疑
- 真机证据偏薄:真机策略评估的相关系数只基于 4 个点(3 个 Ψ0 检查点+遥操作),真机规划和世界-动作模型的试验次数未报告 → P.17 第 6.4, Fig. 9(b,d) 节