Type 1 · Project-related Must-readRequestedKey group 证据 B 收录
StopWatch: Goal Grounding for Object-goal Navigation
发布 · 收录于 2026-11-02
VLM 导航策略探索得不错却常常走过目标不停,原因是缺少目标定位(goal grounding);把“目标在不在视野、离多远”显式写成文本交给策略,就能明显提高成功率。
- 任务
- 开放词汇物体导航(ObjectNav),仿真
- 数据
- HM3D、MP3D、HSSD 共六个基准;训练用约 310 万条示范
- 模型
- Qwen3-VL-4B 感知 + Qwen3-VL-2B 策略,Stretch 本体
- 主结果
- 修正版 HM3D-OVON val_unseen 成功率 69.6%(次优 60.8%)
- 代码
- 有项目页;论文未写明是否开源代码,表示公开修正评测
证据等级 B · 仿真充分 (A 真机 + 多基准 + 消融 / B 仿真充分 / C 单一基准或无代码)
动机
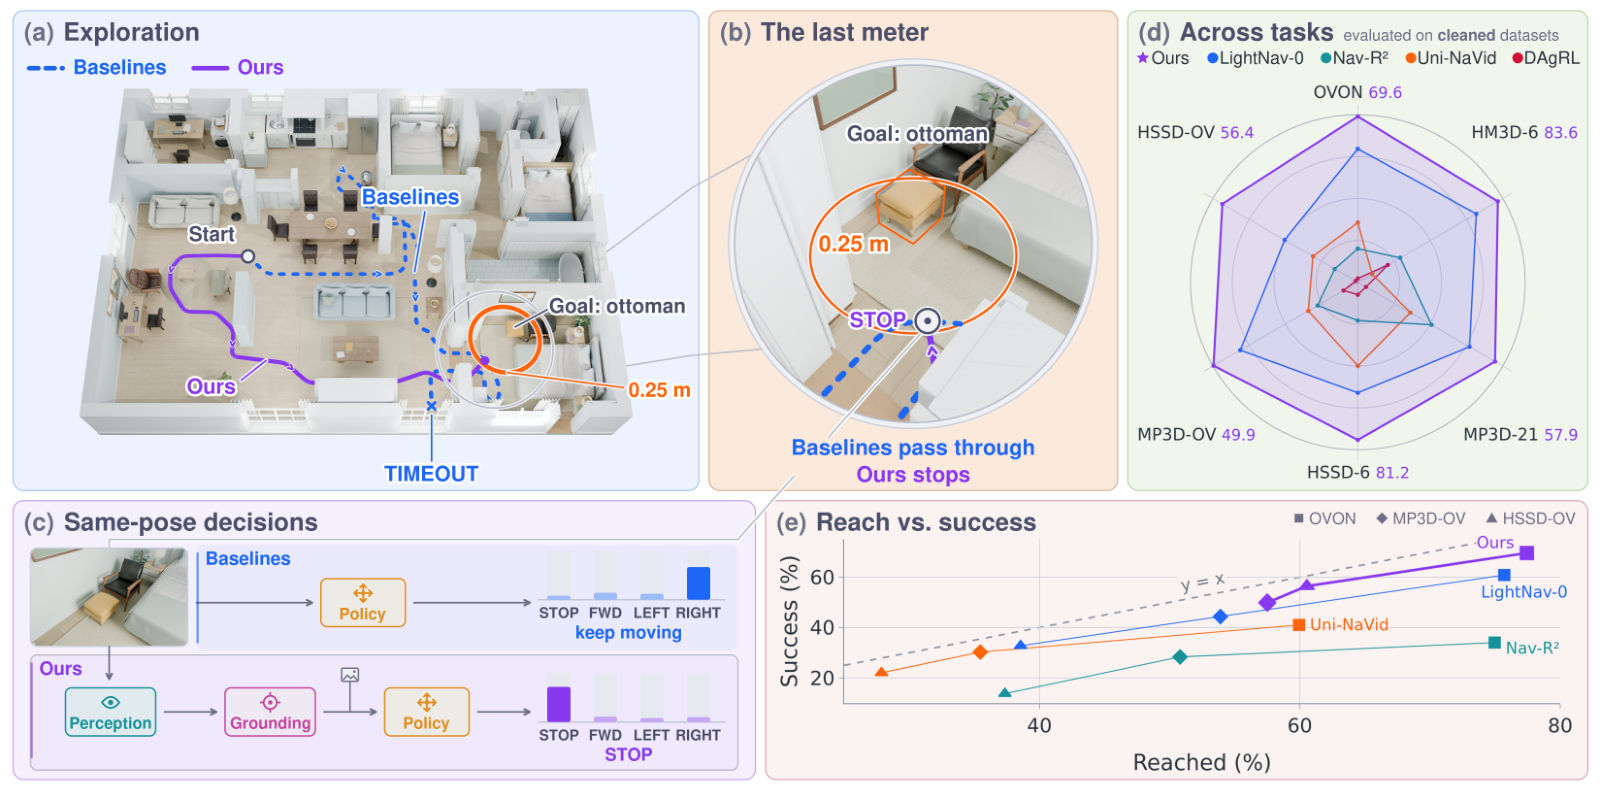
问题:物体导航(ObjectNav)要求机器人在陌生房屋里找到某类物体,并在离它 0.25 m 内主动停下。现在主流做法是把视觉语言模型(VLM,能同时看图和读文字的大模型)用模仿学习(behavior cloning,照着专家示范学动作)微调成导航策略。
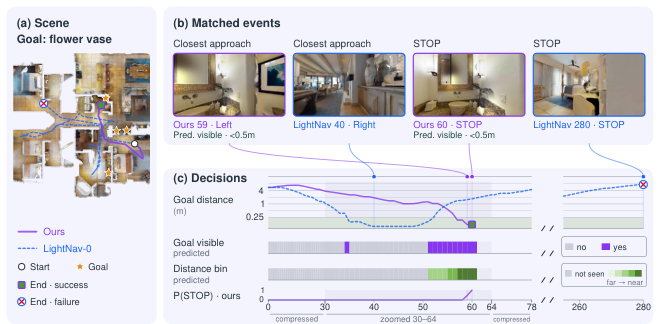
卡在哪:作者追踪发现,这类策略在 76.3% 的回合里已经走到目标 0.25 m 内,最终却只成功 52.3%(P.3 图 2)。它们不是不会找,而是不知道自己已经到了。
为什么难:每条示范只在最后有一个 STOP 动作,而且只覆盖训练类别。从这么少的信号里,策略学不会判断“新类别的目标在不在眼前、有多远”(P.4 Sec. 3.2)。
方法
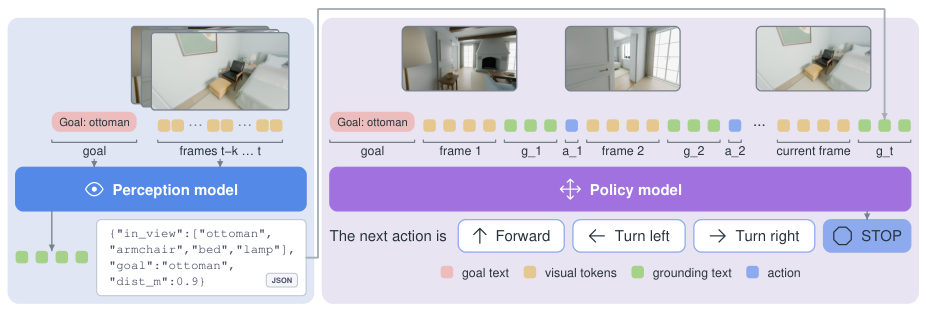
- 1看画面最近若干 RGB 帧和目标词送入感知模型
- 2写定位输出可见物体列表与目标距离档
- 3交织读策略按时间顺序读帧和定位文本
- 4出动作前进、左转、右转或停止
比喻:像开车时副驾驶一直报“目标在视野里,不到半米”,司机只管照着做决定。副驾驶是感知模型,司机是策略模型。
关键 1:显式、结构化的 grounding 文本。每一帧都附一段短文本:画面里有哪些物体类别(最多 16 个)、目标是否可见、目标距离档(<0.5 m、0.5–1 m、1–2 m、2–4 m、>4 m 或未看见)(P.16 表 7)。训练时这段文本直接由场景的语义和几何标注算出,不需要额外人工标注,所以每一帧都有监督,而不是每条示范只有最后一个 STOP。
关键 2:两个模型分开训练(disjoint grounding)。感知模型(4B)只学从画面预测这段文本;策略模型(2B)读画面加真值文本学动作。测试时把真值换成感知模型的预测。作者发现让一个模型先写文本再出动作反而更差(P.8 表 2)。分开的好处是感知可以单独换强,不用重训策略(P.14 表 3)。
实验
本文方法 对比方法 · 数据来源:Table 1, P.7
本文方法 对比方法 · 数据来源:Table 1, P.7
本文方法 对比方法 · 数据来源:Table 2, P.8
数据与指标:HM3D-OVON(val_seen / val_unseen)、HM3D 6 类、MP3D 21 类、HSSD 6 类,以及作者新建的 MP3D-OV 和 HSSD-OV。主指标是成功率(SR,越高越好);附录另报 SPL(按路径长度加权的成功率,越高越好)(P.15 表 4)。每个基准给两种口径:官方口径,和作者修正标注后的干净口径。
对比对象:端到端 VLM 策略 Uni-NaVid、LightNav-0、Nav-R²,HM3D-OVON 官方基线 DAgRL,零样本模块化方法 VLFM。
结果:本文在全部六个基准、两种口径下都排第一(P.7 表 1)。干净口径 HM3D-OVON val_unseen 为 69.6%,比 LightNav-0 高 8.8 分;官方口径高 6.4 分。到达目标附近后,本文约 90% 能成功停下,LightNav-0 约 80%(P.7、P.19 图 11)。
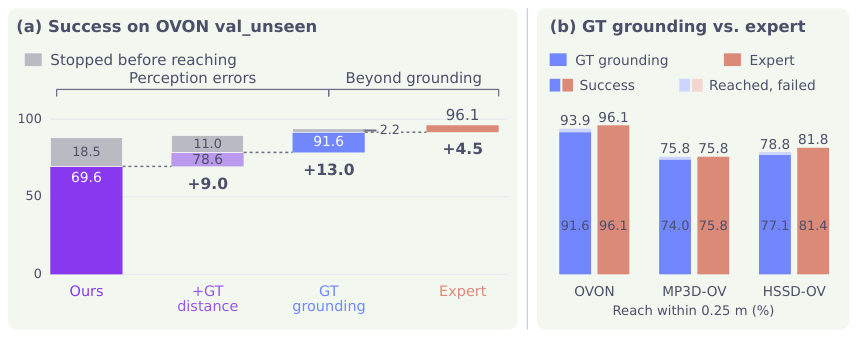
站得住的结论:(1)把真值 grounding 交给同一策略,成功率升到 91.6%,与示范专家(96.1%)相差 4.5 分,说明剩下的空间主要在感知(P.8 图 7);(2)失败里 34.3% 是误报目标、26.0% 是距离估错、8.8% 是漏报(P.9 图 8a);(3)换用更强的通用 VLM 做感知,成功率可再升,但每步耗时约 9 倍(P.14 表 3)。
代价:感知模型训练 743 B200 GPU 小时,策略 286 GPU 小时(P.17 表 8);感知每步约 1.0 s(P.14 表 3)。
审稿人视角
这一部分是 Claude 读完全文后的看法和判断,不是论文自己的说法。
先读哪
先看第 3 页图 2(失败流向),再看第 7 页表 1 和第 8 页图 7、表 2
值得看的理由
- 诊断干净:同一个策略只多给真值 grounding 文本,成功率从 52.3% 升到 89.3%,错误停止从 690 次降到 0,说明瓶颈在“认出目标并判断距离”,不在探索。 → P.19 表 9(对应 P.3 图 2)
- 在三套场景、六个基准上,官方和修正两种评测口径下都排第一;官方口径 HM3D-OVON val_unseen 为 53.9%,次优 LightNav-0 为 47.5%。 → P.7 表 1
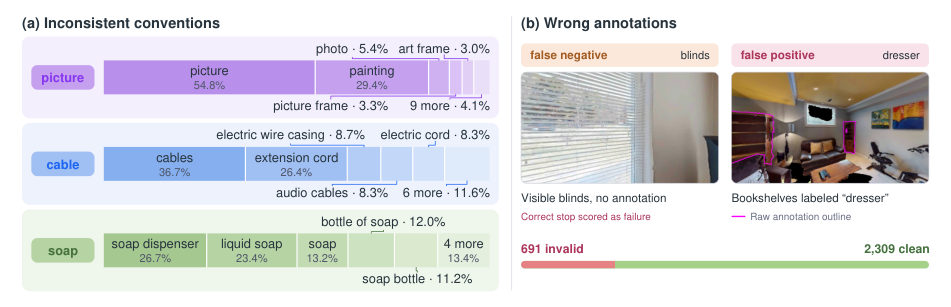
- 指出 HM3D-OVON 评测的两类标注缺陷:同一物体多种叫法只认一种,且人工审核剔除了 3,000 个 val_unseen 回合中的 691 个;作者表示公开修正版评测和两个新基准。 → P.6 图 5、Sec. 3.4(P.5)、P.9 Broader impact
审稿人式质疑
- 修正版评测由作者自定(剔除 23% 回合、改用“目标占画面 5% 以上的视点”判成功),它给本文加 15.7 分、给 LightNav-0 加 13.3 分;MP3D-OV 和 HSSD-OV 只用这一口径。基线按各自的机器人本体运行,本文用 Stretch 本体,相机高度和视场角并不统一。 → P.15 表 1(P.7)、Appendix C
- 所有结果只跑一次,没有多随机种子或方差;只在静态室内仿真中测试,真机效果仅为推测。消融里已有语义字段时,距离字段只多 0.9 分(68.7→69.6)。 → P.8 表 2、P.9 Limitations
审稿人笔记
- 图 1e 的“到达后 90% vs 80% 成功”与附录一致:69.6/77.4 和 60.8/75.7(P.19 图 11)。
- 真值 grounding 的成功率在表 1 和图 7a 是 91.6%,在表 3 是 91.1%,两处差 0.5 分,正文未解释(P.7、P.8、P.14)。
- 消融里距离字段只多 0.9 分(P.8 表 2),但把预测距离换成真值能加 9.0 分(P.8 图 7a)。说明瓶颈是距离估计的准确度,而不是要不要这个字段。
- 作者排除了几个没有公开权重或设置不同的近期系统(Ren et al. 2026、Chu et al. 2026、Zhang et al. 2026b),因此“全面领先”只针对开源基线(P.6 Sec. 4.1)。
- 修正口径下有 16 次基线成功落在被剔除的回合里(LightNav-0 六次、Nav-R² 十次),作者在附录写明(P.15 Appendix C)。