Type 2 · Promising method Requested 证据 B 收录
BeJEPA: A Goal-Conditioned Humanoid Behavior World Model via Unsupervised RL
发布 · 收录于 2026-11-02
把“一步物理预测”和“目标条件下的长期行为总结”放在同一潜空间里联合学习,人形机器人就能同时控制全身姿态和世界中的位置、朝向,不需要长程想象滚动。
- 任务
- 人形全身控制:同时到达目标姿态、世界位置和朝向;20 秒动作跟踪
- 数据
- AMASS、LAFAN(MuJoCo 中评测);训练用约 4.78 小时重定向动作
- 硬件
- Unitree G1(29 个关节),LiDAR + FAST-LIO 提供位姿
- 代码
- 有项目页;文中未说明是否开源代码
- 主结果
- AMASS 全局 MPJPE 219.5 mm(带在线修正),SONIC 为 531.5 mm
证据等级 B · 仿真充分 (A 真机 + 多基准 + 消融 / B 仿真充分 / C 单一基准或无代码)
动机
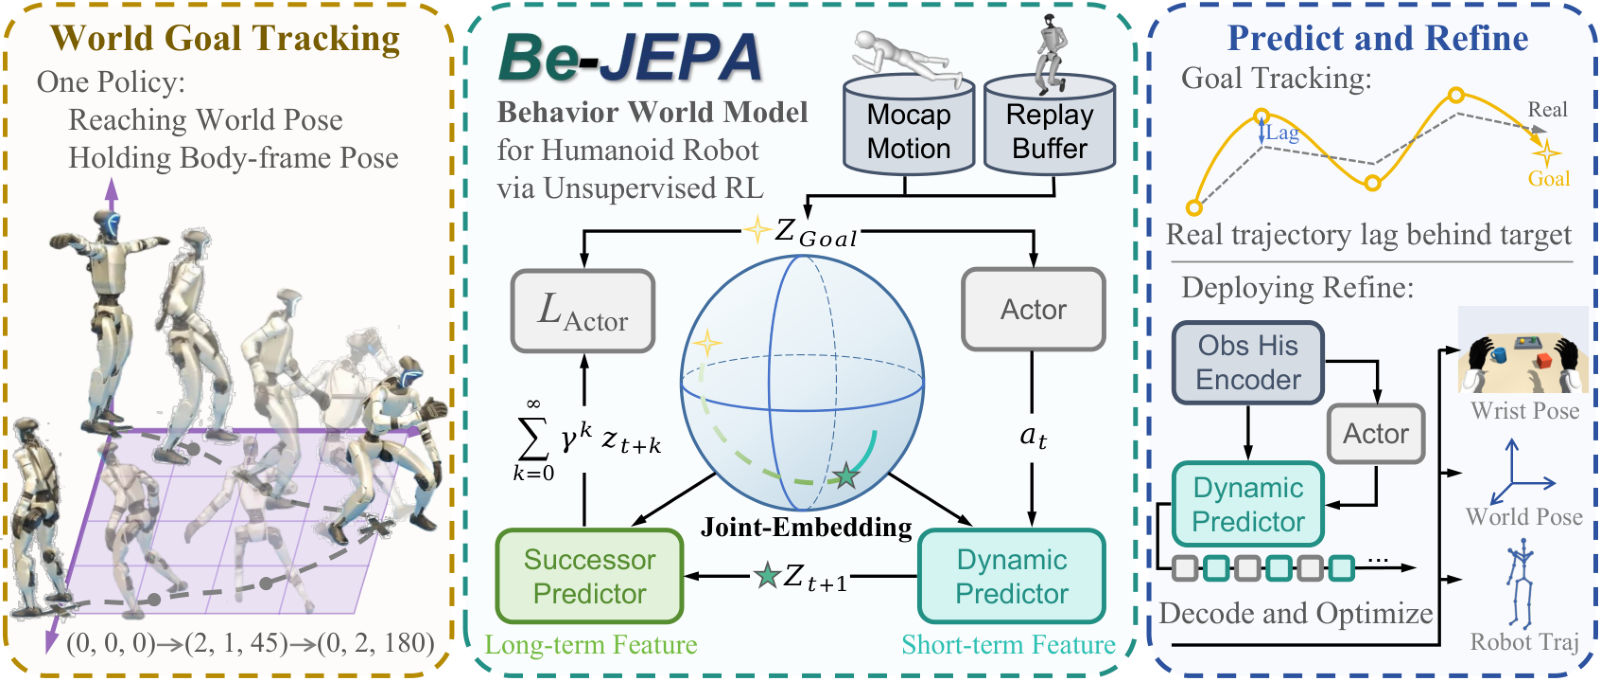
人形机器人做事时,不只要摆对姿势,还要站在世界里正确的位置、朝向正确的方向。
- 主流的动作跟踪控制器在根坐标系(以机器人骨盆为原点的坐标)里模仿人类动作,姿势像了,但被推开后不会主动走回原位。
- Meta Motivo、BFM-Zero 这类无监督强化学习(不用任务奖励、先学一套通用行为再按目标调用)方法,学到的目标只包含相对身体的姿态,绝对位置和朝向不在目标里。
- 难点在于:要回到原位,机器人得先迈步,这一步会暂时让姿势更不像目标。控制器必须能判断“眼下变差、之后变好”的动作是值得的。(→ P.2 第 1 节)
方法
- 1编码把身体姿态和世界位姿编成同一向量
- 2一步预测Dynamic 预测动作后的下一刻向量
- 3长期总结Successor 总结之后会去到哪里
- 4打分与目标向量做内积,给动作打分
- 5在线修正部署时用 Dynamic 做短程 MPC
比喻:下棋时,只看一步不够,推演整盘又太累、容易算错。BeJEPA 的做法是“走一步,再凭棋感估计这样下去局面大致如何”。Dynamic 是“走一步”,Successor 是“棋感”。
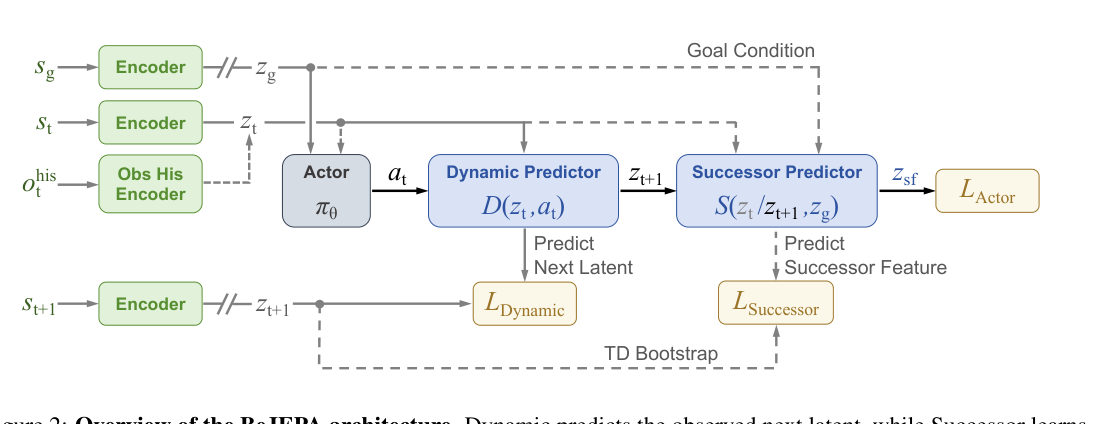
共享潜空间(JEPA):JEPA(joint-embedding predictive architecture,联合嵌入预测架构)不重建原始观测,而是在学到的向量空间里做预测,只保留可预测、对控制有用的信息。BeJEPA 把当前状态和目标都编码成长度固定的向量,目标奖励就是两个向量的内积,越接近目标奖励越高(→ P.3 公式 1)。
两个预测器(→ P.5): - Dynamic:输入当前向量和动作,预测下一刻的向量。它与目标无关,任何一次执行过的动作都能拿来训练。 - Successor:输入状态向量和目标,输出“后继特征”(successor feature,即按折扣加权平均的未来状态向量),相当于总结“按当前策略追这个目标,未来会待在哪些状态”。它用一次真实转移加上自身对下一步的预测来训练(时序差分 TD)。
组合打分:动作价值 ≈ 〈(1−γ)·当前向量 + γ·Successor(Dynamic(当前, 动作), 目标), 目标〉(→ P.5 公式 7)。执行器(actor)的梯度先穿过 Successor、再穿过 Dynamic 回到动作上,训练时两个预测器保持不变。训练早期 Dynamic 的权重大,帮编码器先学到物理结构,之后逐步降权,让 Successor 主导(→ P.17 附录 C.2)。
在线修正(MPC):部署时,执行器先给出一串动作,再用 Dynamic 往前预测 3-24 步,按潜向量距离、根位置、朝向和手腕误差算代价,做几步有界梯度修正,只执行第一步(→ P.6 公式 13,P.15 表 3)。网络权重全程不变。
实验
本文方法 对比方法 · 数据来源:Table 1, P.7
本文方法 对比方法 · 数据来源:Table 1, P.7
本文方法 对比方法 · 数据来源:Table 2, P.8
设置:Isaac Sim 4096 个并行环境训练,在 MuJoCo 中以 50 Hz 评测 G1 策略;AMASS 和 LAFAN 各取 20 秒片段,偏离很大的轨迹也计入统计,而不是记作失败后剔除(→ P.7)。
指标(全部越低越好):MPJPE(mean per-joint position error,平均关节位置误差,mm),分全局版(世界坐标)MPJPE_G 和局部版(骨盆坐标)MPJPE_L;根误差;手腕误差。
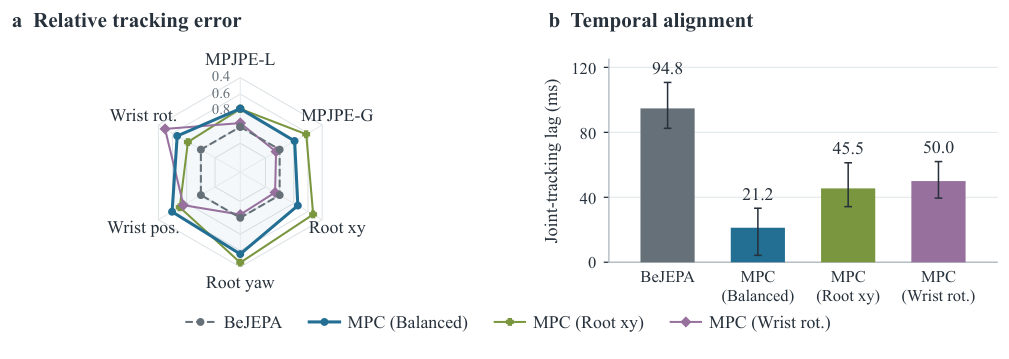
主结果(→ P.7 表 1): - 全局误差上,BeJEPA 不加修正就是学习型策略里最好的;AMASS 上 278.0 mm,SONIC 531.5,BFM-Zero(世界坐标版)573.4,Humanoid-GPT 832.4。加 MPC 后降到 219.5。 - 局部姿态误差上,SONIC 最好(49.7),BeJEPA 是 82.3。作者的解释是:修正世界位置有时要牺牲局部姿势。 - MPC(Balanced)把 AMASS 上的平均跟踪滞后从 94.8 ms 降到 21.2 ms(→ P.8 图 3b)。
消融(→ P.8 表 2):合并预测器、切断任一预测器的编码器梯度、只用 Dynamic 做 MPC,位置和朝向误差都比完整模型大。只用 Dynamic 做 MPC 时平均朝向误差达 82.23°,说明单步模型撑不起远目标。
潜空间分析(→ P.9 图 4、5):世界 x、y 和朝向在潜空间里有规律地分布;用线性读出时,根高度 R² 0.74(BFM-Zero 0.54),线速度 0.69(0.44),但位置和朝向两者相当。
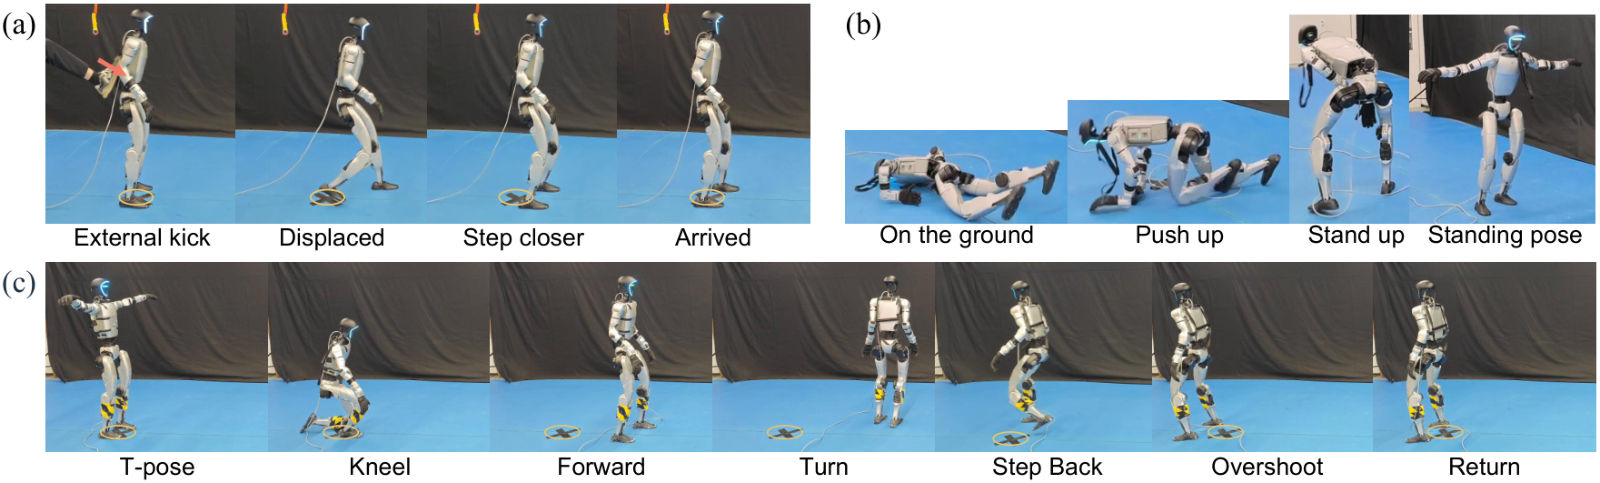
真机(→ P.10 图 6):被踢后两步回到原位;从地上撑起、站立;T 字姿势 → 跪 → 前进 → 转身 → 回到原地标记。只有图片,没有数字。
代价:核心模型 121.54 M 参数,部署只需执行器和历史编码器(33.08 M)(→ P.17 表 4)。论文没有报告 MPC 每步的计算耗时。
审稿人视角
这一部分是 Claude 读完全文后的看法和判断,不是论文自己的说法。
先读哪
先看第 4 页图 2 和第 5 页公式 7,再看第 7 页表 1 和第 8 页表 2
值得看的理由
- 动作价值写成“走一步 + 一次长期总结”:Dynamic 预测下一刻潜向量,Successor 直接给出之后的折扣未来特征,二者组合即可给动作打分,不需要长程想象滚动。这是一个可迁移到其他目标条件控制问题的新写法。 → P.5 式 7, Eq. 11
- 消融比较干净:同样两个预测器,只切断某一个对编码器的梯度,或合并成一个预测器,平均位置误差都明显变差(合并 1.348 m,完整模型 0.642 m)。说明“分开预测 + 共同训练编码器”这一设计确有作用。 → P.8 表 2
- 不加在线修正时,AMASS 上全局 MPJPE 为 278.0 mm,约为 SONIC(531.5)和世界坐标版 BFM-Zero(573.4)的一半;并在 Unitree G1 真机上演示了被踢后回到原位、从地上站起、连续切换目标后回到原地标记。 → P.7 表 1;P.10 Fig. 6
审稿人式质疑
- 真机部分只有定性截图:没有试验次数、成功率或位置/朝向误差数字;真机上的世界位姿来自 LiDAR + FAST-LIO,其误差对结果的影响也没有分析。“真机闭环回到原位”这一主张目前无法量化核对。 → P.9 第 4.4, Fig. 6 (P.10) 节
- 摘要里的 61.7% / 58.7% 用的是加了测试时梯度优化的 BeJEPA-MPC,基线都没有类似的在线修正;SONIC、Humanoid-GPT 本来就在根坐标系下跟踪,并不以回到世界位姿为目标。在局部姿态误差 MPJPE_L 上,SONIC(49.7)仍明显好于 BeJEPA(82.3)和 BeJEPA-MPC(63.9)。表 1、表 2 均未报告多次运行的方差或种子数。 → P.7 表 1
审稿人笔记
- 摘要中 61.7% 和 58.7% 两个数可以从表 1 复算:(573.4−219.5)/573.4 ≈ 61.7%,(531.5−219.5)/531.5 ≈ 58.7%,用的都是带 MPC 的版本(→ P.7 表 1)。
- Balanced 和 Root-xy 两种 MPC 只在平均平面速度 ≤ 0.8 m/s 的参考片段上启用,更快的片段仍由执行器单独控制(→ P.15 附录 B.2)。
- 评测用的是“选定的非交互” AMASS 片段,文中没有给出选择标准和片段数量(→ P.7 第 4.1 节)。
- 表 6 的百分比都是 12.5% 的倍数,看起来每种姿态只有 8 次执行,但论文没有写明次数(→ P.21 表 6)。
- Dynamic 开环滚动约 8 步(160 ms)内位姿读数较准,到 64 步时位置误差约 45-150 cm、朝向误差约 48-86°,作者也承认它不是可靠的长程模拟器(→ P.21-22 附录 E.2 图 10)。