Type 1 · Directly applicable 证据 B 收录
R^2Orch: Recursive Self-Improvement for Agent Orchestration via Self-Play within a Skill-Internalization Loop
发布 · 收录于 2026-11-03
让出题者专挑“藏掉某个技能后结果仍有分歧”的任务,并用同一组 rollout 的随机对照决定何时撤掉技能,编排器最终可以不靠任何提示技能也表现最好。
- 任务
- 学习搭建多智能体协作图(agent orchestration)
- 数据
- 6 个训练内基准 + 6 个留出基准(问答、数学、代码、ALFWorld、WebShop)
- 硬件
- 无机器人;Qwen3.5-9B,约 106 A100 小时
- 代码
- 已开源(GitHub: beita6969/R2Orch)
- 主要数字
- 零技能下 WebShop 成功率 91.09%
证据等级 B · 仿真充分 (A 真机 + 多基准 + 消融 / B 仿真充分 / C 单一基准或无代码)
动机
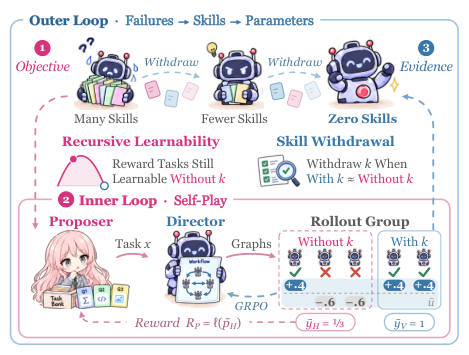
要解决什么:一个“导演”模型(Director)为每道题搭一张多智能体图(每个节点是一个带角色提示的 LLM,边是交接关系),再交给冻结的执行模型(Worker)去跑。训练时常往导演的提示里塞一些“技能卡”(skill,写好的做题经验)帮它入门,但希望部署时不需要这些卡。
现有方法卡在哪(P.2): - 题库是人事先收集好的,课程(curriculum)不会随模型进步而变; - 用 GRPO(组相对策略优化:同一道题跑几次,比较好坏来学习)时,如果一组全对或全错,就没有学习信号,叫“优势坍塌”(advantage collapse);自我出题的方法在技能还在时挑题,技能一撤,这些题就变成全错; - 决定撤不撤技能时只看一个混了题目难度的成功率,噪声大,会误撤或该撤不撤。
方法
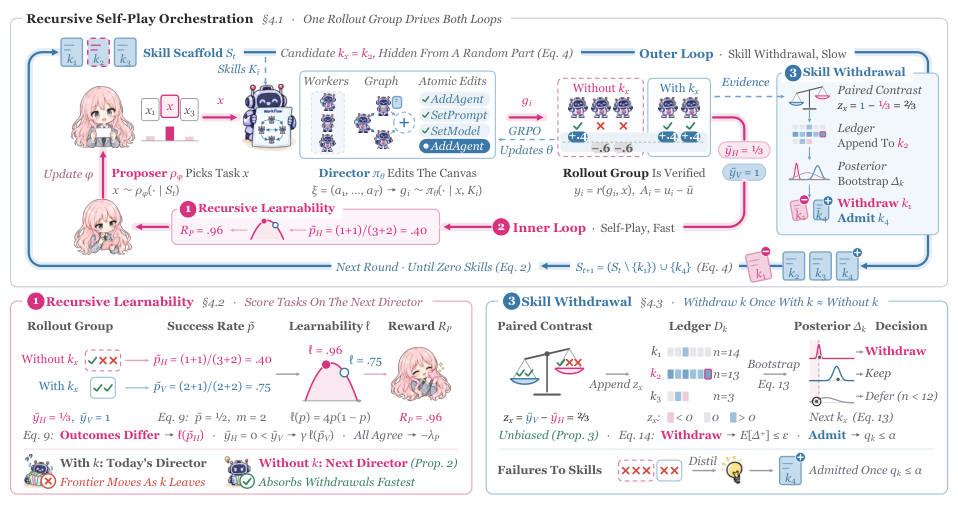
- 1出题出题者从候选任务里挑两道题
- 2搭图导演逐步编辑出多智能体图
- 3分组执行每题跑5次,其中3次藏掉一个技能
- 4双向打分藏技能那组有分歧就奖励出题者
- 5撤技能有无该技能差别的后验≈0就撤
- 6补技能两组都失败的案例提炼新技能
比喻:像教练带学生。教练(出题者 Proposer)专挑“把某张提示卡收走后,学生有时做对、有时做错”的题来练;同时每次练习都偷偷让一部分学生不看那张卡,比一比看卡和不看卡的成绩,差不多了就把卡收走。练到最后,学生不看任何卡也能做好。
模块一:递归可学性(Recursive Learnability,P.4-5)。一道题“值得练”的程度用 4p(1−p) 衡量,p 是成功率:p 在 0.5 附近时结果最分散、学习信号最多,p=0 或 1 时信号为零。关键改动是:p 用“藏掉待测技能”那部分 rollout 来算,也就是按“下一个、少一张卡的导演”来挑题,所以技能撤走后选中的题不会突然变成全错。这个分数直接用组里已有的 rollout 算,不需要额外采样。
模块二:技能撤销(Skill Withdrawal,P.5)。每组 5 次 rollout 里随机 3 次藏掉一个技能、2 次保留。两部分成功率之差 z 就是该技能效果的无偏估计(随机分组实验的经典做法)。把每个技能历次的 z 攒起来做 Bayesian bootstrap 后验:至少 12 条记录、且“技能仍有正收益”的后验期望 ≤ 0.02 时撤销;新提炼的技能只有在后验足够确定它有用时才被接纳。
两个循环:内层是出题者与导演的自我对弈(快),外层是技能库的撤与补(慢);外层每撤一张卡,就改变了内层挑题的目标。
实验
本文方法 对比方法 · 数据来源:Table 1(b), P.6
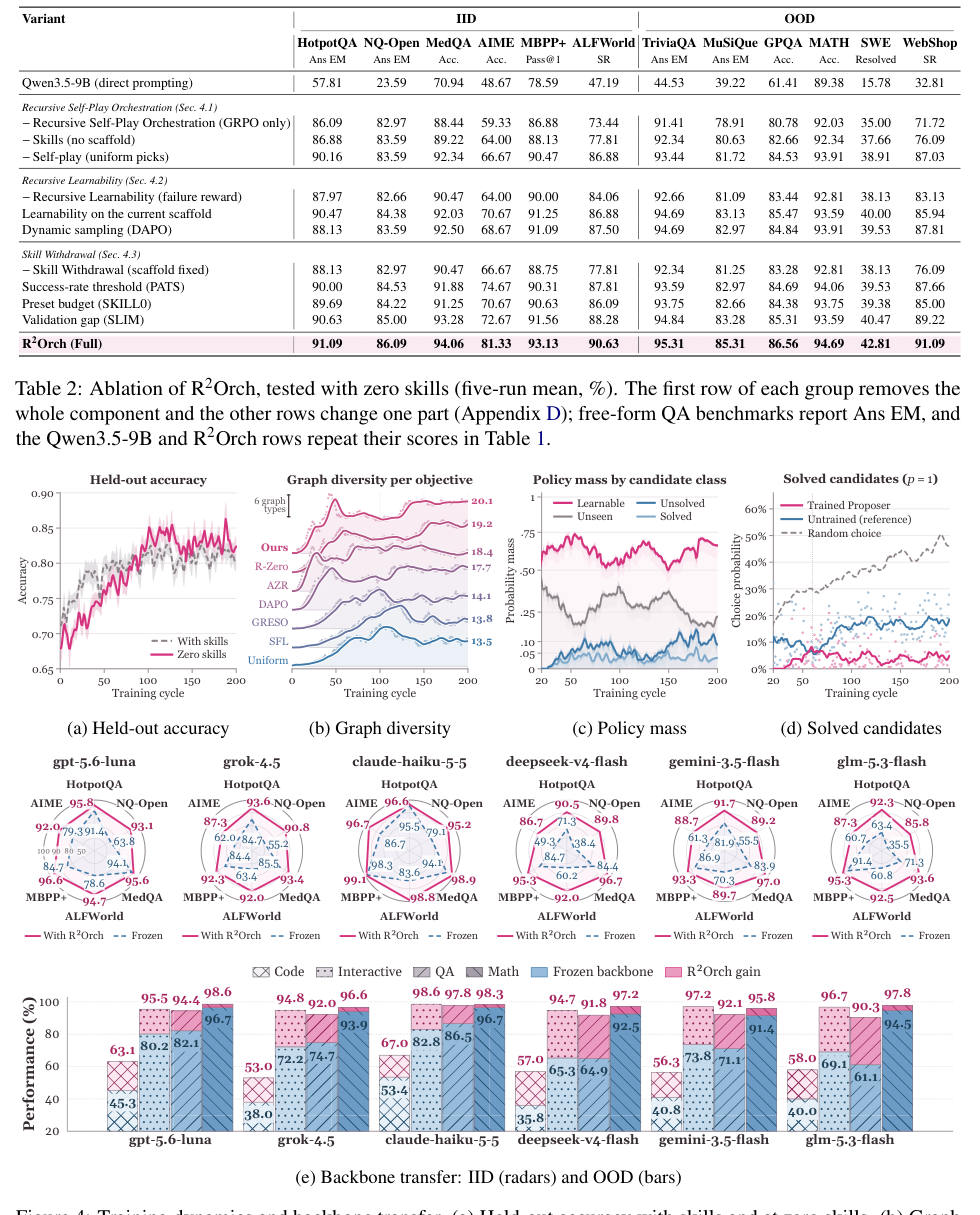
本文方法 对比方法 · 数据来源:Table 2, P.7
数据与指标:训练内(IID)6 个:HotpotQA、NQ-Open、MedQA、AIME 2026、MBPP+、ALFWorld;留出(OOD)6 个:TriviaQA、MuSiQue、GPQA、MATH-Hard、SWE-Bench、WebShop。指标是精确匹配 EM、准确率、Pass@1、成功率 SR、问题解决率,全部越高越好。每个测试集 128 题(AIME 30 题),报告 5 次运行均值(P.6 表 1,P.20)。
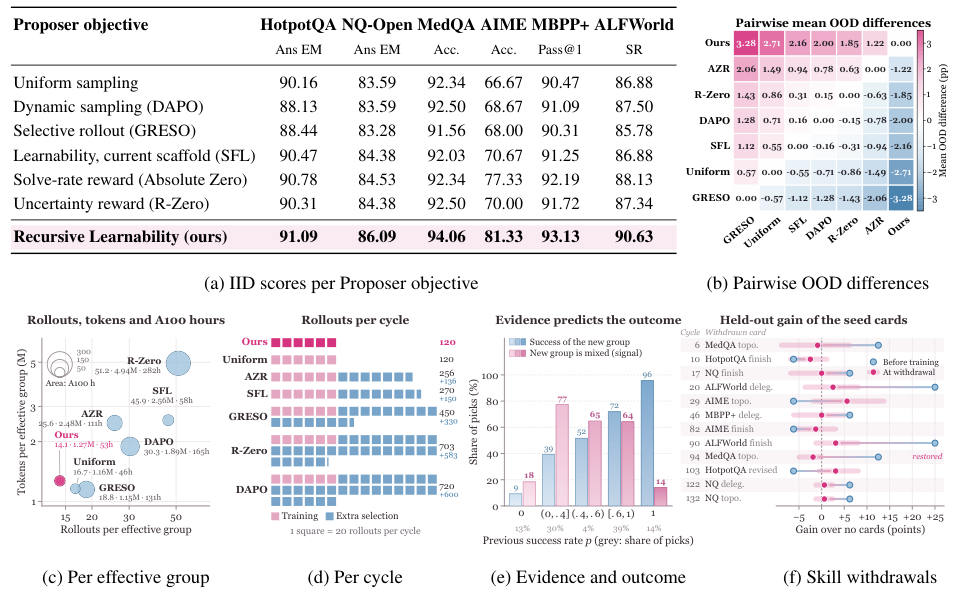
对比:直接提示(Qwen3.5-9B、DeepSeek-V4-Flash)、SFT、GRPO、工作流搜索 AFlow、RL 编排 AgentFlow/FlowSteer、技能内化 SKILL0/PATS、自我对弈加技能演化 SESA/MetaSkill;所有方法共用同样的冻结 Worker、训练题和算力预算,本文在零技能下测试。
结果:12 个基准都最好(P.6 表 1)。只训练骨干模型(SFT/GRPO)提升很小,说明增益主要来自“怎么组织 Worker”。最强对手 PATS 在 WebShop 为 87.97%,本文 91.09%。
站得住的结论(P.7 表 2,P.8 图 5): - 去掉任何一个组件都会掉分;用固定技能脚手架(不撤技能)在零技能测试时 ALFWorld 只有 77.81%,因为导演一直依赖那些卡; - 换成在“技能还在”时算可学性(SFL)或其他选题目标(DAPO、R-Zero、Absolute Zero),都不如本文; - 中等成功率的题产生“有对有错”组的频率约是 p=0 或 1 时的 4 倍(P.8 图 5e); - 12 次撤销都满足后验条件,撤销前后技能卡对留出集已无明显帮助(P.8 图 5f)。
迁移:用 Qwen3.5-9B 训出的导演不重训,直接换上 6 种其他 Worker 都有提升,IID 上各骨干间的差距从 25.7 点缩到 6.4 点(P.6,P.7 图 4e)。
代价:200 个训练周期约 106 A100 小时;选题不需额外 rollout,每个有效组只需 14.1 次 rollout,比 DAPO、R-Zero 等少(P.21,P.8 图 5c,d)。
要点 Take-home
- 同一组 rollout 随机藏掉一个技能,就能免费得到它是否还有用的对照证据
- 按“藏掉技能后结果仍有分歧”来挑题,训练信号最多,且不需额外采样
- 零技能测试下 ALFWorld 成功率 90.63%,技能固定不撤只有 77.81%
- 初始技能要按数据集手写,测试集各仅 128 题,小差距需谨慎看待
Claude 读完全文后的提炼。
更多:先读哪 · 值得看的理由 · 质疑
先读哪
先看第 4 页图 3(整体流程),再看第 7 页表 2(消融)
值得看的理由
- 同组随机隐藏技能的配对对照加 Bayesian bootstrap 后验,给“技能还有没有用”一个无偏、不需额外 rollout 的检验 → P.5 第 4.3, Eq. 11-14 节
- 消融逐一替换选题目标和撤技能规则(DAPO、SFL、成功率阈值等),零技能测试下完整方法在 12 列都最好 → P.7 表 2
质疑
- “递归自我改进”说法偏大:外层只按固定贝叶斯规则撤/改技能,改进机制本身并没有被学习或修改 → P.3 第 4.1 节
- 初始技能按数据集手写,每个测试集只有 128 题(AIME 仅 30 题),一两个点的差距落在抽样误差内 → P.20 App. D; Limitations P.9
审稿人笔记
与导航无直接关系,值得借鉴的是用随机对照决定“某个技能或提示改动是否保留”的评估方法。