Type 1 · Project-related Must-readRequested 证据 A 收录
Scaling Online Exploration for Robot Agents
发布 · 收录于 2026-11-02
让一个参数冻结的编程代理(coding agent)在机器人上反复试错,把成功做法写成带感知、规划和自检的 Python 程序并存入技能库,探索越多,在没见过的场景上表现越好,而且不需要任何动作示范。
- 任务
- 多形态机器人操作:单臂、双臂、灵巧手、移动操作、人形
- 数据
- RoboDojo、BEHAVIOR-1K、HumanoidArena、DexJoCo、LIBERO / LIBERO-Pro
- 硬件
- 真机 Franka FR3 机械臂 + Rainbow RB-Y1 移动操作机器人
- 代码
- 称开源整套框架,有项目页
- 主结果
- DexJoCo 平均 96.7%,最强已发表结果 65.3%
证据等级 A · 真机 + 多基准 + 消融 (A 真机 + 多基准 + 消融 / B 仿真充分 / C 单一基准或无代码)
动机
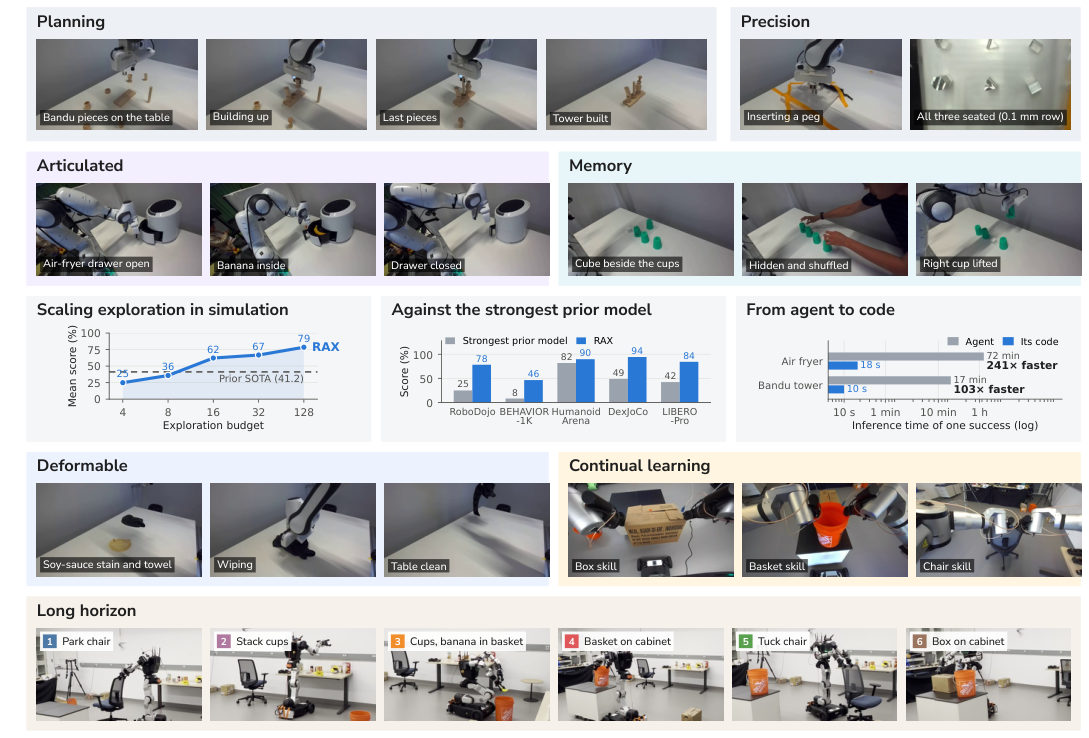
现在主流做法是收集大量遥操作示范,训练 VLA(视觉-语言-动作模型)或 WAM(世界-动作模型)。问题有两个:
- 换一台新机器人或新任务,就要重新采一批示范(P.5)。
- 策略只能模仿示范分布,物体换个位置就容易失败,也不会自己变好。
作者的问题是:机器人能不能像人练技能一样,靠自己在线试错来学会新任务?大语言模型代理在软件领域已经会「写代码-运行-看结果-改代码」,这篇把这套流程搬到真实机器人上。
方法
- 1读任务语言指令加几张完成图,无动作示范
- 2手动试代理通过工具调用直接控制机器人
- 3写程序把成功做法编成感知-规划-控制代码
- 4排练程序在新场景独立运行,失败就修
- 5存技能验证过的程序入技能库供后续组合
比喻:像一个新来的工程师调试一台陌生机器。先手动摸索,弄明白后写成脚本,脚本在新情况下跑不通就抛出「不确定」交还给人,修好后存进公司代码库,下次直接调用。
关键模块:
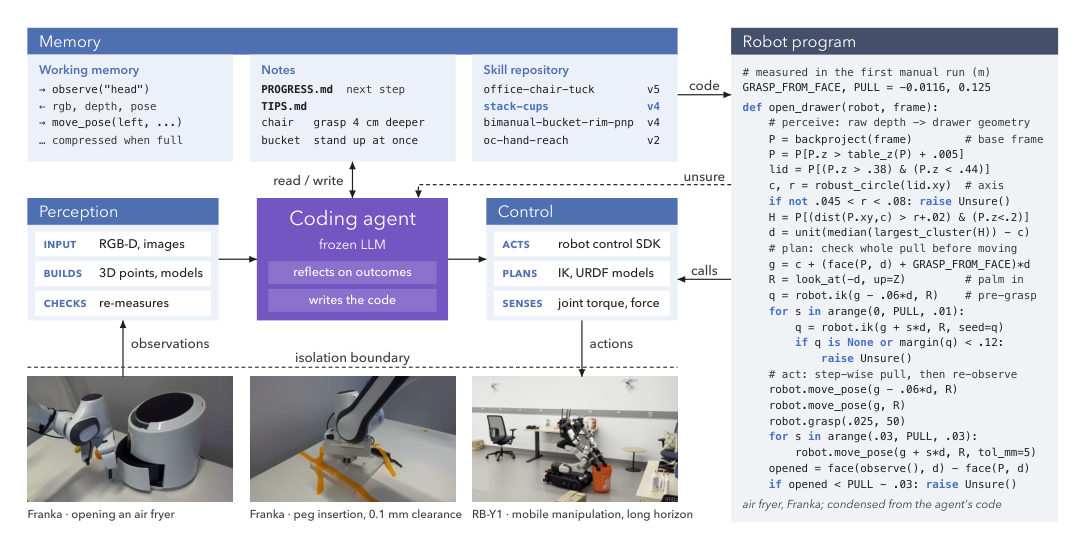
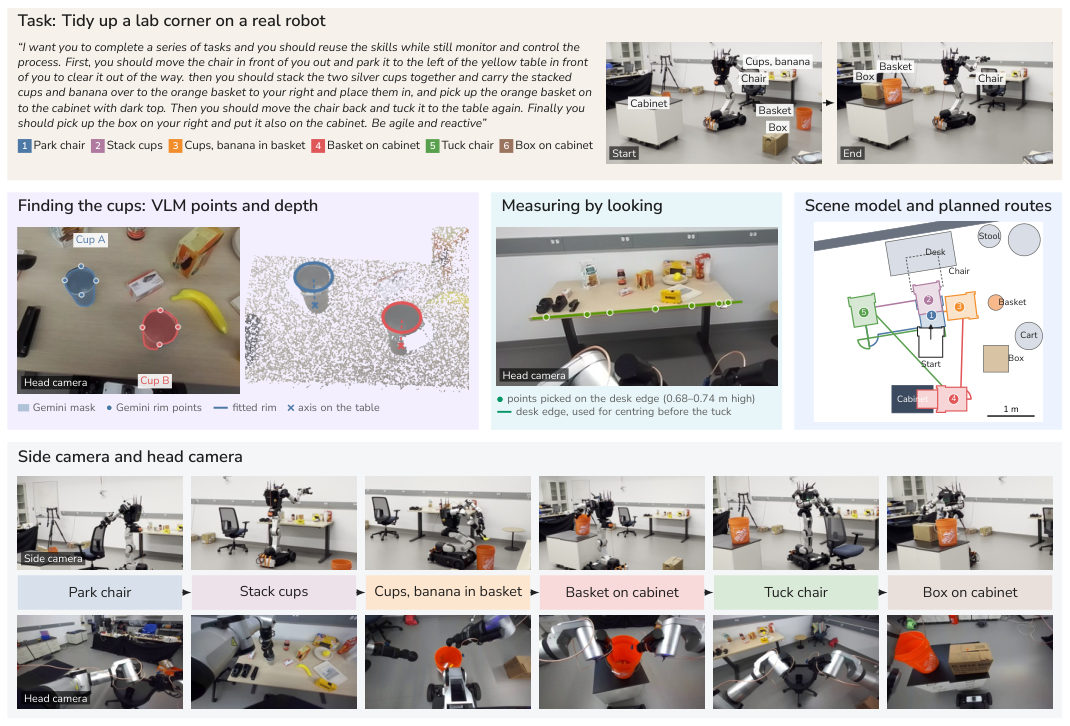
- 前后端分离(P.12-13)。后端是机器人自己的驱动、底层控制器和安全检查;前端是代理的工作区。两者只通过一组工具接口相连:观测、原始控制、正逆运动学(FK/IK,由关节角算末端位姿或反过来)、运动规划、像素转 3D 点等。代理写的程序调用的也是同一组工具,所以手动试过的代码能原样变成自动程序。新机器人只需写一个后端和接口说明。
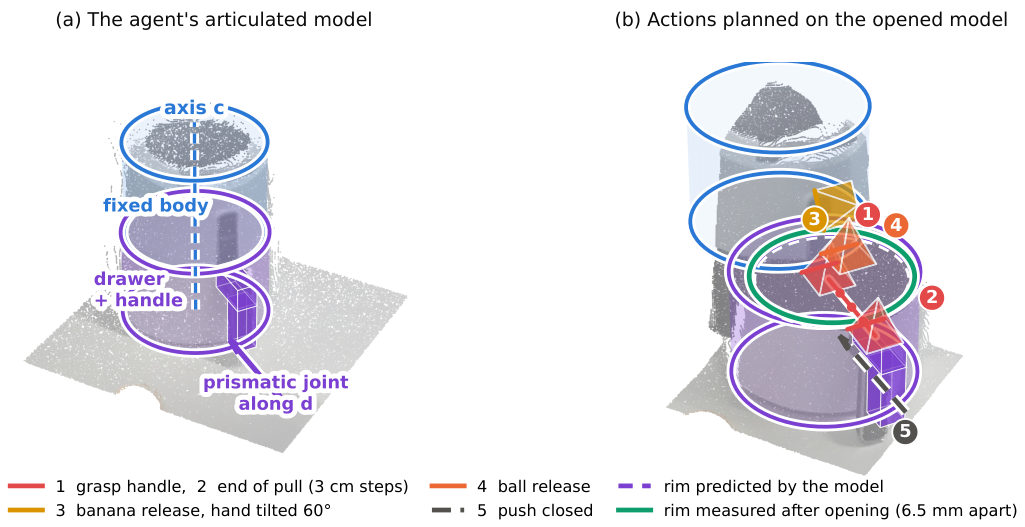
- 代理自己建 3D 模型(P.9-10)。代理会把 RGB-D 深度图反投影成点云,再用圆拟合、主轴分析等方法拼出物体模型。例如空气炸锅:固定机身 + 沿直线滑动的抽屉(棱柱关节,prismatic joint),然后在这个模型上规划每个动作并检查碰撞。这些做法没有人教,是探索中自己写出来的。
- 多时间尺度记忆(P.11)。会话内用笔记记录当前策略、失败原因和测得的参数;跨会话用带版本的技能库,每个技能附代码、前提条件和成功执行的证据,只有无人监督成功过才能入库。
大模型参数从不更新,「学习」全部体现在代码、笔记和技能库的变化上。
实验
本文方法 对比方法 · 数据来源:Table 6, P.22
本文方法 对比方法 · 数据来源:Table 5, P.21
本文方法 对比方法 · 数据来源:Table 8, P.23
指标:仿真用各基准官方的成功率或带部分分的得分(%),越高越好;BEHAVIOR-1K 用 Q-score(满足的目标条件比例,越高越好)。评测时程序在没见过的场景上独立运行,探索从不使用评测场景(P.38)。
主要结果:
- RoboDojo 七个任务平均 78.3%,排行榜最强策略 VPP2 为 24.9%(P.17 表 2)。
- HumanoidArena 人形机器人:只看 3 条示范,平均 89.8%;用 100 条示范微调的 WB-WAM 为 81.9%。去掉示范里的动作后仍有 81.9%(P.20 表 4,P.25 表 10)。
- DexJoCo 灵巧手:32 回合探索后平均 96.7%(P.21 表 5)。
- LIBERO 原版 98.5%,与 VPP2 的 98.8% 持平;差距主要在 LIBERO-Pro 扰动版(P.22 表 6)。
- BEHAVIOR-1K 平均 46.5,挑战赛最好条目 8.2,但评测口径不同,见下方评审意见(P.18 表 3)。
消融:去掉深度只用 RGB,三个随机化任务平均从 31.1 降到 13.8(P.23 表 8)。并行探索:Claude Code 用 4 个代理、4 个环境,4.9 小时得分 92.2;单代理 13.7 小时只有 63.3(P.22 表 7)。
代价:全文所有实验的模型 API 花费超过 10 万美元(P.77)。编译成程序后单次执行很快,真机空气炸锅从 72.3 分钟推理降到 18 秒(P.25 表 9)。
站得住的:「重新感知 + 显式几何」的程序在布局扰动下明显强于模仿策略。要打折的:与 VLA 比较时输入和工具不对等(RAX 有深度、IK、运动规划和 Gemini 调用),真机只是少量个案。
审稿人视角
这一部分是 Claude 读完全文后的看法和判断,不是论文自己的说法。
先读哪
先看第 1 页图 1 总览和第 9 页图 2 架构,再看第 21-22 页表 5、表 6,最后看第 40 页 C.4 的评测口径
值得看的理由
- 不用一条动作示范、不训练任何网络,冻结的编程代理在 DexJoCo 上平均成功率 96.7%,最强已发表结果 65.3%;探索预算从 2 增到 32 回合,平均从 31.9% 升到 96.7%,给出了「探索量-性能」的系统曲线。 → P.21 表 5
- LIBERO-Pro 位置扰动下,示范训练的 VLA 基本归零(OpenVLA、π0 为 0.0),RAX 不做适应就有 76.0%,最多 5 回合适应后 84.4%,说明「每回合重新感知的程序」比模仿策略更能迁移到新布局。 → P.22 表 6
- 把代理的逐步推理编译成程序后,真机空气炸锅任务的推理耗时从 72.3 分钟降到 18 秒,输出 token 从 262.4k 降到 2.0k;验证过的技能入库后可在 RB-Y1 上组合成六段长程整理任务。 → P.25 表 9;P.28 图 11
审稿人式质疑
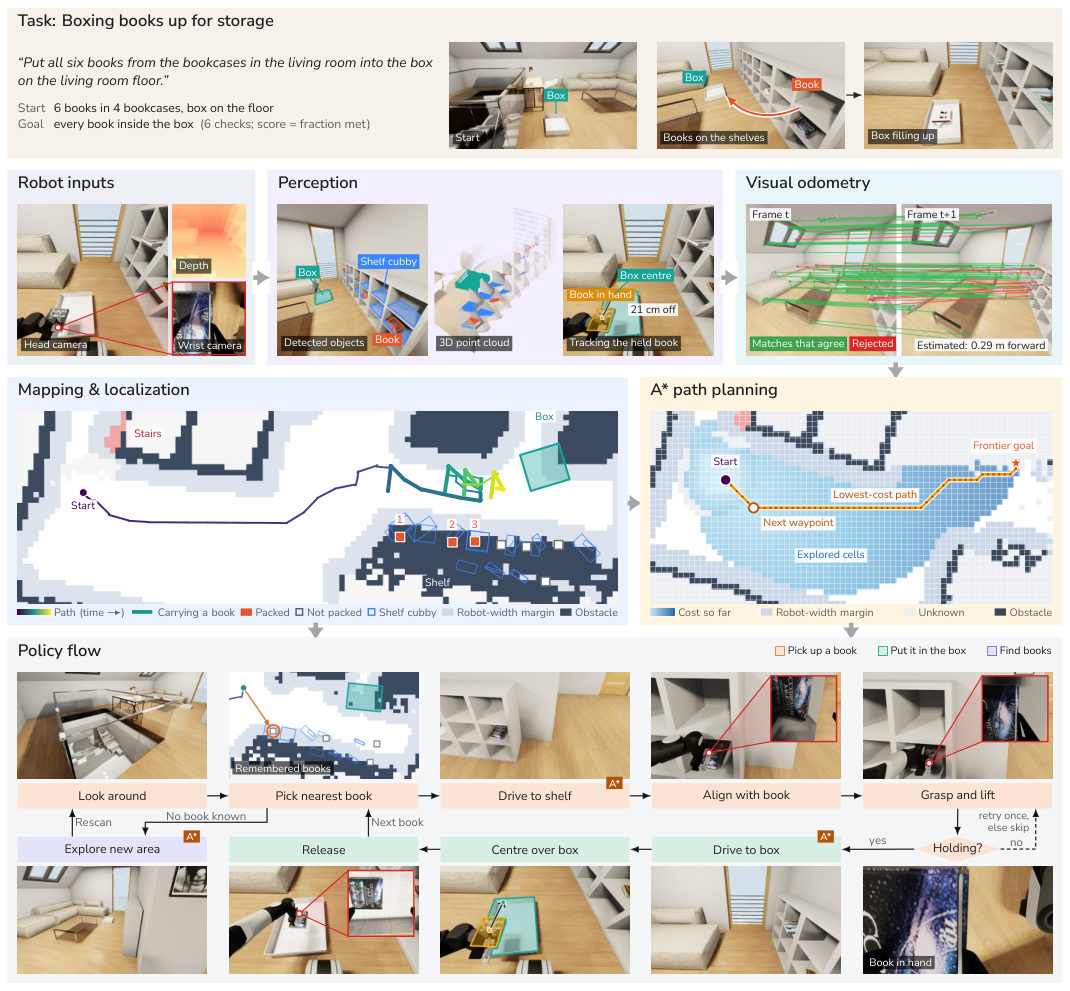
- BEHAVIOR-1K 的 46.5 分与挑战赛条目不同口径:六个任务中五个按「代理在环」评测,每个测试实例都有一份新的代理现场操作;其中三个任务的代理还拿到评审模型对另外九个测试实例运行结果写的报告,即测试集信息回流。只有 Boxing books(26.7)是纯程序。 → P.40 第 C.4, Table 14 节
- 真机部分是个案而非统计:RB-Y1 长程任务只跑 3 次且操作员在聊天中给建议(P.76);插孔任务从未运行无人值守程序(P.72);空气炸锅 9 次程序运行中 4 次是干净的无人值守成功(P.63);成功多由代理自己的测量判定。仿真每个任务每个预算只有一次会话(P.43 表 17),无方差。 → P.76 第 G.2-G.6 节
审稿人笔记
- 输入不对等:基线是用示范训练的策略;RAX 除深度外还拿到 IK、运动规划、像素转 3D、仿真里的「无场景预演」等工具,并可调用 Gemini 3.8 Flash(P.15 表 1,P.38 C.1)。比较的是「代理 + 工具」对「学习策略」,不是同一输入下的算法对比。
- 单次会话、曲线不单调:每个任务每个预算只跑一次(P.43 表 17)。DexJoCo Assembly 在预算 16 时 96.0,预算 32 反而 72.0(P.21 表 5);HumanoidArena P&PBox 预算 32 时 51.7,预算 64 时 46.7(P.20 表 4)。没有报告方差。
- 评测时序更宽松:DexJoCo 评测是同步的,模拟器等程序发动作才前进,没有推理延迟;官方客户端是异步的(P.42)。
- 摘要里的 +37.4 怎么算:五个基准各取一个对手再平均;DexJoCo 只算五个双臂任务,LIBERO-Pro 的对手取 VPP2(42.3)而不是 ASPIRE(63.2)(P.58 附录 F)。
- 成本:全部实验 API 花费超过 10 万美元(P.77);单个真机会话常持续数小时,例如空气炸锅 09:18 到 12:05(P.63)。