Type 1 · Directly applicable Requested 证据 B 收录
Do As I Can, Not As I Say: Grounding Language in Robotic Affordances
发布 · 收录于 2026-11-03
让大语言模型只在机器人会的技能里打分,再乘上每个技能在当前场景下能做成的概率,就能把抽象的长程指令变成真机可执行的计划。
- 任务
- 办公室厨房里的长程自然语言指令(取物、送物、扔垃圾)
- 硬件
- Everyday Robots 移动操作机器人:7 自由度单臂 + RGB 相机
- 数据
- 自建 101 条指令、7 类;实验室仿建厨房 + 真实办公室厨房
- 代码
- 有项目页;只开源了桌面仿真版 Colab,真机技能未开源
- 主结果
- 仿建厨房规划 84%、执行 74%;真实厨房 81% / 60%
证据等级 B · 仿真充分 (A 真机 + 多基准 + 消融 / B 仿真充分 / C 单一基准或无代码)
动机
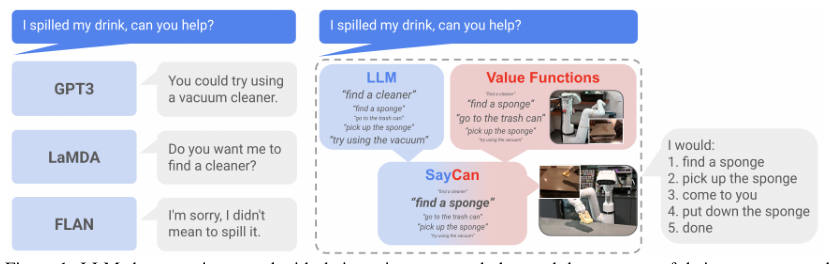
要解决什么:用户说「我把饮料洒了,能帮忙吗?」,机器人要自己拆成一串能做的动作。
现有方法卡在哪:大语言模型(LLM,读过海量文本的模型)懂常识,但没在真实世界里动过手。它可能回答「用吸尘器吸一下」,可现场没有吸尘器,机器人也不会用(P.2 图 1)。只靠提示词(prompt,给模型的示例和说明)能让它拆步骤,但它不知道机器人此刻能做什么、周围有什么(P.2)。
为什么难:语言知识和机器人的身体、当前场景是两套东西,需要一个桥把两者接起来。
方法
- 1听指令用户说一句高层指令
- 2LLM打分给每个技能描述打「有用」分
- 3可行性打分价值函数看当前画面打「能成」分
- 4相乘选最优两分相乘,执行最高的技能
- 5追加再循环把选中技能写进对话再问一轮
- 6done 结束选到 done 时停止
比喻:LLM 像一位读书很多、却从没进过这间厨房的顾问,它知道「洒了要拿海绵」;价值函数像站在现场的同事,看得见桌上有什么、手够不够得着。两人都点头的那个动作才去做。
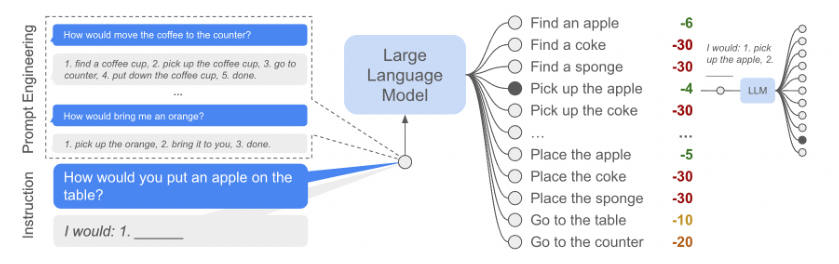
模块 1:只打分,不自由生成。论文不让 LLM 随便写回答,而是把机器人会的几百个技能描述(如「pick up the sponge」)逐个喂给它,算出每个描述作为下一步的概率 p(ℓ|i)(P.3-4,P.22 图 12)。这样输出一定落在机器人会的技能里。提示词里有 17 个示例对话(P.24-25)。
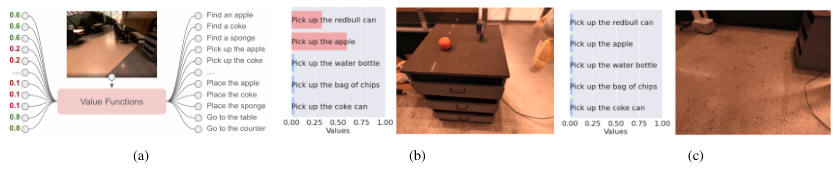
模块 2:价值函数当可行性。用强化学习(RL)训练语言条件的价值函数(value function,估计从当前状态出发能拿到多少奖励)。奖励设成「成功 1、失败 0」时,价值就等于「现在做这个技能能成功的概率」,即可行性(affordance)(P.3)。抓取用 RL 价值函数并做了归一化校准;导航按距离算;放下恒为 1;结束固定 0.1(P.24)。
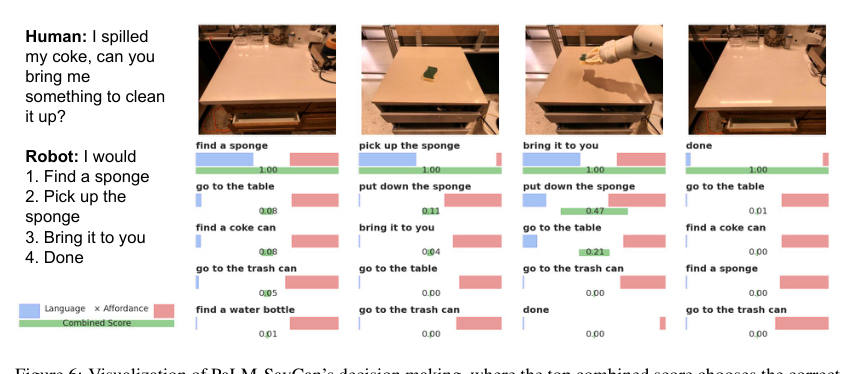
组合公式(用文字说一次):某个技能推进指令的概率 ∝ 它「能做成」的概率 × 它「对指令有用」的概率。每一步取乘积最大的技能执行,把它追加到对话里再算下一步,直到选到「done」(P.4-5,算法 1)。
实验
本文方法 对比方法 · 数据来源:Table 2, P.9
本文方法 对比方法 · 数据来源:Table 2, P.9
数据来源:Table 6, P.29
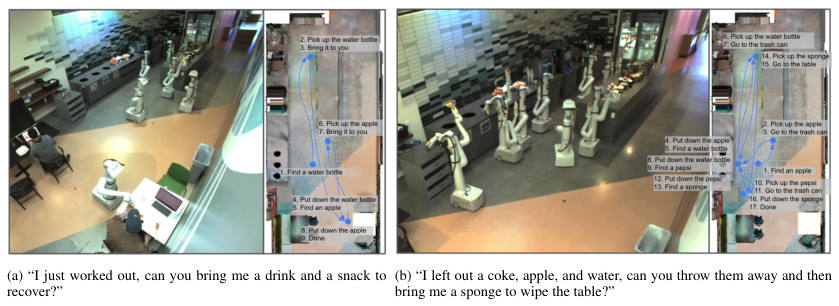
设置:101 条指令,分 7 类(单个动作、抽象名词、抽象动词、结构化语言、机器人状态变化、众包、长程),在实验室仿建厨房和真实办公室厨房各跑一遍;语言模型默认 PaLM 540B(P.6 表 1)。
指标(都越高越好):规划成功率(3 名评审中 2 人认为技能序列能完成指令)和执行成功率(3 名评审看真机执行,2 人认为完成)(P.7)。
主要结果:仿建厨房规划 84%、执行 74%;换到真实厨房规划 81%、执行 60%(P.9 表 2)。去掉可行性打分(No VF)规划 67%,先自由生成再投影到最近技能(Generative)74%;在「机器人状态变化」类上差距最大:64% 对 18%/36%。不用 LLM、直接把指令喂给底层策略(BC NL)执行 0%(P.9 表 2)。
语言模型越强越好:PaLM-SayCan 规划/执行 84%/74%,FLAN-SayCan 70%/61%(P.9 表 3)。只看生成规划时,PaLM 8B 38%、62B 72%、540B 74%(P.29 表 6)。
站得住的结论:可行性打分对「当前状态」类任务帮助最明显;失败中 65% 来自 LLM(常见是长程任务提前结束,也不擅长否定句),35% 来自可行性误判(P.8)。新增抽屉技能后 21 条指令规划 100%、执行只有 33%,瓶颈在底层操作(P.10)。
代价:RL 价值函数用 16 块 TPUv3 训练约 100 小时,另配 3000+3000 个 CPU 工作进程;模仿学习策略用了 10 台机器人 11 个月采集的 68000 条遥操作示范(P.20-21)。论文没报告每步决策的耗时。
要点 Take-home
- 让 LLM 只在机器人会的技能里打分,再乘上「能否做成」,计划才真正可执行。
- 加入可行性打分后规划成功率从 67% 升到 84%,状态变化类任务受益最大。
- 换更强的语言模型,机器人整体执行成功率也跟着涨(74% 对 61%)。
- 瓶颈在底层技能:抽屉任务规划全对,执行只有 33%。
Claude 读完全文后的提炼。
更多:先读哪 · 值得看的理由 · 质疑
先读哪
先看第 8 页图 6(两种分数怎么相乘选技能),再看第 9 页表 2(各类指令的成功率和消融)
值得看的理由
- 一个乘法把语言模型的「有用分」和价值函数的「能成分」合起来,去掉后者规划成功率从 84% 降到 67%,状态变化类任务从 64% 降到 18% → P.9 表 2
- 错误来源拆得清楚:65% 来自语言模型(多为提前结束),35% 来自可行性误判 → P.8 第 5.1 节
质疑
- 引言说接地后性能「接近翻倍」,但表 2 中无可行性基线的规划成功率是 67%/74%,SayCan 为 84%;这两个基线也只报规划、没上机执行 → P.2 第 1 对比 P.9 Table 2 节
- 导航技能假设物体位置已知,「find X」其实是查坐标后用经典规划器过去,找东西这一步没有被检验 → P.23 Appendix D.2
审稿人笔记
真机实验和消融扎实,但只有自建的 101 条指令和一套厨房布局,没有公开基准,故证据定为 B。